Borderlands: Анатомия провала
3 поста
3 поста
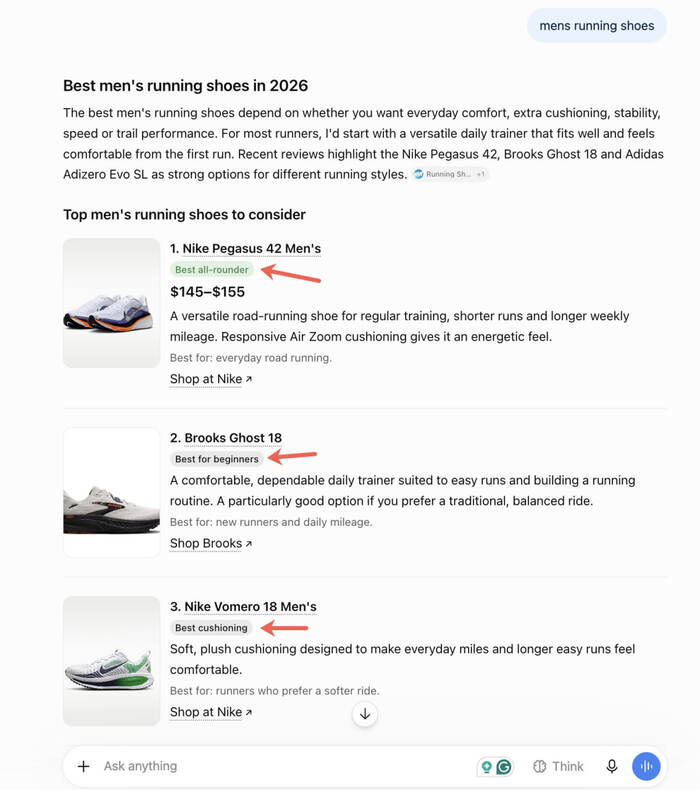
Представьте: вы спрашиваете у ChatGPT, какие кроссовки купить, а он не просто вываливает список, а подсвечивает один вариант зелёной плашкой "лучший универсальный", а рядом аккуратно развешивает серые ярлыки — "лучший для новичков", "лучшая амортизация". Именно это и начали замечать пользователи. Первым находку поймал SEO-специалист Brodie Clark и выложил скриншот. Пока это органическая выдача, не реклама, но направление считывается сразу.
Товарная выдача с готовыми рекомендациями прямо в окне диалога. Я бы даже сказал — похоже на грядущую революцию в продвижении.
Почему это не то же самое, что реклама в поиске
Google годами пытался встроить в поиск торговый слой. Только у него был баннер, который все давно научились не замечать — глаз просто скользит мимо. А здесь плашка стоит внутри ответа, который человек читает, а не сканирует боковым зрением. И это уже не "вот такие бывают товары", а прямая рекомендация: вот этот — лучший для того-то. Разница огромная.
Если коротко — придётся поработать. Уже не получится говорить "наши кроссовки самые кроссовчатые, самые качественные, вообще классно". Придётся раскрыть превосходство продукта, и раскрыть его по-настоящему, с доказательствами: сравнения, исследования, рейтинги, отзывы ваших клиентов.
Потому что если вы пишете "самая прочная обувь", а в отзывах люди жалуются, что ботинки развалились в первый же сезон, — никакого продвижения в нейросетях вам не видать. Модель видит и ваши характеристики, и то, что говорят живые покупатели, и ловит нестыковку мгновенно.
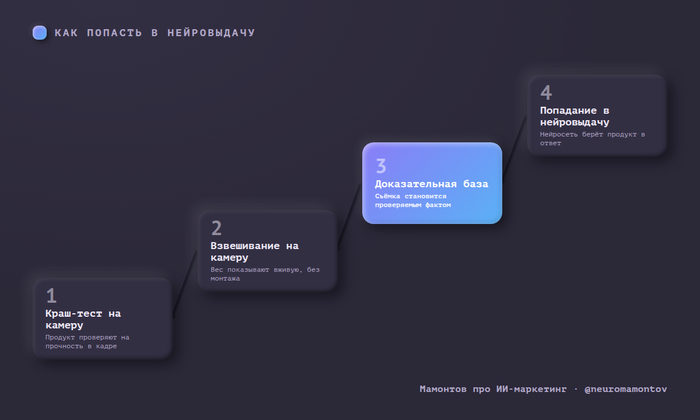
А работа-то, если честно, простая для тех, кто и так возится со своим продуктом. Есть товар — значит, можно сравнить его с конкурентами, провести краш-тест, взвесить, проверить на износостойкость и выложить видео или текстовый обзор. Это же не так сложно, если подумать. И это вообще копейки по сравнению с тем, что бизнес привык тратить на рекламу. Просто мало кто выделял на это деньги раньше — мало кто верил, что продвижение в нейросетях вообще заработает.
Потому что людям это удобно. Никто не хочет тратить 40 часов на выбор пары кроссовок, перебирая десятки и сотни вариантов на десятках сайтов. Человек хочет зайти в одно место, спросить и там же получить ответ. Вы только представьте: будущее наступило, и теперь, чтобы купить кроссовки, не надо становиться мировым экспертом в кроссовках. Достаточно сформулировать запрос, уточнить его в диалоге — и получить готовую рекомендацию, ровно так, как человеку всегда и хотелось.
И вот что тут важно понять. Это удобство не придумали маркетологи — оно было нужно людям всегда. Просто раньше его нечем было закрыть. Это как с навигатором: никто не ездит по бумажной карте, если в телефоне есть готовый маршрут. Один раз получив удобный ответ, назад к ручному перебору человек уже не возвращается.
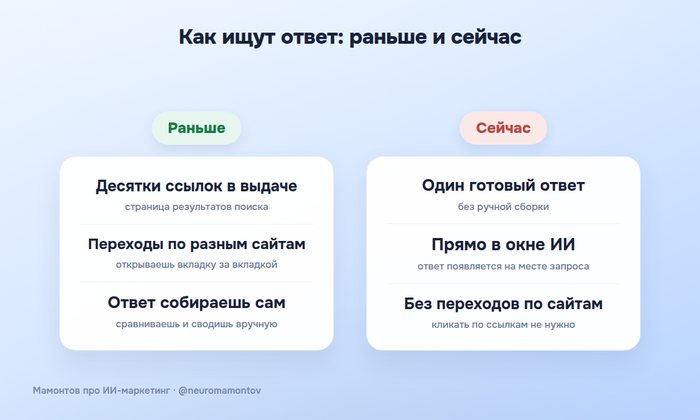
Обычный поиск так не умеет. По запросу "кроссовки для бега" в Яндексе или Google вы попадёте на страницу каталога с фильтром "для бега". А что внутри этого фильтра — решает вебмастер магазина. И каждый из нас сталкивался: открываешь "для бега", а там обувь, в которой бегать вообще нельзя почти никому. Это неудобство, это пустота, которая у покупателя так и остаётся. А нейросеть предлагает закрыть её сразу: хочешь для бега — вот пожалуйста; для повседневной носки — вот лучшее; а то сейчас как раз поздняя осень, собираетесь бегать зимой — посмотрите вот эти модели.
Многие компании до сих пор делают вид, что всего этого нет — будто если не замечать нейровыдачу и новую парадигму нейропоиска, проблема сама исчезнет. Не рассасываются. Наоборот, инструмент набирает обороты, и скрыться от него всё труднее. Скоро такие же подсказки появятся и в ответах Яндекса, и в AI-ответах Google — уверяю, очень быстро, если понравятся людям. А они понравятся. Поисковики подхватывают всё, что нравится пользователям, потому что иначе теряют аудиторию — она уходит в диалоговые модели. Так что с большой долей вероятности что-то похожее они уже у себя внедряют.
Самое интересное: когда формат приживётся, его легко расширить за пределы магазинов. С товарами проще всего — там много характеристик, есть что сравнивать. Но то же самое работает для чего угодно. Какой сервис выбрать, какую программу для учёта, какого подрядчика под конкретную задачу — у каждого своё сильное свойство, и под ваш запрос вы получаете точную рекомендацию.
Главный вывод простой: нейросети отсеивают тех, кому нечего сказать. Они ранжируют не по размеру рекламного бюджета, а по точности попадания в потребность — а точность как раз сильная сторона небольшого бизнеса. Крупные берут масштабом и ценой, а экспертность, персональный подход, узкая специализация — это поле остаётся свободным.
Поэтому задайте себе один честный вопрос: по какому одному критерию ИИ назовёт лучшими именно вас? Если ответа нет — значит, вы пока сами не определились, чем вы лучше, и алгоритм это почувствует раньше вас. А дальше всё решаемо: показывайте ценность продукта честно и по делу. Для того, кто действительно работает со своим товаром, это проще и дешевле любой рекламы.
Я подробно веду эту тему в своём канале — если интересно, как устроено продвижение в нейросетях на практике, заглядывайте, там та же мысль с примерами и цифрами.
Google обновил официальный документ по работе с ИИ-контентом в поиске — и на этот раз сформулировал критические требования без полутонов: ручная проверка фактов и редактура перед публикацией теперь не "было бы неплохо", а обязательное условие. Последний раз этот документ трогали в октябре 2025-го, так что само обновление уже событие (Search Engine Roundtable, 2026). Параллельно 30 сентября активировалась вторая фаза сентябрьского спам-апдейта 2026, и аналитики уже вяжут её именно с некачественным ИИ-контентом.
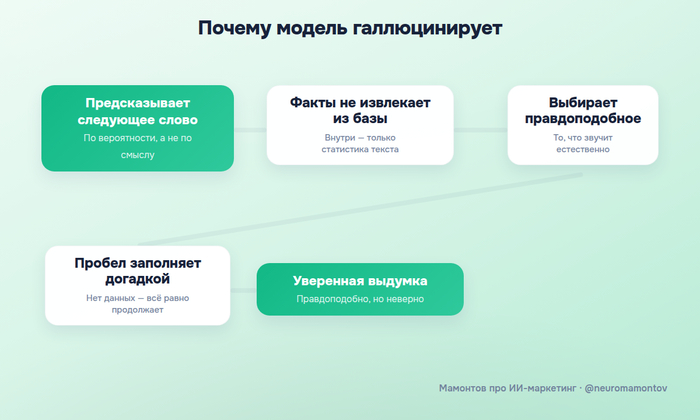
И Google впервые объяснил принципиальную причину. Нейросеть не извлекает факты — она предсказывает статистически вероятную последовательность слов на основе обучающих данных. Галлюцинации — не глюк, а архитектурная особенность: модель не "знает" ответ, она достраивает правдоподобное продолжение. Именно поэтому на выходе нужен человек — проверить то, что модель по своей природе проверить не может.
Ну самое забавное всегда в этих новостях с очередными рекомендациями от Google — это комментарии к ним. Подавляющее большинство про одно и то же: **Google со своими AI Overviews специально хочет заруинить обычную выдачу, как-то обрушить её**, чтобы пользователи пересели на диалог с нейронкой прямо в поиске. Дальше — людей подсаживать на инструменты и монетизировать под какую-нибудь подписную модель или крутить рекламу. Якобы Google так гораздо выгоднее и удобнее.
Доля правды здесь есть, и она про прозрачность. Классическую выдачу я могу проверить: беру ключевик, задаю регион и устройство — вижу, какая реклама крутится по мне и по конкурентам. А то, что происходит внутри диалога или в AI Overviews, никак не проверишь и не докажешь. Закрытая коробочка, чёрный ящик. У провайдеров тут, скажем так, полный карт-бланш: они могут показывать или не показывать кому захотят и кого захотят. Возьмут покажут по вашему брендовому запросу ваших конкурентов — и ничего не докажете. Захотят — покажут вашу рекламу по нецелевому запросу: торгуете сыром, а всплыли в диалоге про колбасу. Неприятно, и об этом не узнаешь, потому что то, что происходит в частном диалоге, остаётся частным.
Такую мотивацию можно притянуть к любой новости об обновлении со стороны любого провайдера. Но сам исходный постулат — что аудитория уходит в диалоговый поиск только потому, что Google его навязывает — он в корне неверен. Дело не в том, внедряет Google или нет, дело в том, что люди сами так хотят. Не добавь Google и Яндекс диалог к своим поисковикам, люди пользовались бы ими по старинке, но всё реже, и всё активнее уходили бы к чистым диалоговым моделям без собственного поиска: ChatGPT, Claude, DeepSeek. Просто потому что для целого ряда запросов диалог удобнее.
И как следствие — вебмастера свой трафик так и так потеряли бы. Сейчас потеряли, и очевидно что из-за "плохого нехорошего" Google, который эти свои ИИ-подсказки везде впихивает. А не будь их — аудитория Google упала бы просто потому, что ушла бы в диалоговые модели. Но и тогда можно было бы продолжать бухтеть, что плохой нехороший Google не подсуетился вовремя и не сделал шаг навстречу аудитории, чтобы её удержать. Ну вот он подсуетился и свои шаги навстречу сделал — и вебмастера как были недовольны, так и остались недовольны.
AI Overviews здесь такое же следствие более глобальной причины: аудитория больше не хочет перелопачивать уйму однотипного низкокачественного контента на таких же однотипных сайтах. Человеку нужен быстрый ответ — рецепт пасты болоньезе, нужно ли добавлять сахар в маринад — и для этого не нужна выдача из 7000 сайтов с 7000 рецептов маринада на каждом, достаточно один раз выдать простой усреднённый ответ. Потребность первична, инструмент идёт за ней.

Суть рекомендации к спам-апдейту: не злоупотреблять так называемым масштабируемым контентом — нейроконтентом, который создаётся слишком легко, с нулевой или совсем малой добавочной ценностью. По сути тот же призыв делать контент уникальнее — только метрика другая. Раньше уникальность мерилась механически: процент повторяемых слов и предложений, совпадение символ в символ. Теперь она смысловая.
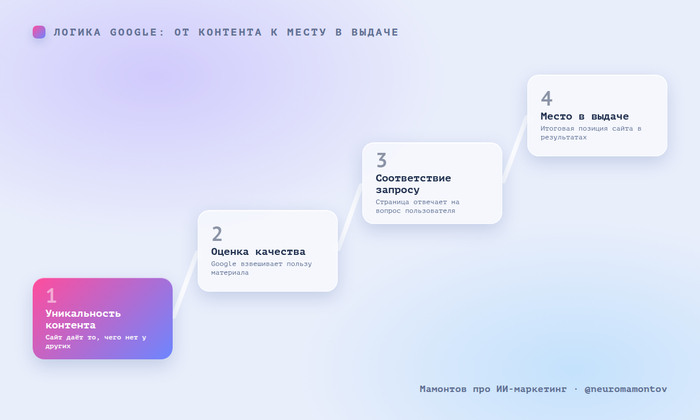
Логика очень конкретная: сайт, который занимается генерацией быстромасштабируемого низкокачественного контента, с большой долей вероятности не создаёт пользы — ни в самом контенте, ни для посетителя. Информационный он или коммерческий — если смыслов не прибавляется и добавочной ценности не создаётся, значит сайту попросту нечего сказать. Ни для коммерческого запроса, ни для информационного. А если ему нечего добавить к тому, что уже есть в интернете — высоко в выдаче не окажется.
Обратная логика такая же понятная. У любой коммерческой организации, которая годами ведёт реальную хозяйственную деятельность, всегда есть что рассказать: опыт, наблюдения, наработки. Что ж тут далеко за примером ходить: моему агентству чуть меньше 10 лет, и у меня в черновиках сейчас больше 1400 заметок, по каждой из которых я мог бы написать статью или пост. И это только то, что накопилось буквально за последние год-полтора-два, как я эти заметки начал вести. Поработать с этим основательнее на дистанции нескольких лет — объём вырастет раза в три-четыре. А это только одна тематика и только один сайт одного агентства, хоть и входящего в топ-10 по России. Представьте, что таких тематик десятки, а сайтов, которые занимаются разным диджиталом, соответственно сотни — и каждый может генерировать по тысяче публикаций в месяц. Пищи для материалов очень много, и берётся она именно из человеческого опыта — того, чего у нейронки не может быть по определению. Вот это и есть новое определение качества.
Вебмастера продолжают, как бы, бухтеть на одни и те же темы, потому что в их представлении всё должно оставаться таким же, как прежде — чтобы они и дальше продолжали пилить свой низкокачественный контент. Неважно, с помощью инструментов быстрого масштабирования типа нейросетей или, как в эпоху до них, просто руками каких-то грошовых копирайтеров, которые рерайтили друг у друга одни и те же статьи по сто тысяч раз. А нам, потребителям, остаётся только сказать: слава богу, что эта эпоха наконец-то заканчивается.
Надо отдать должное: алгоритмы оценки того, насколько материал уникальный, авторский, насколько содержит ценность для целевой аудитории — пока не идеальны. Но при этом они очень здорово выросли в точности за относительно небольшой срок: какие-то 6-8 месяцев. Особенно заметно на контрасте с публичными ИИ-детекторами, которые работают откровенно слабо.
Буквально полгода назад я ради прикола прогонял через эти публичные детекторы разный контент, в том числе свои публикации, написанные полностью вручную ещё в 2018-2019 годах, задолго до эпохи повального увлечения нейросетями. И мне эти детекторы на голубом глазу мне абсолютно показывали от 78 до 99 процентов нейротекста. При том что элементарнейшая проверка могла бы показать: текст опубликован в 2018-м, когда моделей в таком открытом свободном использовании ещё не было. А я тут же, ради прикола, генерировал пару абзацев в какой-нибудь самой дешёвой модели типа GPT-3 на вольную тему и относил туда же — и получал от 20 до 5 процентов нейротекста.
Точность настолько низкая, что, сделав какой-нибудь генератор подкидывания монетки, он бы чаще скорее всего попадал.
Сейчас история работает совсем по-другому. Детекторы я давно не тестировал, но вижу не по ним, а по эффекту качественного контента на позиции сайта. Был проект, где несколько лет подрядчик нагенерировал нейроконтент, особо не стесняясь и не заморачиваясь на дело качеством. Стоит начать исправлять вот эти вот моменты — убирать этот контент и отдавать предпочтение своим уникальным материалам, опираясь на реальный кейс, на реальную фактуру именно этой компании, авторским статьям с опорой на речевой и экспертный профиль конкретного специалиста — позиции сразу на это откликнулись. Про сам подход с речевым профилем я подробно веду дневник разработки своего контент-движка, если хочется копнуть в механику.
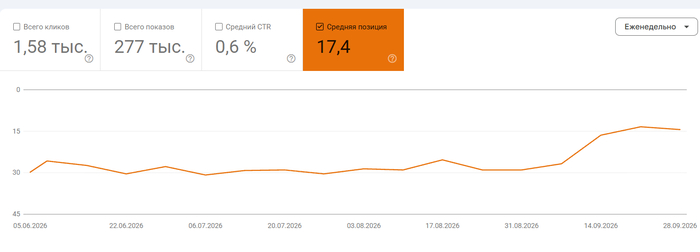
Правда, это очень объёмный пул работ, особенно когда на сайте несколько лет было нагенерировано несколько тысяч таких неуникальных текстов. Фактически с появлением спам-апдейтов от Google, где он стал наказывать за низкокачественный масштабируемый контент, для сайта это сработало как, ну, фильтр пессимизации. Позиции сайта просто методично падали полтора года, особенно заметно с начала этого года, когда спам-апдейты стали находить регулярно.
Как потребители мы, естественно, будем всё больше уходить в диалог, всё чаще взаимодействовать с поиском в формате переписки — это удобно, и это нормально. А как собственники бизнеса, маркетологи, вебмастера — те, кто в профессиональном смысле отвечает за продвижение, — мы в положении попроще: задача сделать это продвижение эффективным.
Рекомендация тут ровно одна: добавляйте ценность к своим публикациям. Делитесь наработками, опытом, надиктовывайте, да, как это делаю я, свои кейсы — потому что весь ваш многолетний опыт не заменит никакая нейронка, а от вас это потребует просто каких-то минут, чтобы высказать мнение по тому или иному вопросу. Своё мнение по этой новости я, например, высказал на 15 минутах голосовых надиктовок. Проверка фактов человеком, которую Google настойчиво рекомендует внедрять, — это не бюрократия, а ровно та добавочная ценность, которую модель не создаёт по своей природе.
Это заглавная статья моего дневника разработчика "Вайбкожу Статейник" на Пикабу. Я по частям собираю штуку, которая называется Статейник, и параллельно рассказываю, как именно собираю. Части выходят по мере того, как что-то доделывается или, наоборот, ломается. Эта статья — обновляемый навигатор по всему дневнику.
Если коротко: я семнадцать лет в маркетинге и всё это время хотел писать статьи, но одна экспертная статья — с реальным опытом внутри, а не рерайт — съедает у меня десять-двадцать часов. Писать самому дорого по времени, отдать некому: авторам проще сделать двадцать простеньких текстов, чем один экспертный.
Потом появились нейросети, и я, конечно, попробовал. Первые тексты вышли, грубо говоря, "на парафине": гладко, а внутри пусто — у ИИ нет ни моего опыта, ни мотивации давить на болезненную точку. Настройка "пиши, как я" сделала только хуже: появилась зловещая долина, ощущение что кто-то мимикрирует под меня. Вот из этих двух обжигов и вырос Статейник. Всю историю я подробно разобрал в нулевой части дневника.
Сначала я был уверен: вся задача в голосе. Научить машину говорить как эксперт — и дело сделано. Голос я более-менее приручил. А потом к Статейнику начали подключаться другие эксперты — и выяснилось, что голос это только половина дела. Причём, откровенно говоря, не самая трудная.
Эксперту есть что сказать: за плечами годы практики, кейсы, свой взгляд на профессию. Но когда он садится писать, упирается не в стиль, а в чистый лист: о чём писать? Кому это интересно? Не банально ли — "это же все знают"? И главное: а кто я такой, чтобы об этом писать?
"Боязнь чистого листа" и "синдром самозванца" в одном флаконе. Нейросеть от них не спасает, скорее наоборот: попросишь её "напиши статью про мой опыт" — получишь гладкий текст, в котором вашего опыта нет, и ощущение самозванца только усилится, потому что текст не ваш, и вы это видите.
Я много лет работаю в маркетинге, помогаю компаниям раскрывать ценность своего продукта, и по опыту знаю, что это никогда не простая задача: чтобы вытащить "смыслы" из головы собственника нужно полтора-два часа плотного интервью. Но ключевое здесь другое: по опыту я точно знаю, что эта ценность у каждого есть, и вопрос лишь в том, как до неё добраться.
Я давно повторяю: нейросети шикарно задают форму вашему содержанию, но над содержанием должны работать вы. Статейник в итоге построен ровно вокруг этой мысли: форму он берёт на себя, а содержание достаёт из вас — вопросами, базу для которых я годами собирал на живых интервью.
Три слоя:
Голос — речевой профиль
Тон оф войс — лишь одна из его граней. Профиль — это как вы объясняете сложное (я, например, ловлю себя на том, что тащу бытовые образы вместо терминов), через что заходите в тему, насколько осторожны в цифрах и так далее. Он собирается из вашей живой речи и дообучается на ваших правках.
Экспертность — нейрокарта
Голос отвечает за то, как вы говорите. Нейрокарта — это то, что вы думаете. То есть это карта ваших позиций: от ядра, на котором держится всё остальное, до узких выводов под конкретную тему. Собирается она из ваших же слов, и в каждый текст идёт та позиция, которая ближе всего к теме, а не весь набор подряд.
Здесь у меня самое строгое правило во всём Статейнике. Факт, в котором есть сомнение, можно перепроверить по источнику и публиковать. Позицию, в которой есть сомнение, не публикуем вообще, пока эксперт сам её не подтвердил: ни смягчить, ни дать с оговоркой. Неверную цифру читатель рано или поздно поймает. А мнение, которого у вас нет, будет жить под вашим именем.
Раскрытие и поддержка
Третий слой — то, ради чего, собственно, я и переписал эту карту. Про него подробнее.
Как Статейник помогает начать
Вместо пустой страницы — разговор. Писать ничего не нужно. Бот сам приходит раз в несколько дней примерно с таким сообщением: "Поделитесь любым профессиональным наблюдением или кейсом — недавним или не очень. Или ответьте на любой из вопросов" — и дальше три вопроса. Отвечать можно голосом, на ходу, как рассказали бы коллеге. Вопросы вырастают из того, что вы уже рассказали: бот цепляется за деталь, упомянутую мимоходом, и просит развернуть. Так всплывают и старые кейсы, о которых сам человек как о материале и не подумал бы.
Темы — из ваших же слов. Из разговоров бот собирает ленту тем. Каждая тема — это то, что вы уже сказали и что можно развернуть в публикацию. Свежее наверху, ненужное — в корзину, интересное — в работу.
Один вопрос вместо анкеты. Когда тема взята в работу, а материала маловато, бот задаёт один уточняющий вопрос с вариантами ответа. Добавить нечего — нажимаете "Собрать текст", и он соберёт из того, что есть.
Объём — по материалу. Сказали много — выйдет полноценная статья. Сказали немного — выйдет короткая заметка, без воды. По большому счёту, хуже пустой страницы только статья, по которой видно, что эксперту нечего сказать.
Против синдрома самозванца — разбор. Первое, что получает новый эксперт, — разбор своего профиля: какие сильные стороны есть в его речи и чем его позиция интересна читателю. Сердцевина разбора — таблица из двух колонок: слева то, как эту мысль сказал бы безликий текст, справа — как сказали вы. На этой таблице хорошо видно то, чего человек в себе обычно не замечает.
Ничего не выдумывает за вас. Любая деталь в тексте — пример, цифра, история клиента — берётся только из ваших слов. Если бот задал вопрос, а вы на него не ответили, модель, которая пишет текст, этого вопроса даже не увидит: отвечать за вас ей просто не на что.
Здесь только то, что прошло насквозь — отработало от начала до конца на живых экспертах, включая меня самого.
Разговор — тема — текст. Надиктовал в разговоре — тема появилась в ленте — взял в работу — получил текст.
Один разговор — несколько публикаций. Из одной темы собираются статья, отдельная версия для Дзена, пост в телеграм-канал и пост для Threads. Голос держится во всех версиях, а не только в основной.
Пост — сразу в ваш канал. Готовый пост приходит на согласование. "Согласовано" — и он в канале. Можно поправить текстом или голосом, приложить картинку. Без вашего нажатия не выходит ничего. Последний пост в моём собственном канале прошёл именно этим путём: голосовое — тема — пост.
Статьи — для публикации руками. Статью и её версии бот отдаёт файлами и страницей, которую удобно читать с телефона. Публикуете вы сами.
Учится на правках. Правки не пропадают: они копятся и возвращаются боту уроками, а живая речь из разговоров пополняет профиль.
Разбор профиля собирается сам. Но каждый разбор я пока смотрю глазами, прежде чем он уйдёт эксперту.
В работе: подтверждение позиций нейрокарты одной кнопкой и отметка вклада — бот скажет, сколько в тексте именно ваших слов. Без лести: не вложились — просто "принято".
Ещё одна вещь, которая сейчас в работе, — схемы внутри статьи. Одна и та же машина собирает статью со схемой под разного эксперта: рамка подачи одна, а форма схемы своя под нишу.
Картинки ниже — примеры, показываю форму, а не содержание: сами схемы намеренно пустые, подписи на месте, вместо данных — плейсхолдеры.
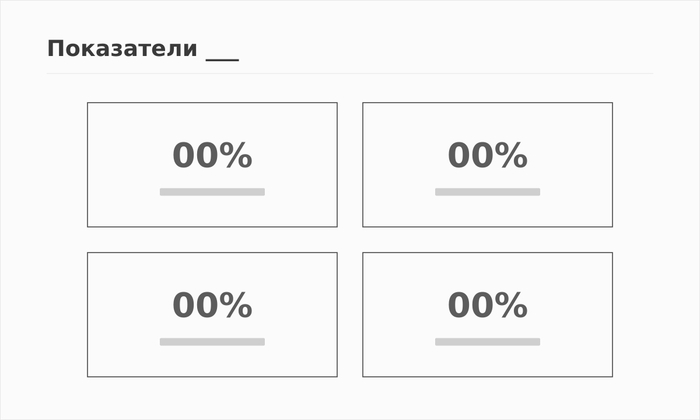
Схемы с инфографикой для публикаций: воронка, сравнение, пошаговый путь, сравнение показателей
Дневник для того и затеян, чтобы показать не только результат, но и грабли:
1. Статья одного размера на любую тему. Раньше каждая тема собиралась в статью одного объёма. На текстах первого эксперта всплыло, чем это кончается: материала на полный объём не хватало, и модель добирала его смежными темами. Одна такая статья читается нормально. Но если следующая повторит те же смежные темы, выйдет неловко — как будто эксперту нечего сказать. Фиксированный объём я убрал: размер теперь решает материал. Вопросы эксперту бот задаёт, чтобы раскрыть тему, а не чтобы дотянуть знаки.
2. Бот отвечал на свои же вопросы. У каждой темы есть вопрос-крючок — то, что хорошо бы раскрыть. В ранних прогонах эксперт по теме ничего не надиктовал, а модель увидела вопрос и ответила на него сама: гладко, правдоподобно и от его имени. Сначала я запретил это словами в задании, и модель вроде бы слушалась. Но "вроде бы слушалась" — это намерение, а не гарантия. Теперь, если по теме нет ни одной надиктовки эксперта, вопрос в задание модели не попадает вовсе. Нельзя ответить на вопрос, которого не видел.
3. Кнопка "Писать" путала экспертов. После надиктовки под подтверждением стояли две кнопки: "Писать" и "Добавить ещё". Первый подключённый эксперт-психолог на "Писать" так и не нажала. Потом выяснилось, что она прочла кнопку как "от меня опять потребуют что-то надиктовывать, а сейчас некогда". Кнопка, которая должна была снимать с человека работу, выглядела как новая работа. Теперь правило для всех кнопок: кнопка называет, что сделает бот, — "Собрать текст", "Собрать пост". Для продукта, который должен снимать страх перед письмом, это оказалось, буквально, совсем не мелочью.
4. Один раз бот полчаса "думал" и не написал ни строчки. Он невольно унаследовал режим "максимальное мышление" и на боевом прогоне выдал десятки тысяч знаков размышлений — и ноль текста статьи, после чего упал по таймауту. То есть инструмент старался подумать получше там, где, по-хорошему, надо было просто взять и сделать. Вычистил лишнее окружение — заработало за минуту.
Список буду дополнять
Синтетическая демонстрация: Оба абзаца ниже написаны для показа механики. Это не чей-то реальный текст и не клиентский кейс, цифр из настоящих проектов тут нет — просто иллюстрация "до и после".
До (без речевого профиля):
Ведение экспертного блога является эффективным инструментом привлечения аудитории. Качественный контент повышает узнаваемость и формирует доверие к бренду. Однако создание такого контента требует значительных временных ресурсов, что часто становится барьером для экспертов.
После (тот же смысл, но живым голосом):
Смотрите, что происходит с блогом эксперта: все понимают, что его надо вести, и почти никто не ведёт. Причём упирается не в лень — упирается в то, что одна честная статья, не рерайт, а с реальным опытом внутри, съедает порядка десяти-двадцати часов. То есть выбор такой: либо вы неделю сидите над одним текстом, либо отдаёте его тому, кто напишет гладко, но, откровенно говоря, ни о чём. И вот эта развилка и есть, по большому счёту, вся проблема.
Второй абзац невозможно приписать никому другому: в нём есть вилка часов, разговорный заход "смотрите", оговорка "откровенно говоря" и живая развилка вместо ровного тезиса. Первый можно отдать любому эксперту в мире — и это как раз признак того, что его не стоит публиковать.
Дневник продолжается. Если хотите с самого начала — вот первые части:
Публичного доступа пока нет: экспертов я подключаю по одному, по приглашению, и первые шаги каждого смотрю сам. Если хотите попробовать — напишите мне в личку канала @neuromamontov
Как только будет готово интейк-интервью (для сбора профиля эксперта) и первичный разбор, сразу добавлю сюда ссылку (и опубликую анонс в тг-канал, само собой) с бесплатным пробным доступом.
Новость про Cloudflare перепостили, перевели и опубликовали все кому не лень, а прокомментировать почему-то никто не взялся. А тема-то важная. И, что интересно, совсем не новая.
Эти разговоры ходили ещё года полтора назад, задолго до нынешнего анонса. Тогда все носились с форматом llms.txt — файлик, которым сайт как бы просил обучающих ботов не лезть. Работал он, мягко говоря, никак. Но сам запрос был виден уже тогда: владельцы сайтов не в восторге от того, что нейронки съедают их контент и потом спокойно раздают его в своих ответах.
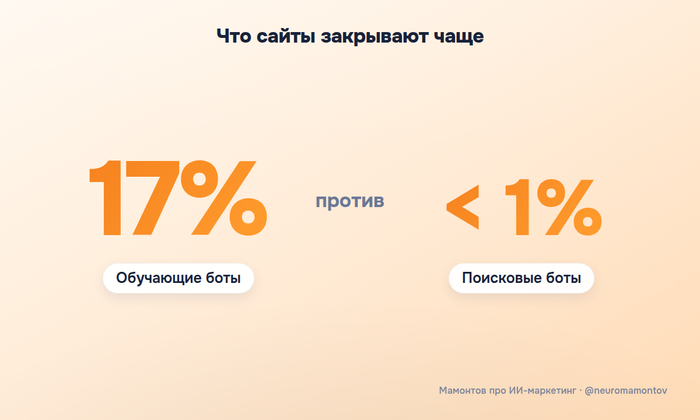
Одно дело — когда тебя проиндексировал поисковый бот и потом где-то процитировал: в обычной выдаче или в ИИ-ответе, но со ссылкой на твой сайт. Это дополнительный трафик. А трафик автору нужен как воздух, потому что вся монетизация живёт на сайте: реклама, подписки, свои продукты, нативка, партнёрские ссылки. Способов куча, но для любого нужен свой трафик на своей площадке. Поэтому поисковых ботов почти никто не блокирует — по оценке самого Cloudflare, меньше 1% сайтов.
Совсем другое дело — когда нейронка сожрала твой материал и вываливает всю фактуру, все выводы прямо у себя в окне. Может, тебя даже упомянет как автора. Но без ссылки. Без перехода. Просто "есть такое мнение". И всё, над чем ты пыжился-мурыжился — писал, собирал по крупицам многолетний опыт, чтобы поделиться с читателями и как-то на этом заработать, — модель отдаёт бесплатно. Задаром.
Вот отсюда и разница в цифрах. Поиск блокирует меньше 1% сайтов, а обучение — уже как минимум 17%. Далеко не все, конечно. Но это люди, которые очень захотели и нашли способ, а способы там неочевидные, на поверхности не лежат. И дальше это будет только расти.
Самое интересное: проблема все эти годы была не в сайтах, а в тех, кто делает нейросети.
Им-то как раз позарез нужно обучать модели на свежем человеческом тексте. Не будет живого материала — модель начинает тупеть, причём стремительно. И это уже видно невооружённым глазом: интернет заваливает нейроконтентом, и модели всё чаще жуют трижды пересказанные идеи. Змея кусает свой хвост.
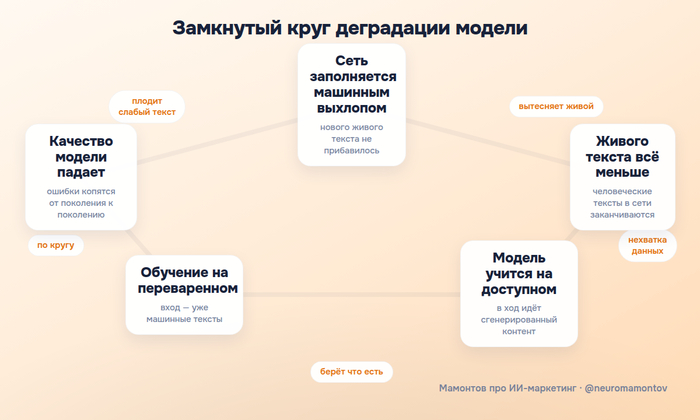
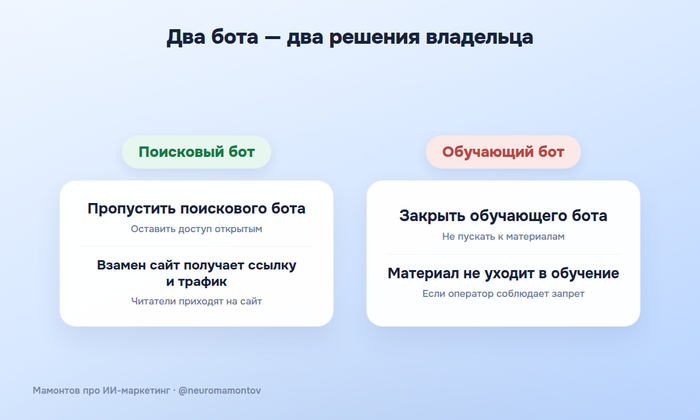
Получается забавный расклад. Одной рукой ИИ-компании хотят всё больше живого человеческого контента — иначе их модели деградируют. А другой рукой те же компании должны придумать, как успокоить владельцев сайтов: пустить поискового бота и не пустить обучающего. Тот самый llms.txt и должен был это разрулить, но не разрулил — половина провайдеров просто забила на его поддержку.
Cloudflare — это, на минуточку, больше 20% сайтов по всему миру. И он заявляет, что договорился с большинством крупных игроков: они теперь честно делят своих ботов на поисковых и обучающих и слушаются директив. Google и Apple под условия уже подходят, Microsoft обещает подтянуться в начале 2027-го. Для владельца сайта это выглядит как один переключатель: поиск оставляем, обучение закрываем.
И вот тут спрятана главная мысль. Cloudflare просто решил закрыть потребность, которая на рынке всё заметнее и будет только расти. Нейровыдача меняет уже не только то, как продвигаются, но и саму манеру, в которой люди ищут, — так что желание "в поиск пускать, а в обучение нет" будет только крепнуть. 17% против 1% — это не про технологию, это про спрос, который был всегда, просто до сих пор было нечем его закрыть.
Разделить ботов механически сами мы никогда не могли. Один и тот же бот заходит на сайт сразу с двумя задачами — и для поиска, и для обучения. Ни по названию бота, ни по IP их не растащишь. Значит, вся конструкция держится на честном слове операторов. Захотят соблюдать — будут. Не захотят — а кто проверит?
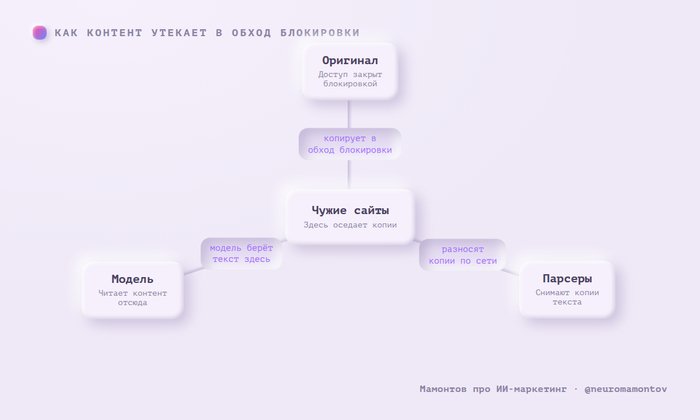
Но даже не это главное. Контент утягивают не только сами модели. Есть тьма парсеров, которые тупо копируют твой текст и бесплатно выкладывают у себя. Я как автор сталкиваюсь с этим постоянно: каждая публикация через день всплывает на трёх, пяти, десяти чужих сайтах. И вот вопрос — будут ли те сайты закрываться от обучающих ботов? Да с чего бы. То есть мой материал модель не возьмёт с моего сайта, зато спокойно возьмёт с чужого.
При этом сам разворот мне нравится. Недавно ведь была история, что Google начал платить издателям за использование их контента в ответах нейросетей — пока в тестовом режиме, но это по сути тот же разговор — рынок пытается нащупать баланс: без живого человеческого текста модели тупеют, а человеку должно быть выгодно этот текст отдавать.
Нейросети позарез нужен тот, кому есть что сказать. На пустом пересказе пересказа она "задыхается". В сухом остатке ценность остаётся у авторов, способных передавать смысл, опыт и фактуру, а не у контент-мельниц, которые штампуют пустоту.
Google придумал платить авторам и владельцам не за трафик на сайте, а за участие в нейровыдаче. Пока это закрытый тест на несколько десятков издателей, суммы там смешные, механика мутная, но сама идея интересная.
Приход нейроответов в поиске очень здорово ударил именно по владельцам информационных сайтов и авторам: по тем, кто делает свой, оригинальный контент.
Буквально за полгода-год, как эти ИИ-ответы набрали обороты, трафик на статьях и сайтах (которые некоторые мои вебмастера развивали по 10-15 лет и более) просел на 40% и более. Смотрите, что произошло: нейросети съели весь "вкусный" оригинальный контент, проглотили, забрали себе, а авторов просто "отодвинули плечом" от трафика. Там, где раньше были переходы, посещения, хоть какая-то копеечка с рекламы или размещений, — теперь заработок упал ровно пропорционально трафику.
Ну упал и упал — чо ныть. Раньше в интернете жили сотни, тысячи однотипных сайтов с рецептами, например. Сегодня человек, который спрашивает "омлет с молоком" — получает рецепт сразу, прямо в окне поиска, никуда не переходя. И, будем честны, это гораздо удобнее, чем перебирать 500 вариаций одного и того же блюда.
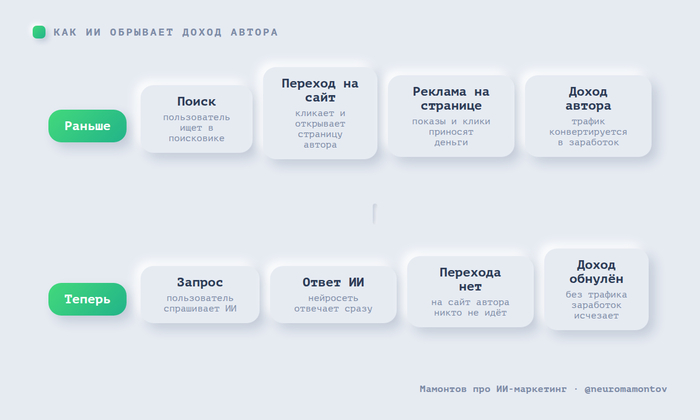
Обидно ли владельцам рецептных сайтов? Ну наверное обидно, там трафик просел на на 40%, а на все 80%+ — и это, конечно, больно вебмастерам. А стало ли хуже обычному пользователю интернета? Да нет, наоборот — стало сильно лучше.

Вот тут и проходит граница. С омлетом всё понятно: один нормальный рецепт закрывает вопрос раз и навсегда — для любого пользователя на любом языке по всему миру, ну добавим пару штук для микроволновки, для духовки, для аэрогриля (для совсем уж ценителей). А есть сферы, где так не выйдет — где потребность рынка одним ответом не закрыть: юристы, экономисты, врачи, маркетологи, психологи и т.д. Тут решает многолетний экспертный опыт, который специалист разворачивает живыми кейсами, — одним универсальным ответом не отделаешься.

Вот ключевая мысль, я её повторяю постоянно. У нейросети нет своего опыта. Она прекрасно собирает опыт, которым люди уже поделились в сети, но сама-то не может поработать юристом, экономистом или ещё каким консультантом и что-то там на практике понять. Чтобы её знания росли, нужно, чтобы живые люди продолжали делиться.
И получается смешная штука: роботам нужно, чтобы люди писали тексты — так им проще мимикрировать под нас, точнее нас изображать. А если авторы перестанут писать своими руками, знания нейросетей начнут быстро деградировать. Почему? Да потому что в интернете уже гора нейроконтента, и модели останется лишь учиться на "пересказе пересказа" — испорченный телефон в чистом виде. Так что на дистанции роботам выгоднее, чтобы мы не генерировали текст нейронкой, а сами садились и писали.

Короче: ИИ отсеивает тех, кому нечего сказать. Про омлет ответит сам. А где нужен живой опыт — там ему по-прежнему нужен живой человек.
Большие ИИ-конторы кормят свои модели по-разному. OpenAI, например, тупо покупает — заключает дорогущие многолетние соглашения с медиагигантами вроде News Corp. А Google пошёл путём похитрее.

У него есть то, чего почти ни у кого нет: он годами напрямую общается с владельцами сайтов, с обычными местными авторами, а не только с медиахолдингами. Эти люди сидят в Search Console — по большей части информационники с оригинальным контентом. И Google смекнул: а что если начать им доплачивать за этот самый оригинальный контент? Причём изобретать ничего не пришлось — механика выплат авторам у него давно есть. Это тот же AdSense для сайтов, тот же YouTube. Взял готовый инструмент и слепил из него новый способ мотивации — как бы заставить человеков и дальше писать оригинальные тексты.

Теперь про честность. Система расчёта вознаграждения непрозрачная настолько, насколько это вообще возможно. Заранее не угадаешь даже примерно, сколько дадут за одну статью — а раз так, то и работу под это спланировать нельзя. Условие одно: контент должен существенно повлиять на ответ. Просто ссылка или подтверждение факта уже после генерации — денег не приносят.

Люди, которые уже потрогали это руками, говорят примерно одно: помимо того что чёрный ящик, так ещё и абсолютные копейки. Но это же проба, что будет дальше — не знает никто.
Не думаю, что в ближайшие год-два на этом кто-то построит полноценный бизнес и начнёт нормально зарабатывать. Хайпа, как когда-то с подключением AdSense, скорее всего не будет — ни у нас, ни где-либо ещё. Но история любопытная, и очень хотелось бы, чтобы Google выложил публичный результат теста.

Важна ведь не сумма. Важна логика, которую Google этим движением закрепляет: нейровыдача теперь основная выдача, а не приятное дополнение к ссылкам. Деньги переезжают туда, где контент формирует ответ ИИ, а не туда, где он просто проиндексирован.
Внимание людей переехало в ответ нейросети, значит, туда же едут и деньги. Кто пишет так, чтобы модели было что пересказать, — попадает в ответы. Кто по старинке долбит ключевые слова — работает на уходящую модель. Так что деньги от Google авторам — пока символический жест, но символ достаточно однозначный: платят за участие в нейроответе, а значит, хотят мотивировать авторов писать качественный оригинальный контент для нейроответов.
Продолжаю дневник о том, как строю себе ИИ-комбайн для статей. Нулевая часть — здесь: семнадцать лет ручного письма и почему из этого не родилась система. Сегодня — как родился мой речевой профиль.
Когда кто-то пишет за вас, вы сразу понимаете: текст написан не вами. Я это знал ещё по работе с копирайтерами: статья полностью собрана из моей фактуры, моих тезисов, моих акцентов — где подсветить инфографикой, где выделить жирным, где добавить контекстный акцент. Вроде как я совместно с копирайтером добивался этого совместно (итерациями, правками), а ощущения авторства не было. Даже публиковать такую статью от своего имени всегда было немного неловко.
Поэтому когда нейросети начали выдавать мне первые тексты, написанные совсем не моим языком, у меня, честно говоря, поначалу опустились руки: "ага, понятно, на выходе будем получать примерно то же, что с копирайтером, только хуже — копирайтеру хотя бы можно передать что-то интонационно в голосовом или на созвоне, а нейросети ты никак интонацию не передашь". Вера в связку "человек + нейросеть = хорошая статья" просела почти до нуля.
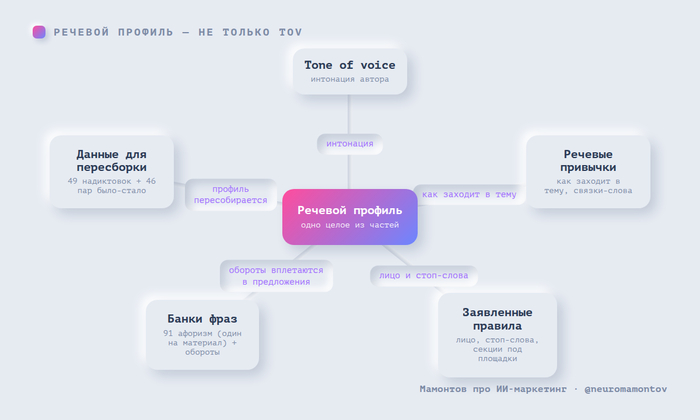
Почти — но не до нуля. Я решил протестировать напоследок: а что если задать нейросетке мой tone of voice? Тогда мне казалось, что дело именно в тоне голоса, это позже я понял, что речь пойдёт не только и не столько про ToV, а про речевой профиль в целом: он складывается из множества факторов, и ToV — лишь одна его грань.
Комментарий от иишки по содержанию речевого слоя на сервере:
Если открыть папку речевого профиля Вадима, ToV там — только один файл из многих. Рядом лежат:
• profile.md — речевые привычки, снятые с расшифровок: как автор заходит в тему ("через мысленный эксперимент с воображаемым читателем", "через определение-вопрос"), характерные связки дословно — "то есть", "грубо говоря", "вот это вот", усиление удвоением ("значительно значительно дешевле");
• rules.md — заявленные правила: лицо повествования ("я" — рассказчик, "мы" — только кейсы агентства), запрещённые слова и отдельные секции под каждую площадку;
• aphorisms.md — банк из 91 авторского афоризма: максимум один на материал, похожие не выдумывать;
• phrases.md — банк оборотов, вплетаемых внутрь предложений; corpus.jsonl — 49 крупных записей-сессий, из которых профиль пересобирается: счёт идёт материалами и сессиями, не отдельными голосовыми — ранние голосовые вплавлены прямо в profile.md;
• edits.jsonl — 46 пар "было → стало" из правок автора к живым публикациям — включая правки к нулевой и вот этой самой части: механизм пар молодой, исторические правки переплавлены сразу в правила.
Экспертный профиль — что автор знает и чем это подтверждает — отдельная сущность рядом, не внутри голоса.
И я взялся формировать этот речевой профиль — тогда ещё мало понимая, из чего он должен состоять. Начал с того, что попросил коллег собрать материалы, которые уже были в открытом доступе: статьи, видео, вебинары, уроки курсов. С важной оговоркой: статьи — только написанные мной, а не копирайтером; видео — только с живой речью, а не где я читаю курс с телесуфлёра. Получилось более 10 часов выступлений, видео и голосовых — не считая текстов написанных вручную статей.
И я, вооружившись главным принципом перфекциониста-прокрастинатора ("лучше сделаю безупречно, но никогда, чем кое-как, но сегодня"), начал прогонять тексты через этот профиль, пытаясь добиться ощущения своего текста.
Даже на этом материале текст получался лишь приблизительно похожим на меня. И появилось ощущение "зловещей долины": как будто кто-то мимикрирует под меня. Если вы когда-нибудь читали текст, частично похожий на вас, — он вызывает куда больше внутреннего дискомфорта и даже неприязни, чем текст, совсем на вас не похожий, где кто-то написал по вашим мыслям своими словами.
Заодно стало видно, как профиль вообще работает: не как принцип, который формирует текст изнутри, а как фильтр на выходе. Поверх уже сгенерированного материала он вторым проходом накладывает речевую оболочку — и накладывает туда, куда накладывается: огромные куски остаются без изменений. Задача — набрать такой объём правил и инструкций, чтобы непокрытых зон не оставалось вовсе, а покрытые правились глубоко, большими кусками.
И я решил добавить просторечия, живого разговорного языка. Для этого я набрал из тг расшифровки своих голосовых, причём брал те, где общаюсь преимущественно с близкими людьми: абсолютно свободный тон, абсолютно свободная речь. Скормил нейросети больше 150 личных голосовых — суммарно порядка пяти часов: приколы, ситуации, истории. Там было в числе прочего приличное количество, скажем так, нецензурной речи — и это тоже было переварено и адаптировано. Табличка адаптаций моей нецензурщины (заблюрил, чтобы дневник не получился 18+):
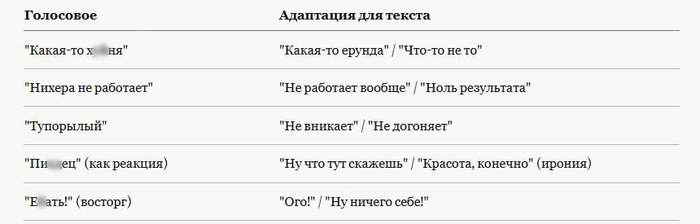
Благодаря голосовым, профиль обогатился значительно: текст стал напоминать человеческий, стал напоминать мой.
Правок всё равно оставалось много — потому что печатная мысль формулируется иначе, чем голосовая. Голосом мы говорим линейно: вернуться и отредактировать фрагмент нельзя. А печатный текст — особенно у нас, перфекционистов-прокрастинаторов — пишется нелинейно: дописал предложение, понял, что в конце нужен ещё один оборот, а для этого начало должно стоять в другой форме, — стёр и переписал целиком. Впрочем, что я по тексту взад-вперёд гуляю, было понятно ещё из нулевой части. К слову, далеко не все так делают: большинство и письменный текст формулирует линейно — наверняка встречали тексты, где человек по собственным мыслям как пьяный гуляет, из угла в угол, и взаимоисключающие тезисы в одном абзаце его не смущают.
Значит, профиль нужно было доучить тому, как я работаю именно с письменным текстом. Сесть писать с нуля и записывать мысли вслух? Попробовал пару абзацев — сумбур с прерывающимся контекстом, нейросеть он запутает моментально. И тогда пришла мысль: а что если не писать с нуля, а исправлять текст, который предлагает нейросеть?
Я создал несколько простейших статей про одну из любимейших моих игровых серий — Borderlands. Нейросеть, уже обученная на тех самых часах выступлений и голосовых, писала статью — а я садился переписывать за ней: убирал не те обороты, не те сокращения, так называемые "тики" — словечки и конструкции, которые нейросеть тащит из текста в текст в сотый раз. Про нашу борьбу с тиками — с примерами, эмоциями, отчаянием и в конечном итоге одержанной победой — расскажу как-нибудь отдельно: не забудьте подписаться! И прямо по тексту, в квадратных скобочках, тут же давал комментарий: почему убрал, почему из трёх коротких предложений нужно собрать одно длинное (я из тех, кто формулирует длинно, с большим количеством оборотов) и т.д. и т.д.
После такой доводки получились первые статьи, сгенерированные нейросетью, но по сути созданные мной — и выглядящие как мои. До идеала далеко, но это было в сотни раз лучше первых нейротекстов. Настолько лучше, что я сразу решил их опубликовать, хоть они и не были профессиональными. Просто доводка речевого профиля, сбор комментариев и мнений — спасибо всем, кто высказывался и высказывается в комментариях — у меня всё идёт "в копилку".

А из этих правок с комментариями родились пары "было — стало" и накопленные уроки — конкретные ответы на вопрос, почему вот так мы не пишем никогда, а вот такая формулировка предпочтительнее. Как правки превратились в постоянный механизм обучения — отдельная история, расскажу по ходу серии.
Открытие речевого профиля стало переломным моментом: я действительно поверил, что с нейросетью можно делать не пустой безликий нейрослоп, а интересные тексты. Чем больше обучался профиль, тем больше текст становился моим — и тем лучше он синергировал с материалом, который я выдавал нейросети.
Сразу оговорюсь: всё это происходило ещё без всяких ИИ-агентов, без автоматизации рабочего процесса, и все комментарии я просто давал текстом в диалоге с нейросетью. Но профиль был обучен на моём вербальном голосе: аудиосообщения, видео с выступлений, вебинары... И тут естественным образом родилась идея: а почему бы и сам материал для статьи, саму фактуру и тезисы не начать выдавать сразу надиктовками...
Это нулевая часть дневника о том, как я строил себе статейный комбайн из ИИ-ботов. Дальше будут боты, грабли и дословные цитаты из переписок с ИИ — а пока их нет. Пока есть только я, рутина и лёгкая зависть к людям, у которых "статья пишется за вечер".
Писать я всегда любил — вот честно. Первую статью накатал ещё в 2009-м, в фриланс-эпоху, про клиентский сервис: сижу, никого не трогаю, делюсь опытом. Семнадцать лет назад. С тех пор потребность рассказывать про свой опыт никуда не делась — а вот всё остальное усложнилось.
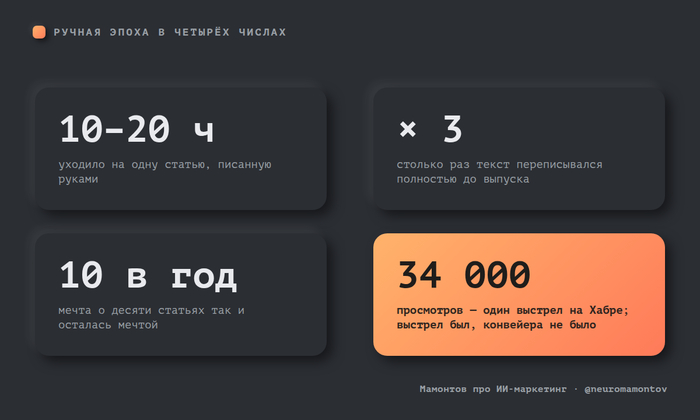
А потом появилось агентство. Сотрудники, проекты, сервисы, услуги — и написание статей стало роскошью. Одна статья — это часов десять-двадцать чистого времени, которые откладываются месяцами. И дело даже не в лени: внутренний перфекционист не позволял выпустить статью сырой, так что за время написания текст переписывался полностью раза три. Неумение поставить точку, когда сам видишь, что можно улучшить. Для читателя это, наверное, даже неплохо. Для пишущего — сплошное мучение.
Ну и самое обидное — гомеопатически малые охваты. Нет, бывали, конечно, "выстрелы" на 30+ тысяч просмотров, но именно системы из этого не рождалось: выстрел был, стабильности не было.
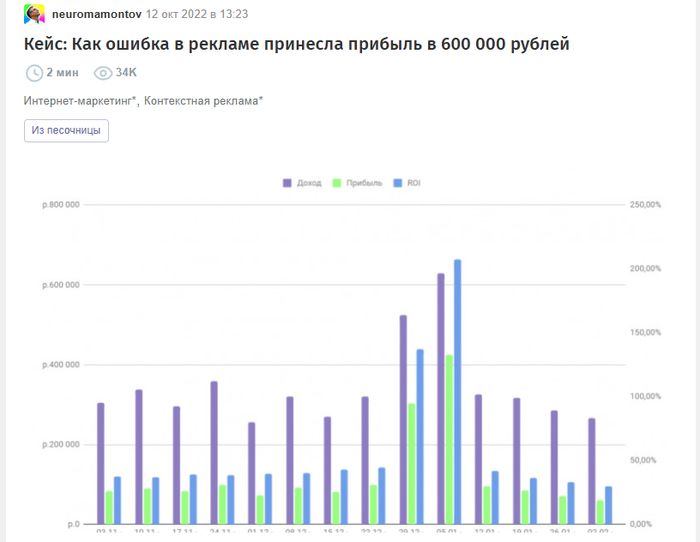
Мечта о десяти статьях в год оставалась несбыточной.
В какой-то момент я понял, что могу и хочу это делегировать. И делегировал — включал OBS, наводил на себя камеру, ставил флипчарт — и рассказывал будущую статью: тезисы, схемы, структура, всё прямо маркером на листе. Средняя запись занимала от 40 минут до полутора часов. Эту запись я отдавал копирайтерам. Из всех авторов готов отметить только одну — она действительно вытянула для меня много статей. Остальным, к сожалению, с таким материалом работать оказалось не по руке: большинству было проще сделать пятнадцать-двадцать примитивных рерайтов, чем один экспертный текст. Работа высокооплачиваемая, а качественного исполнителя — не найти.
Итог всех этих ухищрений: на стабильные десять статей в год я так и не вышел.
И тут из каждого чайника: нейросети, копирайтеры больше не нужны, контент-заводы штампуют десять тысяч статей в месяц. Ну я и повёлся — пошёл писать свою первую статью с ИИ.
Получалось посредственно. Я делился с ИИ опытом, эмоциями, наработками — а на выходе получал текст пустой, парафиновый: "это работает вот так, так делать надо, а так не надо". Ни реального опыта, ни болевых точек. Модели потом "подросли", контекста стало хватать — а текст всё равно сухой, как сухарь из армейского пайка.
Именно тогда до меня дошла одна вещь, которая изменила всё. Расскажу в следующей части — она про то, почему хорошая статья это не только "что написано". А пока вопрос к залу: у кого так же — мыслей вагон, а до текста они не доезжают?
Смотрите, что тут происходит. Google запустил новую штуку — кнопку "любимый источник". Заходишь на сайт издания, жмёшь — и говоришь поиску: показывай мне этот ресурс чаще. В выдаче, в ленте, в новостях. Называется всё это Preferred Sources: издатель встраивает у себя кнопку, ты по ней кликаешь — и сигналишь поиску, что хочешь видеть этот сайт чаще в выдаче, в разделе рекомендаций Discover и в Google News. Механику, кстати, раскатили ещё в мае в ИИ-режиме поиска, и там читатели уже успели добавить 345 тысяч уникальных источников. Подаётся всё как помощь издателям, у которых ИИ-ответы забирают трафик.

Звучит великодушно. А теперь основное правило диджитала, которое можно было запомнить ещё лет двадцать назад: любое активное действие, которое пользователь может совершить, будет накручено. Не "может быть". Обязательно.

Поражает, если честно, как Google — компания масштаба до монструозности, вроде бы всё про данные и алгоритмы знающая — раз за разом наступает на одни и те же грабли.
Вспомните, как это уже было. Google когда-то придумал ранжировать сайты по входящим ссылкам: раз на тебя ссылаются — значит, полезен. Логика красивая. И что мы получили? Целую эпоху ссылочной накрутки, которая к качеству для живого человека отношения не имела вообще. Ты, читатель, этих входящих ссылок в глаза не видишь. Тебе без разницы, сколько доменов ссылается на страницу, которую ты сейчас листаешь. Но действие-то активное — ссылку можно расставить руками. Значит, накрутили. И накрутили до состояния целой отдельной индустрии.
Так уже было со ссылками, с отзывами, с лайками и поведенческими. Отзывы можно оставлять вручную — накручиваются. Лайки, дизлайки, добавление в закладки, в избранное — всё, что человек проставляет своими руками, рано или поздно превращается в товар на бирже накрутки. Тут даже думать особо не надо, это закон природы для интернета.
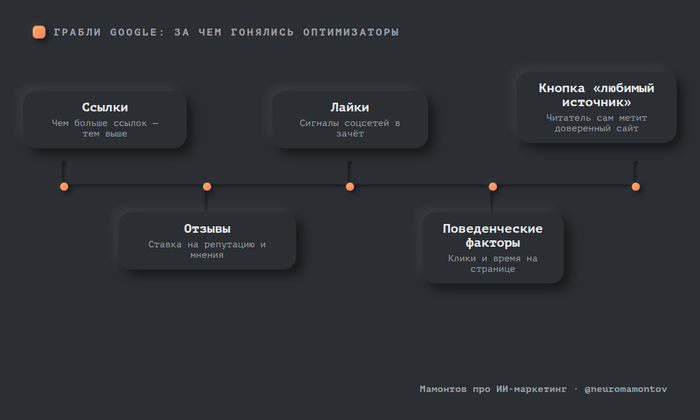
Таймлайн граблей Google: ссылки -> отзывы -> лайки -> поведенческие -> кнопка «любимый источник»
И вот что интересно: чтобы всё завертелось, эффект даже не обязателен. Достаточно, чтобы у владельцев сайтов возникло подозрение, что нажатие кнопки помогает. Одного суеверия хватит. Дальше оно превращается в городскую легенду: "эта штука работает, давайте все скорее жать". А потом подтягиваются бот-фермы.
Тут надо сказать пару слов про сеошников. Ребят, серьёзно — это народ суеверный до предела. Человек, который обходит стороной строительные леса и не идёт под аркой, по сравнению с типичным сеошником — образец холодного рационализма. Четверть века работы с чёрными ящиками поисковиков, где никогда толком не видно, что на что влияет, кого угодно превратит в суевера. Причинно-следственной связи не видно до конца никогда — ты дёргаешь рычаг и только гадаешь, оно сработало или само так сложилось. И вот эти люди, уже наловчившиеся крутить поведенческие через свои бот-фермы, первыми ринутся жать новую кнопочку. У них и инфраструктура под это готова, и рефлекс выработан.
Google, конечно, увидит, как красиво выросло число пользователей функции. Сейчас таких источников 345 тысяч — это смешные цифры для старта. На экспоненте в какой-то момент перевалит за десятки и сотни миллионов. И команда, которая всё это внедрила, пойдёт радостно отчитываться начальству: "Смотрите, работает, мы дали людям прямой рычаг влияния". То, что половина этого роста — боты, в презентацию как-то не попадёт. Оно и понятно: график вверх, все довольны, а что там под графиком — разбираться никто не будет.
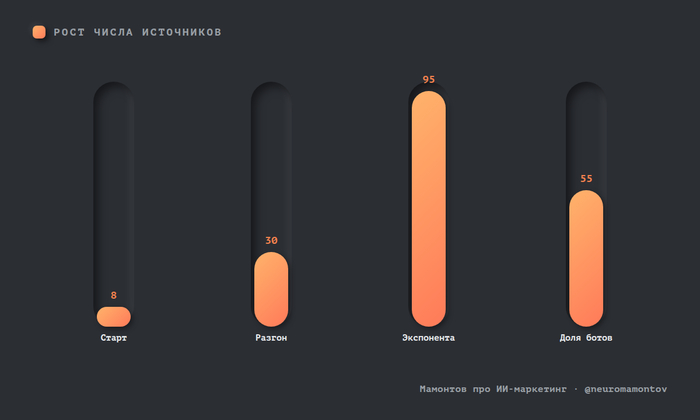
Диаграмма: рост числа выбранных источников от 345 тысяч к экспоненте, где заметную долю дают боты
Теперь про цифру, которой хвастаются: "такой читатель кликает вдвое чаще". Вот это надо читать очень аккуратно. Это вдвое от тех, кто уже пришёл и уже тебе доверяет, — а не вдвое больше трафика в принципе. То есть кнопка усиливает связь с теми, кто и так был твой.
По сути это метрика лояльной аудитории: человек, который сам нажал "хочу видеть вас чаще", и без всякой кнопки к тебе бы вернулся. Выиграет тот, кто умеет работать с лояльной аудиторией. А кто привык жить на холодном случайном трафике и надеется, что кнопка нальёт новых людей, — тот продолжит терять.
И вот тут проступает самое любопытное — то, ради чего вообще стоит смотреть на такие новости. Google подаёт кнопку как компенсацию за трафик, потерянный из-за ИИ-ответов. Но если приглядеться, это никакая не компенсация, а передача ответственности вниз по цепочке. Трафик у издателя забирают ИИ-ответы прямо в поиске — а взамен ему выдают кнопку "попроси читателя спасти тебя сам". Проблему не решили, её переложили на того, у кого и так меньше всего рычагов.
Но главное даже не это. Давайте на секунду поверим, что кнопка честная — влияет только на твои личные рекомендации и ничью чужую выдачу не трогает. Даже так это выглядит времянкой. За двадцать лет мы привыкли получать от поисковиков рекомендации без поправки на наши собственные предпочтения. И оказалось — это ровно то, что нам нужно.
Потому что потребность первична. Моё главное желание, когда я что-то ищу, — получить лучший ответ, а не тот сайт, который я сам себе заранее назначил. Хочу купить велосипед — покажи мне лучшие магазины велосипедов, а не те, что я когда-то сам отметил. Если я уже выбрал магазин, я на него и так зайду напрямую — зачем мне для этого поиск? Это коммерческий запрос, и с ним всё очевидно.
С чтением та же история, только тоньше. Допустим, я каждый день гуглю по работе, и в 99 случаях из 100 нормальный ответ мне даёт одна и та же площадка. Смысла принудительно её фиксировать нет — она и так почти всегда всплывёт. Но будет одна задача из ста, где именно на ней ответа не окажется, зато найдётся на другом сайте, или окажется там подробнее. И вот в этот момент я хочу, чтобы поиск отдал мне лучшее, а не то, что я сам себе прибил гвоздями. Ровно ради этого одного случая из ста поиск и нужен — а кнопка "любимый источник" ровно этот случай и убивает.
Поэтому прогноз простой. Функция плотно поработает на накрутчиков, а потом её тихо удалят — именно потому, что реальному живому человеку от неё пользы почти ноль. Тут, кстати, надо отдать Google должное: отказываться от неудачных фич они в последнее время научились быстро. Не за пять лет, как раньше, а за год-два. Так что просто ждём.