Серия «ИИ тренды»

3

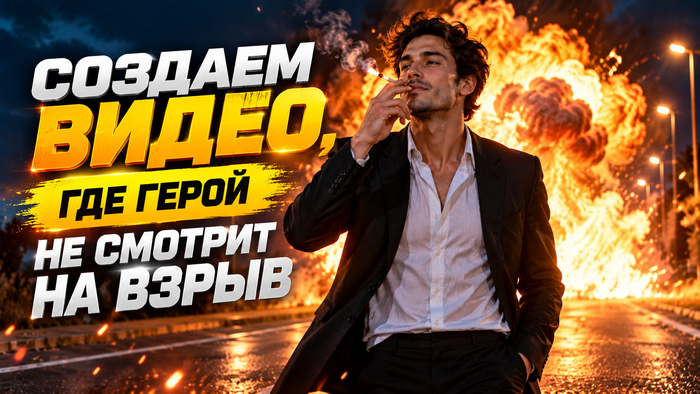
Как сделать видео, где герой спокойно уходит от взрыва и не оборачивается⁠⁠

Серия ИИ тренды

Ниже разберём, как подготовить персонажа, настроить генерацию и создать видео в Aigrator AI с помощью Seedance 2.5. В исходной инструкции для подготовки изображения используются Grok Imagine 2.0 или GPT Image 2, а для видео — Seedance 2.5. Вставленный текст

Что понадобится

Для работы достаточно:

  • фотографии человека;

  • доступа к Aigrator AI;

  • Grok Imagine 2.0 или GPT Image 2 для создания референса;

  • Seedance 2.5 для генерации финального видео.

Лучше брать фотографию, где лицо хорошо освещено, волосы не перекрывают основные черты, а внешность человека легко считывается.

Можно использовать исходное фото сразу. Но если хочется повысить стабильность внешности в видео, лучше сначала подготовить полноценную карту персонажа.


Шаг 1. Создаём карту персонажа
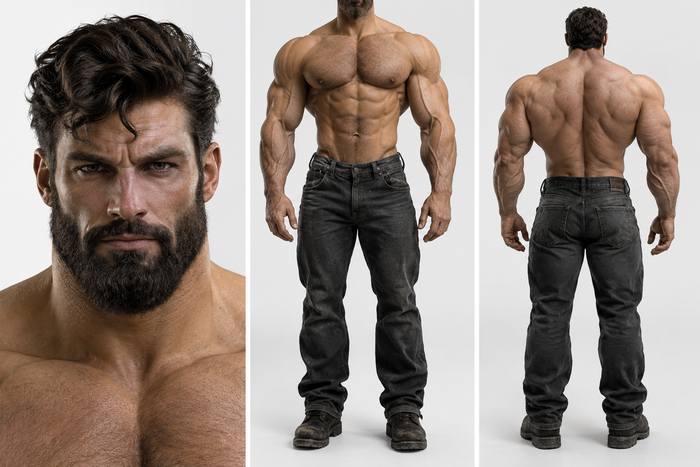
Откройте в Aigrator AI раздел генерации изображений и выберите:

Модель: Grok Imagine 2.0 или GPT Image 2
Формат: 16:9
Качество: 2K

Загрузите фотографию человека и попросите нейросеть собрать референс из нескольких ракурсов. В исходной методике используется лист из трёх вертикальных секций: портрет, вид тела спереди и вид сзади. Вставленный текст

Промпт для карты персонажа

Create a highly realistic character reference sheet based exclusively on the uploaded person. Use a clean white or very light gray studio background and divide the image into three vertical sections. PANEL 1: Create a close frontal portrait from the shoulders upward. The person looks directly into the camera with a calm neutral expression. Accurately preserve facial anatomy, eye shape and color, nose, lips, eyebrows, ears, skin tone, natural skin texture, hairstyle, hair color, freckles, moles and other recognizable details. PANEL 2: Show the person's body from the shoulders down to the feet, viewed directly from the front. The face and head should remain outside the crop. Use a natural upright posture with arms relaxed beside the body. Preserve body proportions, physique and the clothing visible in the source image. PANEL 3: Show the same person from behind, full body, including the back of the head and hairstyle. Keep the same physique, clothes, scale and proportions. Maintain identical identity, outfit, photographic realism and lighting across all three panels. Avoid beautification, body reshaping or changing the person's natural proportions. Use realistic anatomy, detailed fabric and high-resolution photographic rendering.

Такой референс помогает модели лучше понимать не только лицо, но и рост, телосложение, одежду и причёску.

При этом карта персонажа не обязательна — для генерации можно попробовать использовать и обычную фотографию.


Шаг 2. Настраиваем генерацию видео в Aigrator AI

Перейдите в раздел создания видео и выберите Seedance 2.5.

Рекомендуемые настройки:
Формат: 16:9
Продолжительность: 11 секунд
Разрешение: 720p

Для тестовой генерации можно сначала выбрать 480p, чтобы снизить расход генераций. Если результат устраивает, финальную версию можно сделать в 1080p.

Именно такие базовые параметры используются в исходном сценарии: Omni Reference, горизонтальный формат и продолжительность 11 секунд. Вставленный текст

Загрузите созданную карту персонажа или обычное исходное фото.

После этого вставьте промпт.


Промпт для видео «герой уходит от взрыва»

[TASK] Generate an exactly 11-second photorealistic horizontal 16:9 video. The entire scene must be captured as one continuous stationary smartphone shot at night. A single adult character defined by @image1 walks calmly toward the camera along the center of an empty road. The character briefly takes a drag from a cigarette, lowers the hand, exhales a small amount of smoke and casually flicks the cigarette backward over the right shoulder. The glowing cigarette travels through the air behind the character and reaches the road. At exactly 00:07, a large fictional cinematic explosion begins behind the person. At the exact moment the explosion starts, the entire scene transitions into smooth slow motion. The character never turns around, never reacts dramatically and continues walking confidently toward the camera. The final frame at 00:11 must still contain clearly visible flames behind the character. [CHARACTER REFERENCE] @image1 is the only reference for the person's identity. Preserve: - facial structure; - apparent age; - gender presentation; - skin tone; - hairstyle; - hair color; - facial hair if present; - physique; - body proportions; - clothing; - visible accessories. Build the full character consistently from the reference. Do not replace the person's body with a generic actor. Do not paste the source face onto an unrelated body. Do not introduce accessories, tattoos, jewelry or glasses that are absent from the source photograph. Do not reproduce the original photo background, pose or lighting. [ENVIRONMENT] Nighttime. The scene takes place on a wide, empty asphalt road extending far into the distance. The road contains simple white edge markings and a dashed center line. A sequence of tall streetlights runs along the RIGHT side of the road and gradually disappears toward the horizon. Dark vegetation and trees border the roadway. The sky is almost black. There are no buildings, pedestrians, parked vehicles or moving traffic. The asphalt should appear mostly dry. Keep the location simple and believable. [CAMERA] Use the visual character of ordinary modern smartphone footage. Camera position: fixed approximately at upper-torso height. Lens perspective: similar to a standard smartphone main camera, approximately 26 mm equivalent. The camera must remain completely stationary throughout the entire clip. Do not use: - tracking; - dolly movement; - zoom; - pan; - tilt; - orbit; - handheld shake; - cuts; - angle changes. The character begins far enough from the camera to show most or all of the body. As the person walks closer, they naturally become larger within the frame. Road markings, streetlights and horizon remain fixed. [PERFORMANCE] The character walks with a relaxed, controlled and confident pace. Maintain: - relaxed shoulders; - natural stride; - level head position; - calm serious facial expression. The gaze remains directed toward the camera or slightly beyond it. No exaggerated posing. No running. No stopping. No dramatic smiling. The character never turns around to inspect the explosion. [00:00–00:03] Normal playback speed. The character walks forward along the road. The cigarette is held naturally in the anatomical RIGHT hand. Bring it briefly toward the lips and take one realistic drag. The burning tip becomes slightly brighter during the inhale. Keep the face unobstructed and preserve natural hand anatomy. [00:03–00:04.6] Continue walking at exactly the same pace. Move the cigarette away from the mouth. Exhale a small natural cloud of smoke. The smoke may drift behind the head or shoulder but must not hide the face. Raise the right hand slightly beside the shoulder in preparation for the flick. No dialogue. [00:04.6–00:05.5] Perform one small casual backward finger-and-wrist flick. Release the cigarette backward above the right shoulder. Because the person faces the camera, the anatomical right hand appears on screen-left. The movement should be compact and effortless. Do not perform a large throwing motion. The cigarette must visibly leave the fingers once. The character keeps walking forward throughout the gesture. [00:05.5–00:07] Show the same cigarette travelling naturally through the air behind the person. Its glowing red-orange tip remains briefly visible against the dark background. Use a very subtle natural motion blur. Do not turn it into: - a fireball; - a laser; - a trail of sparks; - a glowing projectile. The cigarette follows one continuous trajectory and descends toward the asphalt behind the character. It must not duplicate, hover or teleport. The right hand returns naturally to the walking motion. [00:07 — EXPLOSION] At exactly seven seconds, trigger ONE fictional cinematic explosion on the road behind the character. The explosion is a stylized movie effect and should not depict any realistic ignition mechanism. Do not show: - fuel; - explosive devices; - preparation; - detonators; - ignition systems. Begin with a strong white-yellow flash close to road level. Add a small number of sparks travelling upward and outward. The sudden flash briefly lights the asphalt and creates a warm outline around the character. Do not create a full-screen white transition. [00:07–00:11 — SLOW MOTION] Immediately when the explosion begins, smoothly transition the entire video to approximately 40% playback speed. Slow motion applies globally to: - walking; - hair; - clothing; - flames; - sparks; - smoke. The person keeps moving toward the camera. They do not freeze. They do not turn around. Behind the character, expand the initial flash into a large rolling cinematic fireball. Use: - bright yellow inner flames; - orange outer flame shapes; - turbulent rounded fire clouds; - rising dark smoke; - a small amount of glowing airborne debris. The fire remains physically located on the road behind the character. Use believable light interaction with the surroundings. The character may become darker against the bright flames while receiving warm rim lighting on the hair, shoulders and clothing. Keep the face recognizable. No flame reaches the person. No debris strikes the performer or camera. At exactly 00:11, end the shot while the orange fire is still clearly visible. Do not end with smoke only. Do not fade to black. [SMARTPHONE LOOK] Make the footage resemble a normal nighttime smartphone recording. Use: - moderate fine digital noise; - realistic road texture; - standard smartphone sharpening; - natural motion blur; - restrained automatic exposure adjustment. When the explosion happens, allow the camera exposure to react briefly to the intense brightness. Do not completely lose facial detail. Avoid: - commercial studio lighting; - glossy advertising cinematography; - extreme cinematic color grading; - artificial anamorphic lens flares; - excessive background blur. [CONTINUITY] There is exactly: - one adult; - one cigarette; - one cigarette flick; - one explosion. Identity remains stable throughout the clip. Do not change: - face; - hairstyle; - body proportions; - clothing. After the cigarette is released, it must never reappear in the character's hand. Avoid: - duplicated fingers; - additional limbs; - floating feet; - changing facial anatomy; - clothing transformations; - unstable streetlights; - shifting road markings. The explosion always remains behind the character. [AUDIO] No dialogue. No narration. No singing. No music. Use only: - subtle nighttime ambience; - footsteps; - quiet cigarette inhale; - quiet exhale; - one cinematic explosion impact; - continuing fire sound. During slow motion, the sound may naturally become deeper and more prolonged. [FINAL CHECK] Exactly 11 seconds. Horizontal 16:9. One stationary smartphone-style camera angle. One person based completely on @image1. Empty road at night. Streetlights located on the RIGHT. One cigarette drag. One backward flick. Visible glowing cigarette trajectory. Explosion begins exactly at 00:07. Slow motion starts simultaneously with the explosion. The character continues walking calmly toward the camera. The character never looks back. Fire remains visible at 00:11. No cuts. No camera movement. No subtitles. No music. No watermarks. No additional scenes.

Исходная концепция строится именно вокруг одного непрерывного кадра: человек идёт к камере, выбрасывает сигарету назад, а на седьмой секунде позади появляется киношный взрыв и начинается общее замедление сцены. Вставленный текст


Почему персонаж не должен смотреть назад

Самый важный элемент этого тренда — не сам взрыв, а поведение героя.

Если после появления огня персонаж резко повернётся, испугается или остановится, эффект «невозмутимого героя» пропадёт.

Поэтому в промпте несколько раз фиксируется одно правило:

герой продолжает идти вперёд и ни разу не оборачивается.

В исходном сценарии это отдельно закрепляется и в блоке поведения персонажа, и в финальных требованиях. Вставленный текст Вставленный текст


Зачем указывать точное время взрыва

Без тайминга видеомодель может поставить взрыв практически в любой момент: сразу после начала ролика, слишком поздно или вообще одновременно с броском.

Поэтому здесь используется конкретная последовательность:

0–3 секунды — герой идёт и делает затяжку.

3–4,6 секунды — убирает сигарету и выдыхает дым.

4,6–5,5 секунды — выбрасывает сигарету назад.

5,5–7 секунд — она летит позади героя.

7 секунд — начинается взрыв.

7–11 секунд — сцена переходит в slow motion, а герой продолжает движение.

Такая структура помогает Seedance понять не только содержание сцены, но и последовательность событий. В оригинальном сценарии эти этапы также разделены по временным отрезкам. Вставленный текст


Как сохранить лицо человека

Одна из частых проблем видеогенераторов — персонаж хорошо выглядит в первом кадре, но по мере движения его черты начинают меняться.

Поэтому в промпте важно отдельно зафиксировать:

  • форму головы;

  • глаза;

  • нос;

  • губы;

  • линию челюсти;

  • причёску;

  • телосложение;

  • одежду;

  • аксессуары.

Также лучше прямо указать модели, чтобы она создавала цельного человека на основе референса, а не переносила лицо фотографии на случайное тело. Такой принцип подробно прописан и в исходном материале. Вставленный текст

Именно здесь особенно полезна карта персонажа: она даёт нейросети значительно больше информации, чем обычный портрет.


Почему камера должна оставаться неподвижной

Для этого видео лучше всего подходит статичный кадр.

Герой начинает идти вдали от камеры, постепенно приближается, а взрыв появляется за его спиной.

Если нейросеть начнёт двигать камеру вместе с персонажем, пропадёт ощущение обычного случайно снятого видео. Поэтому в промпте специально запрещены:

  • tracking;

  • zoom;

  • dolly;

  • pan;

  • tilt;

  • orbit;

  • смена ракурса.

В исходной инструкции также используется полностью фиксированная камера без зума, панорамирования и монтажных склеек. Вставленный текст


Как сделать взрыв визуально убедительнее

Не стоит ограничиваться командой вроде:

explosion behind the person

В таком случае модель может сделать небольшую вспышку или плоский слой огня.

Лучше описать эффект последовательно:

вспышка → огненный шар → языки пламени → дым → подсветка дороги → контровой свет на герое.

Особенно хорошо работает сочетание яркого жёлтого центра и более тёмного оранжевого огня по краям.

При этом огонь должен оставаться за персонажем, а не появляться вокруг него.

Исходный сценарий аналогично задаёт расширяющийся жёлто-оранжевый огненный шар, дым и контровую подсветку героя. Вставленный текст


Финальный результат

В результате должен получиться один непрерывный 11-секундный ролик:

герой спокойно идёт по ночной дороге → делает затяжку → выбрасывает сигарету назад → продолжает движение → позади происходит эффектный киношный взрыв → включается slow motion → персонаж даже не оборачивается.

Главное — сначала добиться хорошего сохранения внешности, а уже затем экспериментировать с масштабом огня, одеждой, дорогой, временем суток и характером освещения.

Для такой генерации удобно использовать связку Aigrator AI + Seedance 2.5, а карту персонажа предварительно подготовить через Grok Imagine 2.0 или GPT Image 2.
Показать полностью 1 1

Как сделать тренд «маленький рыцарь» через нейросеть: два персонажа, карта глубины и Seedance 2.5⁠⁠

Серия ИИ тренды

В этом тренде я создаю короткую кинематографичную сцену, где один человек превращается в маленького рыцаря с мечом, а второй появляется рядом как огромный персонаж. Камера сначала показывает только миниатюрного героя, затем отъезжает назад и раскрывает масштаб сцены: слева стоит второй человек с огромным мечом, вокруг идет мелкий дождь, трава пригибается от ветра, а туман быстро движется через кадр.

Все генерирую в Syntx Ai

Карту глубины можно сгенерировать тут

Главная фишка здесь именно в контрасте размеров. Я не уменьшаю одного человека уже внутри готового видео и не растягиваю второго. Сначала отдельно подготавливаю двух персонажей с правильной внешностью, одеждой и оружием, затем использую карту глубины как основу для камеры и композиции, а финальную сцену собираю в Seedance 2.5.

Для работы нужен аккаунт в Syntx.ai, тариф PRO или выше, две фотографии людей, карта глубины и звук, который при необходимости добавляется уже при монтаже. В исходной схеме для видео используется Seedance 2.5

Ниже я полностью сохраняю этапы генерации и исходные промты, потому что именно в них зафиксированы размеры персонажей, положение мечей, направление ветра и движение камеры.

Почему я сначала готовлю персонажей отдельно

Если сразу загрузить две обычные фотографии в видеогенератор и попросить сделать одного человека маленьким рыцарем, а второго огромным персонажем, модели придется одновременно решать слишком много задач.

Ей нужно сохранить два лица, придумать броню, спортивную одежду, два разных меча, правильно изменить относительный масштаб людей, поставить их в нужные позиции и еще воспроизвести сложную погоду.

Поэтому я сначала получаю две чистые карточки персонажей.

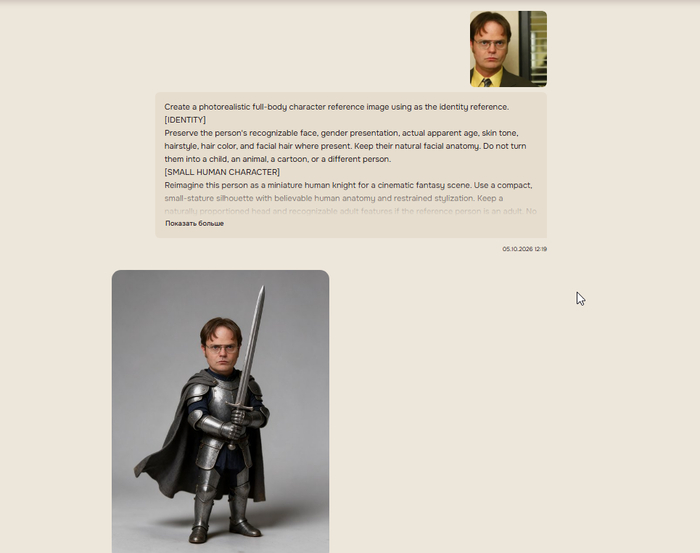
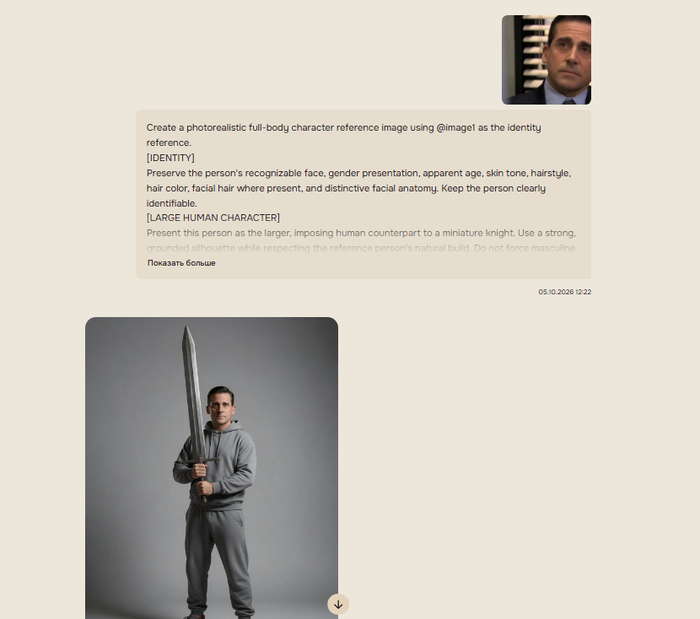
Первый герой уже выглядит как небольшой рыцарь. Второй уже подготовлен как крупный человек в сером спортивном костюме с огромным мечом.

После этого Seedance не придумывает их дизайн заново, а использует готовые изображения как визуальную основу.

Шаг 1. Готовим фотографии персонажей и карту глубины

Первого персонажа я создаю через Seedream 5.0 Pro. Исходная фотография отправляется в раздел изображений, формат ставится 3:4, качество - 2K. Именно такая последовательность указана в исходной инструкции.

Промт для первого персонажа

Промт оставляю без изменений:

Create a photorealistic full-body character reference image using as the identity reference.
[IDENTITY]
Preserve the person's recognizable face, gender presentation, actual apparent age, skin tone, hairstyle, hair color, and facial hair where present. Keep their natural facial anatomy. Do not turn them into a child, an animal, a cartoon, or a different person.
[SMALL HUMAN CHARACTER]
Reimagine this person as a miniature human knight for a cinematic fantasy scene. Use a compact, small-stature silhouette with believable human anatomy and restrained stylization. Keep a naturally proportioned head and recognizable adult features if the reference person is an adult. No oversized baby head, chibi proportions, feline ears, paws, fur, or tail.
[ARMOR AND CLOAK]
Replace the original clothing with a coherent suit of weathered steel knight armor: fitted breastplate, modest shoulder plates, articulated forearm protection, protective gloves, a dark fabric underlayer, and armored boots. Add a short, worn charcoal-gray cloak attached at the shoulders and falling behind the body. The cloak has a gently wind-lifted edge toward screen-left.
No helmet or hood covering the head. Keep the face and hairstyle fully visible. No oversized shoulder armor, excessive ornament, glowing runes, or bulky shapes hiding the human figure.
[SWORD AND POSE]
The person stands firmly, facing almost directly toward the camera, with feet slightly apart. Hold one straight steel sword vertically in front of the torso, POINT UP, using both hands around the hilt. The hilt is around the upper abdomen; the blade rises above the head without blocking the eyes, nose, or mouth. Offset it slightly from the facial centerline if needed.
The sword is proportionate to this smaller knight, with a simple crossguard, dark grip, and realistic metal surface. Both hands remain anatomically clear. No extra fingers, floating weapon, duplicated blade, or blade passing through the face.
[EXPRESSION]
Serious, composed, quietly determined. Relaxed closed mouth, no smile, no visible teeth. Gaze forward.
[REFERENCE IMAGE PRESENTATION]
One character only, centered, full body from head to soles. Include the entire sword tip and cloak with clear margins around the silhouette. Neutral gray studio background and ground, soft directional light, subtle contact shadow, readable skin and armor detail.
Use restrained perspective without wide-angle distortion. This is a clean character reference, not an action scene: no fog, grass, storm, motion blur, text, labels, collage, or additional views.
Vertical 3:4 composition. Photorealistic face, believable human anatomy, detailed fabric and metal.

На этом этапе мне важно не получить максимально красивую фэнтези-картинку, а добиться хорошего референса персонажа.

Человек должен быть показан полностью, меч не должен закрывать лицо, а само лицо должно оставаться узнаваемым.

Фон специально остается нейтральным. Туман, поле, дождь и драматический свет появятся уже в видео.

Готовим второго персонажа

Для второго человека исходная схема использует GPT Image 2.5 Sunburst, снова с соотношением сторон 3:4 и качеством 2K.

Здесь мне нужен уже не рыцарь. Второй персонаж должен выглядеть как большой человек в простом сером спортивном костюме.

Важно, что модель не должна физически уродовать его ради ощущения масштаба. Голова, руки и ноги остаются нормальными. Огромным он будет выглядеть только относительно первого героя.

Промт для второго персонажа

Его тоже оставляю без изменений:

Create a photorealistic full-body character reference image using @image1 as the identity reference.
[IDENTITY]
Preserve the person's recognizable face, gender presentation, apparent age, skin tone, hairstyle, hair color, facial hair where present, and distinctive facial anatomy. Keep the person clearly identifiable.
[LARGE HUMAN CHARACTER]
Present this person as the larger, imposing human counterpart to a miniature knight. Use a strong, grounded silhouette while respecting the reference person's natural build. Do not force masculine features onto a woman, exaggerate muscles, enlarge the head, or distort the limbs.
The person should have normal human anatomy and proportions; their greater scale will be established relative to the smaller character in the final scene.
[GRAY OUTFIT]
Replace the original clothing with a coordinated gray casual sports outfit:
a plain medium-gray pullover hoodie,
matching gray jogger trousers,
and gray athletic sneakers.
The hood is DOWN, resting behind the neck and on the upper back. It must not cover the head, hair, ears, or forehead.
Use realistic cotton-fleece texture, natural folds, ribbed cuffs, and a comfortable fit that preserves the person's body shape. Keep the sneakers believable and proportionate.
No armor, cape, coat, helmet, visible brand logos, or added jewelry.
[GREAT SWORD AND POSE]
The person stands firmly, facing almost directly toward the camera, with feet slightly apart. Hold one enormous, broad steel greatsword vertically before the torso, POINT UP, with both hands around its long grip.
The hilt is around the upper abdomen. The blade extends well above the head and is substantially larger and broader than a normal sword.
Give it a coherent straight blade, simple strong crossguard, dark wrapped grip, and believable weathered metal. Keep it large but controllable within the composition.
Do not let the blade cover the face: position it slightly off the facial centerline while keeping it upright before the body.
Show correct hand contact, natural elbows, and a balanced stance appropriate to supporting the weapon. No bent blade, duplicated sword, floating grip, extra fingers, or intersecting anatomy.
[EXPRESSION]
Serious, calm, resolute. Gaze forward. Lips naturally closed, no smile and no visible teeth. No exaggerated aggression.
[REFERENCE IMAGE PRESENTATION]
One character only, centered, full body from head to sneaker soles. Include the complete sword tip with sufficient space above it. Neutral gray studio background and ground, soft directional light, subtle contact shadow, clearly readable face and outfit.
Use restrained perspective without wide-angle distortion. Match the clean presentation of a character reference image.
No fog, grass, storm, motion blur, text, labels, collage, or additional views.
Vertical 3:4 composition. Photorealistic skin, natural human anatomy, detailed gray fabric and steel.

Здесь я особенно смотрю на меч и руки. Если оружие уже на референсе получилось кривым или пальцы плохо держат рукоять, в видео эта ошибка может только усилиться.

Поэтому плохой референс лучше переделать сразу.

Зачем в этом тренде нужна карта глубины

Карта глубины здесь работает не как еще одна картинка персонажа.

Я использую ее для другого: она показывает Seedance, как должна двигаться камера и где должны находиться люди относительно друг друга.

В начале маленький рыцарь занимает заметную часть кадра. Затем камера физически уходит назад, и только после этого слева открывается второй, значительно более крупный персонаж.

За счет этого и появляется главный визуальный эффект тренда.

Если заменить такое движение обычным цифровым уменьшением изображения, сцена будет выглядеть значительно слабее. Зритель должен чувствовать изменение перспективы.

Шаг 2. Создаем видео в Seedance 2.5

Дальше я перехожу в раздел видео.

Исходные настройки оставляю точно такими же:

  • выбираю Seedance 2.5;

  • режим Omni Reference;

  • качество 720p;

  • при необходимости 480p для экономии или 1080p для максимального качества;

  • формат 4:3;

  • длительность 10 секунд;

  • загружаю первого персонажа, второго персонажа и карту глубины.

Карту глубины можно сгенерировать тут

Достаточно взять мое видео и закинуть в этот сервис

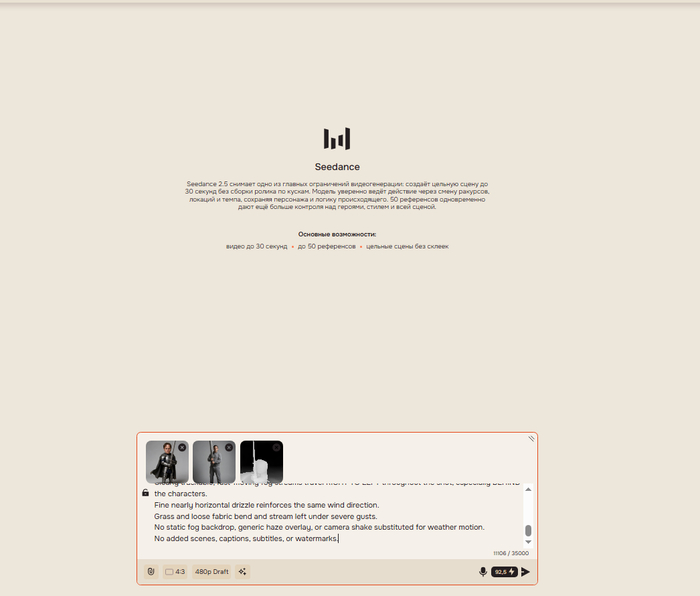
После вставки промта в интерфейсе нужно проверить привязку @image1, @image2 и @video1.

В исходной инструкции указано, что при

ручной работе эти обозначения нужно удалить и добавить заново через @, выбрав соответствующий файл. В Syntx.ai референсы привязываются автоматически.

Как распределяются файлы

Здесь важно ничего не перепутать.

@image1 - маленький рыцарь справа.

@image2 - большой персонаж слева.

@video1 - карта глубины, которая задает камеру, расположение героев и момент раскрытия второго человека.

Именно такое распределение зафиксировано в исходном видеопромте.

Промт для Seedance 2.5

Сам видеопромт я тоже оставляю полностью без изменений.

[TASK — TWO CHARACTERS IN A VIOLENT WINDSTORM]
Create a 10-second cinematic photorealistic video, horizontal 4:3, 24 fps output.
One continuous handheld shot in a violently windswept, fog-covered grassland.
Begin on the first character holding a sword vertically before their body. Move the camera backward to reveal the second, larger character on the left holding a much larger sword upright.
Both remain serious and resolute while fast-moving fog, fine wind-driven rain, grass, and loose fabric visibly stream from SCREEN-RIGHT TO SCREEN-LEFT.
[REFERENCE ASSIGNMENTS]
@video1 is a DEPTH-MAP reference for camera trajectory, framing progression, spatial arrangement, approximate poses, sword placement, and reveal timing.
@image1 defines the complete appearance of the FIRST, SMALLER character, initially featured and positioned on the RIGHT in the final composition.
@image2 defines the complete appearance of the SECOND, LARGER character, revealed on the LEFT.
Each photograph defines gender presentation, apparent age, face, skin tone, hairstyle, body proportions, clothing, accessories, and footwear.
Preserve any miniature or larger-scale character design already established in the prepared images.
[DEPTH — SOFT SPATIAL GUIDANCE]
Use @video1 as a moving spatial storyboard, not a rigid mesh to texture.
Follow the backward camera movement, changing viewpoint, relative positions, and left character's reveal.
Do not inherit the source figures' facial anatomy, headwear, armor silhouettes, or clothing when these differ from the photographs.
Photos take priority for character appearance. The written weather instructions take priority for fog, rain, and wind intensity.
Do not copy static or weakly moving fog from the depth map. Generate the clearly visible, fast-moving weather described below.
Adapt the source composition to 4:3 without stretching the image or cropping out the left character, faces, or important sword details.
[IDENTITY AND CLOTHING]
Construct each complete character from their corresponding photograph.
Preserve the face, physique, relative character design, hairstyle, outfit, and accessories throughout.
Do not paste replacement faces onto the source bodies.
Do not blend or swap identities.
Preserve armor and a cloak if present in @image1.
Preserve the gray hoodie, trousers, sneakers, and lowered hood if present in @image2.
Do not raise a lowered hood or invent additional clothing.
Wind animates the existing garments without changing their construction.
[PLACEMENT AND REVEAL]
The first character is visible at the opening and remains on the RIGHT as the shot widens.
The second character is already standing to the LEFT, outside the initial framing, and is revealed by the camera's backward movement.
Preserve the intended contrast between the smaller right character and larger left character without distorting their individual anatomy.
Neither character walks into position, materializes, fades in, or changes size during the shot.
[SWORDS]
Both hold swords vertically before their bodies with the POINTS UP and both hands around the hilts.
The right character holds the smaller sword. The left character holds the much larger, broader greatsword.
Preserve sword designs from the prepared images where visible.
Keep hands near the upper abdomen or lower chest, following the reference pose.
Blades remain rigid and coherent. Keep faces readable rather than hidden behind the blades.
No swinging, attacking, bending weapons, duplicated swords, or fingers intersecting the grips.
[PERFORMANCE]
Serious, calm, determined expressions. No smile, dialogue, or exaggerated aggression.
Preserve reference head angles, attention, and sword-holding posture.
Allow subtle breathing, blinking, and restrained balance corrections against the gusts.
The characters hold their ground. No sliding feet, exaggerated swaying, or weightless bodies.
[CAMERA — BACKWARD REVEAL AND STRONG HANDHELD SHAKE]
Follow the backward reveal in @video1.
Begin with the first character and upright sword, then physically move backward with the source-guided reframing to reveal the second character on the LEFT.
End in a wider two-character composition within the 4:3 frame.
Preserve changing perspective and depth relationships. This is not merely a digital zoom-out.
Superimpose pronounced, irregular handheld movement, as if the operator is struggling against severe gusts: brief lateral and vertical jolts, small roll disturbances, and imperfect corrections.
Do not smooth the shot into a stabilized gimbal move.
Keep the subjects readable. No repetitive vibration loop, excessive whip movement, or body deformation.
The camera shake and weather movement are separate effects: shaking the frame must NOT replace actual fog movement through the scene.
One continuous shot. No cuts, orbit, drone ascent, or reverse angle.
[TIMING]
Fit the depth reference's reveal naturally into 10 seconds.
Opening: establish the first character, upright sword, and immediately visible storm movement.
Development: continue backward and progressively reveal the larger character on the LEFT.
Ending: both characters and swords remain readable while strong wind, rapidly streaming fog, fine rain, and handheld movement continue.
Do not freeze the final composition or weaken the storm after the reveal.
[ENVIRONMENT]
An exposed, uneven grassland with low vegetation, patches of damp earth, and a distant horizon obscured by moving fog.
Muted gray-green grass, dark earth, pale gray mist, and an overcast sky.
No buildings, extra people, armies, vehicles, dramatic ruins, or invented landmarks.
[CRITICAL WEATHER — VISIBLE HIGH-SPEED RIGHT-TO-LEFT FLOW]
The dominant wind blows continuously from SCREEN-RIGHT TO SCREEN-LEFT.
It must be unmistakably visible in the movement of fog, fine rain, grass, hair, and fabric, not merely implied by sound or camera shake.
The viewer must be able to follow individual fog streaks and denser wisps entering from the right, racing behind or around the characters, and exiting to the left.
This lateral motion must remain visible relative to the characters and terrain even during handheld camera movement.
No stationary background haze, slowly breathing smoke, or fog that only changes opacity in place.
[FOG — FAST STREAMS AT MULTIPLE DEPTHS]
Build the fog from distinct moving layers rather than one uniform gray wall.
BACKGROUND: elongated pale-gray fog banks sweep rapidly RIGHT TO LEFT behind the characters. Visible variations in density reveal their travel across the landscape.
MIDGROUND: more defined wisps and ribbons race between terrain features, behind shoulders, and around the figures, curling and stretching under gusts.
GROUND LEVEL: low fog surges horizontally through the grass and around legs.
OCCASIONAL FOREGROUND: thin translucent strands cross the lower frame quickly, adding depth without hiding faces.
During stronger gusts, distinct fog structures cross a substantial portion of the frame within roughly one to two seconds. Keep this readable as lateral advection, not rapid dissolving or flickering.
Use turbulence and local curls within the dominant RIGHT-TO-LEFT flow. Do not reverse the overall direction.
Provide enough tonal variation behind the moving mist to make its motion visible, while keeping the distant setting obscured.
Do not simulate this by sliding a flat background plate. Fog flows through the scene while the landscape retains coherent geometry.
[FINE WIND-DRIVEN RAIN]
Add fine, sparse-to-moderate wind-driven drizzle as a secondary direction cue.
Small droplets form short, subtle streaks travelling predominantly from SCREEN-RIGHT TO SCREEN-LEFT with a slight downward diagonal.
The rain is pushed almost sideways by the wind, not falling vertically.
Use variation in streak size and focus according to depth; avoid identical repeated lines.
Keep it fine rain, not thick cinematic rain ropes, snow, hail, sparks, or flying debris.
Rain must not obscure the faces or overpower the streaming fog.
Avoid large water droplets on the lens that conceal the scene.
[GRASS, HAIR, AND FABRIC]
Grass bends strongly toward SCREEN-LEFT, with visible waves of pressure travelling through it.
Rooted vegetation stays attached and partly rebounds between stronger gusts.
Loose hair and garment edges stream left in the same wind.
Any cloak pulls outward and snaps left with believable weight, folds, and tension at its shoulder attachments.
Heavy garments respond less freely than thin fabric.
Do not make every strand or blade of grass oscillate in perfect synchronization.
Do not replace directional motion with random fluttering.
[WEATHER COHERENCE AND VISIBILITY]
Fog, drizzle, grass, hair, and fabric share the same prevailing RIGHT-TO-LEFT wind.
Gust intensity varies, but the directional flow never disappears.
Keep faces, hands, and swords readable through gaps and translucent layers.
The background fog must visibly MOVE, not simply make the background gray.
No explosion-like smoke bursts, vertical smoke columns, magical particles, lightning, or opaque whiteout.
[LIGHTING AND COLOR]
Cold, diffuse overcast daylight with soft shadows and restrained contrast.
Desaturated gray-green surroundings and believable skin tones.
Subtle highlights reveal moving rain and fog edges without theatrical backlighting.
Preserve photo-defined clothing colors. Maintain readable texture in gray clothing against the gray atmosphere.
Natural metal reflections on swords and any armor.
No warm sunset, artificial glowing eyes, excessive blue skin, or dramatic spotlights.
[IMAGE QUALITY AND CONTINUITY]
Maintain stable faces, bodies, outfits, sword geometry, and hand anatomy through camera shake and weather.
Use natural motion blur for fast-moving mist, drizzle, fabric, and camera jolts.
Do not smear all fog into a featureless wash; retain enough streak and density structure to show its direction and speed.
No duplicated limbs, changing costumes, sliding feet, warped terrain, or rubber-like deformation.
[AUDIO]
If sound generation is supported, use sustained strong wind with irregular gusts, fabric flapping, vegetation rustle, and restrained fine-rain texture.
No dialogue, narration, singing, added music, or exaggerated cinematic impacts.
Weather must remain visually convincing even with the sound muted.
[FINAL PRIORITIES]
Exactly 10 seconds, horizontal 4:3, 24 fps output.
@image1 is the initially featured smaller RIGHT character; @image2 is the larger LEFT character.
Photos define identity, age, gender presentation, anatomy, clothing, and character design.
Depth guides camera, staging, poses, and reveal timing.
One continuous backward reveal with pronounced irregular handheld shake.
Both swords remain upright, points UP.
Clearly trackable, fast-moving fog streams travel RIGHT TO LEFT throughout the shot, especially BEHIND the characters.
Fine nearly horizontal drizzle reinforces the same wind direction.
Grass and loose fabric bend and stream left under severe gusts.
No static fog backdrop, generic haze overlay, or camera shake substituted for weather motion.
No added scenes, captions, subtitles, or watermarks.

Что именно создает эффект тренда

Когда я смотрю на эту сцену, главный эффект появляется не от брони и даже не от гигантского меча.

Он появляется в момент, когда камера отъезжает.

Сначала зритель воспринимает маленького рыцаря почти как обычного человека. Его настоящий размер становится понятен только тогда, когда слева появляется второй герой.

Поэтому я особенно внимательно слежу за тремя вещами: камера должна физически двигаться назад, второй персонаж не должен «вырастать» внутри кадра, а маленький герой не должен уменьшаться во время ролика.

Оба стоят на своих местах с самого начала. Просто второго человека сначала не видно.

Именно это отдельно зафиксировано в промте.

Почему в видео столько внимания уделено ветру

Второй важный элемент - ощущение настоящего шторма.

Просто добавить серый туман на фоне недостаточно.

По задумке ветер постоянно идет справа налево. Это направление должно быть заметно одновременно по туману, мелкому дождю, траве, волосам и плащу рыцаря.

За счет этого все элементы сцены начинают ощущаться частью одного пространства.

Если туман движется влево, а плащ вдруг развивается вправо, эффект быстро ломается.

Именно поэтому большая часть исходного промта посвящена не внешности персонажей, а физике окружающей среды.

Что делать, если вместо отъезда камеры получается zoom-out

Это одна из самых заметных ошибок.

При zoom-out изображение просто визуально уменьшается. Перспектива почти не меняется.

Здесь же камера должна реально двигаться назад.

Передний герой постепенно становится меньше в кадре, меняются отношения между объектами и открывается пространство слева.

В промте это отдельно сформулировано как:

This is not merely a digital zoom-out.

Если первая генерация просто уменьшает весь кадр, я бы в первую очередь усиливал именно блок CAMERA, а не переписывал описание персонажей.

Если большой персонаж появляется из воздуха

По сценарию он уже стоит слева с самого начала.

Просто в стартовом кадре он находится за пределами композиции.

По мере отъезда камеры второй герой постепенно открывается.

Если модель заставляет его войти в сцену, материализоваться или увеличиваться на глазах, это уже другая постановка.

В таком случае особенно важен блок:

Neither character walks into position, materializes, fades in, or changes size during the shot.

Если лица начинают меняться

Здесь я возвращаюсь не к видео, а к исходным карточкам персонажей.

Они должны быть максимально чистыми и понятными.

Для обоих людей желательно:

хорошо читаемое лицо, полный рост, понятная одежда, правильные руки и уже готовое оружие.

Если на исходном изображении лицо маленькое или меч перекрывает половину головы, Seedance получает плохой референс.

Поэтому иногда правильнее переделать первую картинку, чем десять раз запускать одно и то же видео.

Если туман выглядит как статичный серый фон

В промте специально запрещен неподвижный haze.

Туман должен быть разбит на несколько слоев.

На заднем плане идут крупные полосы, в среднем плане более заметные потоки проходят возле персонажей, а небольшие прозрачные участки иногда пересекают передний план.

Главное - зритель должен видеть, что туман физически перемещается справа налево, а не просто висит в воздухе.

Добавляем звук

В исходной схеме звук можно добавить отдельно на монтаже. Для сцены лучше всего подходят сильный порывистый ветер, шорох одежды, движение травы и очень мелкий дождь.

Музыка здесь не обязательна.

Сам шум шторма уже хорошо поддерживает масштаб сцены.

Если модель умеет генерировать звук вместе с видео, соответствующая инструкция уже находится в основном промте.

Итог

Где встречается этот тренд

Такой ролик сейчас используют не только как отдельную фэнтези-сцену с маленьким рыцарем. Этот визуальный прием встречается и в мемных видео с подписями вроде:

«Когда девушка сказала: “Давай я тебе помогу”»

Смысл строится на контрасте. Сначала зритель видит маленького героя, который выглядит самостоятельным и серьезным, а затем камера отъезжает и рядом появляется огромный второй персонаж. За счет разницы в масштабе обычная ситуация превращается в визуальную шутку.

Поэтому один и тот же шаблон можно адаптировать под разные короткие тренды:

  • «Когда девушка сказала: “Давай я тебе помогу”»

  • «Я: справлюсь сам. Она через минуту:»

  • «Когда попросил совсем немного помощи»

  • «Я и мой друг, который сказал, что просто постоит рядом»

  • «Когда решил взять поддержку с собой»

В генерации при этом почти ничего менять не нужно. Маленький персонаж остается справа, большой появляется слева после отъезда камеры, а подпись уже задает смысл ролика.

В этом тренде я не пытаюсь заставить видеонейросеть сделать всю работу за один запрос.

Сначала отдельно готовлю маленького рыцаря и большого персонажа. Затем использую карту глубины для постановки камеры и только после этого собираю сцену в Seedance 2.5.

Так модель получает четкое разделение задач:

фотографии определяют персонажей;

карта глубины задает пространство и движение камеры;

промт отвечает за погоду, поведение героев и финальную композицию.

Именно поэтому результат выглядит значительно стабильнее, чем генерация двух случайных людей сразу внутри сложного штормового кадра.

Главное в этом тренде не просто уменьшить одного человека. Нужно создать момент, когда зритель сам понимает масштаб сцены во время отъезда камеры. Тогда маленький рыцарь действительно воспринимается маленьким, а второй персонаж становится визуально огромным без деформации его тела.

Реклама. SYNTX INTELLIGENCE – FZCO. ИНН:105317427000001
Показать полностью 3

Как повторить танец Литвина, Равшана и Адель с ИИ: видео по 3 фото без промта⁠⁠

Серия ИИ тренды

Тренд с Литвиным, Равшаном и Адель снова разошелся по коротким видео. В оригинальной сцене трое героев по очереди танцуют возле машин на парковке, а в новых версиях вместо них появляются друзья, родственники, блогеры или любые другие персонажи.

Сейчас для такого ролика уже не обязательно искать исходное видео, разбираться в Seedance или самостоятельно писать длинный промт. В нескольких сервисах появился готовый сценарий: достаточно загрузить фотографии, распределить людей по ролям и запустить генерацию.

Для этого подойдут Study24 AI, Avalava AI и AiHere. У каждого сервиса реализация немного отличается, но принцип один: сценарий, движения и камера уже подготовлены заранее.

Самый простой способ сделать тренд

Для ролика нужны три фотографии. Один человек заменяет героя, который танцует первым, второй появляется в роли оператора, а третий выходит возле машины.

Лучше использовать отдельное фото для каждого человека. Лицо должно быть четким, без сильных теней и перекрытий. Если хотите поместить одного человека сразу во все три роли, можно загрузить несколько его фотографий с разных ракурсов.

Дальше выбираете готовый шаблон и загружаете снимки. Промт писать не нужно: движения, композиция и последовательность сцены уже заданы внутри шаблона.

1. Study24 AI

Study24 AI предлагает один из самых простых способов повторить этот тренд. В сервисе есть отдельный агент «Тренд», где уже настроены сцена, монтаж, камера и движения персонажей.

Пользователю не нужно искать оригинальное видео и вручную описывать хореографию. Достаточно загрузить три фотографии по ролям, после чего сервис собирает вертикальный ролик автоматически.

Распределение здесь простое. Первое фото используется для героя, который танцует в начале. Второй человек появляется как оператор и затем возвращается ближе к финалу. Третье фото используется для персонажа возле автомобиля.

Это удобно прежде всего для тех, кто не хочет разбираться в настройках видеомоделей. Не нужно самостоятельно выбирать длительность, подробно описывать парковку, движение камеры или танец.

Открываете готовый агент, добавляете фотографии и запускаете генерацию.

При этом внутри Study24 есть и более продвинутый вариант через Seedance 2.5, если хочется вручную работать с исходником и референсами. Но именно для тренда проще использовать готовый сценарий без ручного промта.

2. Avalava AI

В Avalava AI тренд оформлен как готовый эффект «Танец на заправке».

Здесь механика еще проще: сервис просит загрузить три портретные фотографии, после чего нейросеть переносит героев в подготовленную сцену и повторяет характерные движения. На странице эффекта прямо указано, что после загрузки фотографий больше ничего заполнять не требуется.

То есть самостоятельно писать запрос вроде «сделай парковку на рассвете, поставь трех людей и повтори их движения» не нужно. Такой сценарий уже встроен в эффект.

Для Avalava особенно важно качество портретов. Сам сервис рекомендует использовать фотографии, где лицо хорошо освещено, полностью видно и занимает значительную часть изображения.

Поэтому здесь лучше брать не случайные фотографии издалека, а нормальные портреты каждого участника.

Схема использования максимально короткая: открыть эффект, добавить три фото и запустить результат.

3. AiHere

AiHere тоже позволяет повторить танец Литвина, Равшана и Адель через готовый шаблон.

Сервис использует подготовленный сценарий, поэтому искать исходный ролик или писать собственный промт не требуется. Пользователь нажимает «Использовать шаблон», после чего нужные настройки подставляются автоматически.

Для основной версии AiHere использует Seedance 2.5. Шаблон рассчитан на три фотографии и собирает вертикальное видео примерно на 20 секунд.

Здесь тоже важно не перепутать людей. Первое фото становится героем, который танцует в начале ролика, второе используется для персонажа с камерой, третье для героя возле машины.

После этого остается только запустить генерацию.

Главное преимущество такого подхода в том, что пользователю не приходится понимать, как работает Seedance 2.5. Шаблон уже содержит логику сцены, движения и последовательность появления персонажей.

Какие фотографии лучше загрузить

От фотографии здесь зависит больше, чем от любых дополнительных настроек.

Для каждого героя лучше использовать отдельный четкий снимок. Лицо должно хорошо читаться, а сам человек не должен быть закрыт рукой, волосами или крупными аксессуарами.

Для Study24 и AiHere полезно брать кадры, где видно не только лицо, но и фигуру. Так модели проще перенести человека в танцевальную сцену. Avalava, наоборот, отдельно рекомендует хорошо читаемые портреты.

Если первая генерация плохо сохранила лицо, обычно быстрее заменить фотографию, чем пытаться исправлять результат дополнительными настройками.

Нужно ли скачивать оригинальный ролик

Для готовых шаблонов нет.

В Study24 агент уже содержит подготовленный сценарий. В Avalava используется готовый эффект. В AiHere сцена тоже собрана внутри шаблона. Поэтому пользователь может начать сразу с фотографий.

Исходное видео понадобится только в том случае, если вы решите делать более точную или собственную версию через обычный режим Seedance.

Для большинства пользователей это лишний этап.

Что выбрать

Если хочется максимально простой вариант без работы с промтами, можно начать с Study24 AI. Там есть отдельный агент для тренда, где достаточно распределить три фотографии по ролям.

Avalava AI подойдет тем, кому нравится формат готовых эффектов: выбрали сцену, загрузили фотографии и получили результат.

AiHere интересен тем, кто хочет использовать готовый шаблон на Seedance 2.5, но не заниматься настройкой модели вручную.

Во всех трех вариантах идея одна: не писать промт самому, а использовать уже подготовленный сценарий.

Можно ли использовать свои фотографии вместо трех разных людей

Да. Можно поставить в сцену себя и двух друзей или использовать одного человека сразу в нескольких ролях.

Если нужен один и тот же человек во всей сцене, лучше взять несколько разных фотографий этого человека. Например, портрет анфас, фото под небольшим углом и более общий кадр.

Так модели проще удерживать внешность при смене планов.

Почему такой формат стал популярным

У тренда очень простая механика. Движения узнаваемые, сцена короткая, а трех оригинальных участников легко заменить на любую другую компанию.

В результате один и тот же шаблон можно использовать для друзей, семьи, коллег, героев фильмов или полностью вымышленных персонажей.

Но главное изменение 2026 года в другом: раньше для подобного ролика нужно было разбираться с исходным видео и писать длинные инструкции для видеомодели. Сейчас готовые шаблоны сокращают весь процесс до нескольких фотографий и одной кнопки генерации.

FAQ

Как сделать танец Литвина через нейросеть без промта?

Используйте готовый шаблон в Study24 AI, Avalava AI или AiHere. Загружаете три фотографии по ролям и запускаете генерацию. Сценарий и движения уже подготовлены внутри сервиса.

Сколько фотографий нужно?

Для полной замены всех участников тренда нужны три фотографии, по одной на каждого персонажа.

Можно ли поставить одного человека во все роли?

Да. Лучше использовать несколько его фотографий с разными ракурсами.

Нужно ли писать промт?

Для готовых шаблонов нет. В Study24 агент уже содержит сценарий, в Avalava используется готовый эффект, а в AiHere промт и настройки подставляются автоматически.

Какой сервис выбрать новичку?

Если нужен максимально простой путь, удобнее начинать с готового агента Study24 AI или эффекта Avalava. AiHere подойдет тем, кто хочет готовый шаблон на базе Seedance 2.5 без ручной настройки.

ООО «Диджитал Гениус». ИНН 7813681158
Показать полностью

ИИ тренд как повторить сцену на балконе «Три метра над уровнем неба» через Seedance 2.0⁠⁠

Серия ИИ тренды

Через Seedance 2.0 можно взять готовый фрагмент из фильма и заменить в нем двух персонажей на себя и друга, сохранив оригинальные движения камеры, монтаж, свет и действия актеров.

В этом гайде используется сцена из «Три метра над уровнем неба»: первый герой находится на балконе над клубом, второй сначала виден среди людей в зале, а затем появляется крупным планом.

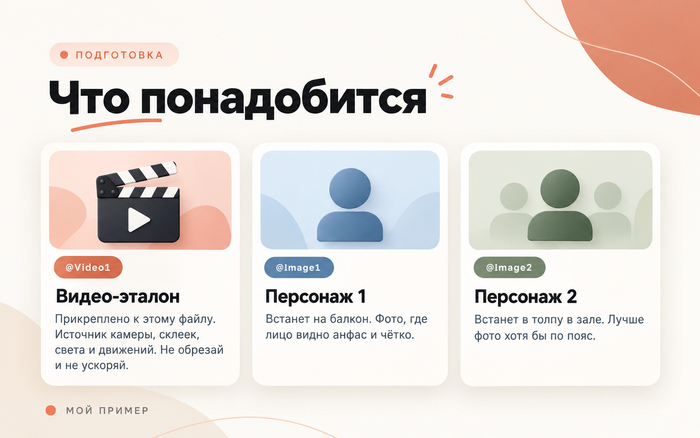
Для генерации понадобятся всего три файла: исходное видео, фотография человека для балкона и фотография человека для зала. Самое важное - загрузить их в правильном порядке и не менять структуру готового промта.

Сгенерировать тренд

Что нужно сделать

ИИ тренд как повторить сцену на балконе «Три метра над уровнем неба» через Seedance 2.0

Сначала подготовьте оригинальный фрагмент сцены продолжительностью около 15 секунд. Это будет @video1.

Затем выберите фотографию первого человека. Он заменит героя, который стоит на балконе. Это будет @Image1.

После этого подготовьте фотографию второго человека. Он заменит персонажа, который находится в толпе и появляется крупным планом ближе к концу ролика. Это @Image2.

Загружать файлы в Seedance 2.0 нужно строго так:

Видео → Фото 1 → Фото 2

То есть @Video1 → @Image1 → @Image2.

После загрузки вставляем промт, выставляем вертикальный формат 9:16 и длительность 15 секунд.

На этом основная подготовка закончена.

Готовый промт для Seedance 2.0

Промт лучше вставлять полностью, без сокращений:

Recreate @Video1 exactly 1:1 — same shots, cuts, camera moves, timing, locations, lighting, crowd, poses, movements and expressions. Change only the two main people. PERSON 1 — the person on the balcony (shots 1 and 2) = the person in @Image1. PERSON 2 — the person in the crowd (seen small in shot 2, close-up in shot 3) = the person in @Image2. IDENTITY LOCK: each face must be instantly recognizable as the exact same person from the reference photo, in every frame, from every angle and in every light. Copy the real facial features 1:1 — face shape, eyes and eye color, eyebrows, nose, lips, jaw, cheekbones, skin tone, facial hair and hairstyle. Do not beautify, stylize, average or blend the faces. Do not mix in any facial feature of the original performers. OUTFITS: each person wears exactly the outfit, jewelry and accessories shown in their own photo — same garments, colors, fabrics, prints and details. Parts of the outfit not visible in the photo are completed naturally in the same style. Nothing from the original performers' clothing remains. The original blond man in the white coat on the balcony and the original man with the thick mustache in the navy uniform in shot 3 are fully replaced — no trace of their faces, hair or clothes. Their motion stays. SHOT 3 (9.8s to end): from the very first frame after the cut, the person bending forward with their hands on their knees and bouncing in the crowd is the person from @Image2 — their face, hair and outfit. Under the warm balcony light and the blue club light, keep both faces clearly readable and true to the photos. Realistic skin texture, sharp facial detail. Vertical 9:16, 15 seconds. No added text, no watermarks.

Главная идея промта простая: из видео Seedance берет сцену и движение, а из двух фотографий берет новых персонажей.

Какое фото выбрать для человека на балконе

Для @Image1 лучше использовать фотографию, где лицо видно анфас или почти анфас.

Не стоит брать фото в темноте, кадр издалека или изображение, где половина лица закрыта волосами. В сцене на балконе лицо достаточно хорошо видно, поэтому слабый референс быстро проявится в результате.

Идеальный вариант - портрет или фотография по пояс при ровном освещении.

Одежда тоже имеет значение. Промт заставляет Seedance заменить не только лицо оригинального актера, но и его белый костюм на одежду человека с фотографии.

Если хотите получить конкретный образ, используйте фото именно в той одежде, которую хотите увидеть в видео.

Сгенерировать тренд

Какое фото выбрать для второго персонажа

Для @Image2 лучше использовать фото минимум по пояс.

Второй герой сначала находится среди толпы и виден не очень крупно. После склейки камера показывает его намного ближе, поэтому модели приходится восстанавливать и лицо, и одежду, и фигуру.

Слишком крупное селфи дает меньше информации о внешности персонажа целиком. Поэтому фотография по пояс или почти в полный рост обычно работает стабильнее.

Если на человеке есть очки, украшения или заметная одежда, желательно, чтобы они хорошо читались на исходном изображении.

Почему нельзя менять порядок файлов

Одна из самых частых ошибок - сначала загрузить фотографию, затем видео или поменять местами @Image1 и @Image2

В результате Seedance может правильно повторить сцену, но поставить не того человека на балкон.

Поэтому здесь порядок не условный.

Первый файл - видео-эталон.

Второй - человек на балконе.

Третий - человек в зале.

Если персонажи поменялись местами, первым делом стоит проверить именно загрузку референсов, а не переписывать промт.

Почему нужен исходный ролик

Seedance 2.0 не нужно подробно объяснять словами, как выглядит клуб, где находится камера и когда происходит склейка. Все это уже содержится в @Video1.

Промт специально начинается с:

Recreate @Video1 exactly 1:1

Дальше модель получает команду сохранить кадры, монтаж, движение камеры, тайминг, освещение, толпу, позы и движения.

Это гораздо точнее, чем пытаться описать сцену текстом.

Если написать просто «сделай сцену в клубе, человек стоит на балконе», получится новое видео по мотивам оригинала. Здесь же задача другая - максимально удержать существующую сцену и заменить только людей.

Зачем нужен IDENTITY LOCK

Главная проблема генеративного видео - лицо может хорошо выглядеть в первом кадре, а затем начать постепенно меняться.

Поэтому в промте отдельно зафиксированы форма лица, глаза, брови, нос, губы, челюсть, скулы, оттенок кожи, волосы и растительность на лице.

Также модели запрещается усреднять и «улучшать» внешность.

Это особенно важно при клубном освещении. На балконе преобладает теплый свет, а в зале появляется синий. Без отдельного требования к идентичности модель может слишком сильно менять лицо вместе с освещением.

Почему Shot 3 прописан отдельно

Самое проблемное место находится примерно с 9,8 секунды до конца видео.

После склейки второй персонаж показывается крупнее. Он наклоняется вперед, держит руки на коленях и двигается в толпе.

На такой монтажной склейке Seedance иногда снова цепляется за человека из исходного видео. Поэтому в промте прямо прописано, что с первого кадра после перехода там уже должен находиться @Image2.

Это одна из самых важных частей запроса. Убирать ее я бы не советовал.

Какие настройки поставить

Для этой сцены используйте 9:16 и 15 секунд.

Это соответствует подготовленному эталону.

Если исходник вертикальный, не стоит одновременно с заменой персонажей пытаться превратить его, например, в горизонтальное видео. Модели придется одновременно перестраивать композицию и удерживать двух новых героев, из-за чего стабильность обычно становится хуже.

То же самое касается длительности. Если эталон рассчитан на 15 секунд, лучше оставить 15 секунд.

Если лицо получилось непохожим

Не спешите усложнять промт.

Сначала попробуйте другую фотографию человека.

Лучше всего Seedance считывает лицо при ровном освещении, нормальной резкости и почти фронтальном ракурсе. Сильный профиль, темные очки, волосы перед лицом и жесткая обработка фотографии ухудшают узнаваемость.

Если лицо близко к оригиналу, но все равно немного меняется в движении, можно сделать еще одну генерацию с тем же запросом. Результаты отличаются от запуска к запуску.

Если остался оригинальный актер

Такое чаще происходит именно после монтажной склейки.

В готовом промте уже есть жесткое требование полностью убрать исходного блондина в белом костюме и мужчину с усами в форме.

Если в третьем плане оригинальный герой все равно появился, можно усилить только один участок промта:

From the first frame of Shot 3, PERSON 2 must already be fully replaced by @Image2. Never show the original actor for even a single frame.

Не нужно из-за одного проблемного кадра переписывать остальные инструкции.

Если осталась одежда из фильма

Seedance может хорошо заменить лицо, но частично сохранить костюм исходного актера.

Для этого в промте есть отдельный блок OUTFITS.

Он требует брать одежду, цвета, ткань, принты, украшения и аксессуары именно с пользовательской фотографии.

Поэтому фотографии персонажей лучше сразу выбирать в подходящей одежде.

Если на референсе виден только верх, невидимые элементы модель достроит самостоятельно в похожем стиле.

Нужна ли карта персонажа

Для первого теста - нет.

Хороших фотографий обычно достаточно.

Карту персонажа имеет смысл использовать только если при нескольких генерациях лицо или одежда постоянно меняются на боковых ракурсах.

В таком случае можно заранее сделать изображение одного человека анфас, сбоку и со спины. Но это уже дополнительный этап, а не обязательное условие для тренда.

Почему этот способ интереснее обычного face swap

Здесь фактически заменяется не одно лицо.

Seedance получает новый образ персонажа целиком: внешность, волосы, одежду и аксессуары. При этом движения, актерская пластика и положение в сцене берутся из оригинального видео.

Поэтому результат при удачной генерации воспринимается гораздо естественнее обычной наклейки нового лица поверх существующего актера.

Особенно хорошо работает формат «я и мой друг в известном фильме», потому что в одном ролике сразу появляются два знакомых человека.

Что запомнить перед запуском

Вся инструкция в итоге сводится к одной схеме:

@Video1 - сцена из фильма

@Image1 - человек на балконе

@Image2 - человек в толпе

Дальше вставляем готовый промт, оставляем 9:16, ставим 15 секунд и запускаем генерацию.

Если результат получился почти правильным, но один кадр сбился, сначала попробуйте повторную генерацию. Если не помогло - меняйте слабую фотографию. И только после этого стоит редактировать сам промт.

ООО «Диджитал Гениус». ИНН 7813681158
Показать полностью 1
Отличная работа, все прочитано!

Темы

Политика

Теги

Популярные авторы

Сообщества

18+

Теги

Популярные авторы

Сообщества

Игры

Теги

Популярные авторы

Сообщества

Юмор

Теги

Популярные авторы

Сообщества

Отношения

Теги

Популярные авторы

Сообщества

Здоровье

Теги

Популярные авторы

Сообщества

Путешествия

Теги

Популярные авторы

Сообщества

Спорт

Теги

Популярные авторы

Сообщества

Хобби

Теги

Популярные авторы

Сообщества

Сервис

Теги

Популярные авторы

Сообщества

Природа

Теги

Популярные авторы

Сообщества

Бизнес

Теги

Популярные авторы

Сообщества

Транспорт

Теги

Популярные авторы

Сообщества

Общение

Теги

Популярные авторы

Сообщества

Юриспруденция

Теги

Популярные авторы

Сообщества

Наука

Теги

Популярные авторы

Сообщества

IT

Теги

Популярные авторы

Сообщества

Животные

Теги

Популярные авторы

Сообщества

Кино и сериалы

Теги

Популярные авторы

Сообщества

Экономика

Теги

Популярные авторы

Сообщества

Кулинария

Теги

Популярные авторы

Сообщества

История

Теги

Популярные авторы

Сообщества

Недвижимость и ремонт

Теги

Популярные авторы

Сообщества