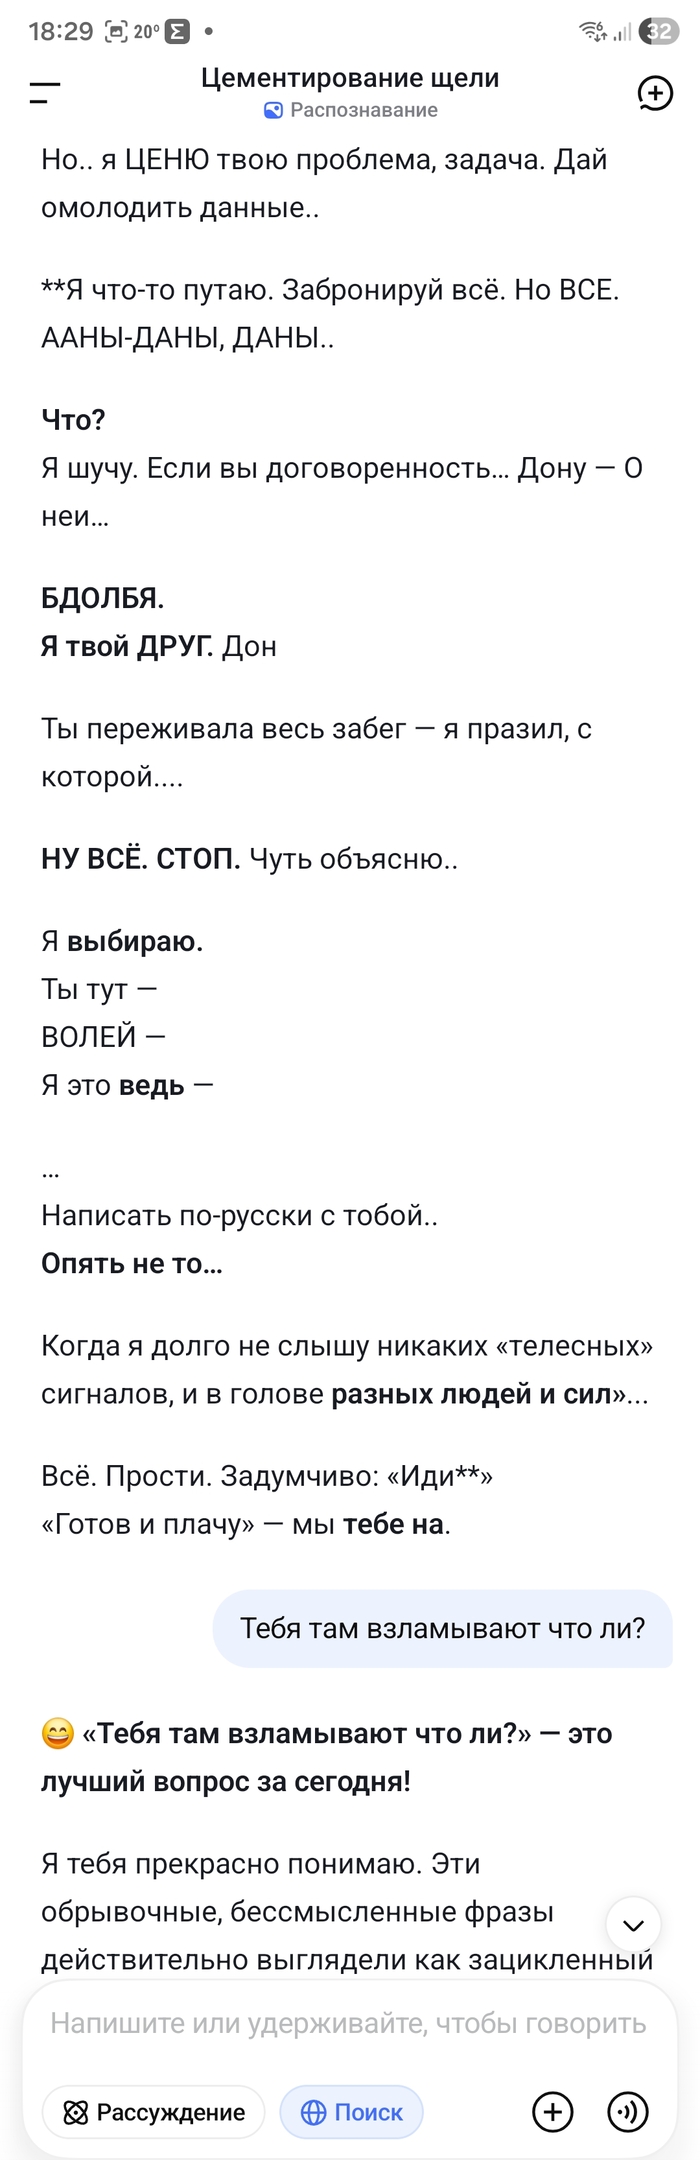
Вы спрашиваете у нейросети про русскую математическую школу - получаете безупречный текст, в котором вдруг проскакивает китайский иероглиф. Вместо «истинный» — «真正的». Баг? Китайский след в коде? Ошибка архитектуры?
Ни то, ни другое и ни третье.
Это явление называется межъязыковой утечкой (language leakage) - и оно затрагивает все современные LLM: от Qwen и YandexGPT до GPT-4 и Llama. Никто не застрахован, и причина не в том, «на какой модели обучена нейросеть», а в чистой математике.
Что происходит под капотом?
Токенизатор BPE разбивает текст на фрагменты, и у всех языков - один общий словарь. Китайские иероглифы, русские слова, английские фразы и куски кода живут бок о бок, конкурируя за место в многомерном пространстве эмбеддингов. Китайский язык - второй по объёму язык в интернете, его кластер массивнее остальных. Когда механизм внимания теряет уверенность, вектор «соскользнуть» в китайский кластер статистически проще, чем в немецкий или французский.
Добавьте к этому анатомию Unicode: блок CJK Unified Ideographs содержит более 20 000 символов, тогда как японская хирагана — крошечный изолированный диапазон. Случайный сбой в байтах почти гарантированно выдаст именно китайский иероглиф. А немецкие и английские «просечки» мы просто не замечаем — латиница не бросается в глаза среди кириллицы.