Samsung начала серийное производство нового корпоративного SSD PM1763, рассчитанного на серверы искусственного интеллекта, HPC-системы и крупные дата-центры. Это один из первых массово выпускаемых корпоративных накопителей компании с интерфейсом PCIe 6.0.
Внутри PM1763 используется фирменная V-NAND девятого поколения и новый контроллер Samsung, изготовленный по 4-нм техпроцессу. В версии объёмом 16 ТБ накопитель обеспечивает скорость последовательного чтения до 28 400 МБ/с, а записи — до 21 900 МБ/с. Это примерно в два раза выше производительности предыдущего PM1753.
Чтобы представить масштаб: Samsung заявляет, что файл или ИИ-модель объёмом 40 ГБ можно передать примерно за 1,4 секунды. При максимальной скорости чтения 100 ГБ данных теоретически проходят примерно за 3,5 секунды. Такие показатели особенно важны для современных ИИ-серверов, где GPU и ускорители постоянно перемещают огромные объёмы данных между памятью и накопителями.
PM1763 оптимизирован для серверов с высокой плотностью компонентов и поддерживает Direct-to-Chip жидкостное охлаждение, позволяющее сохранять высокую производительность при длительных нагрузках. Samsung также заявляет более высокую энергоэффективность по сравнению с предыдущим поколением.
Большое внимание уделено безопасности. Накопитель поддерживает технологии TDISP, SPDM и постквантовую криптографию, что особенно важно для ИИ-инфраструктуры, облачных сервисов и виртуализированных дата-центров.
Samsung уже выпускает PM1763 в вариантах 4, 8 и 16 ТБ, а линейка рассчитана на развитие высокопроизводительных систем хранения следующего поколения. Компания позиционирует SSD как решение для инфраструктуры, где скорость накопителя больше не должна становиться узким местом между процессорами, GPU и огромными ИИ-моделями.
Станет ли PCIe 6.0 новым стандартом для серверных SSD и когда такие скорости появятся в обычных домашних компьютерах?
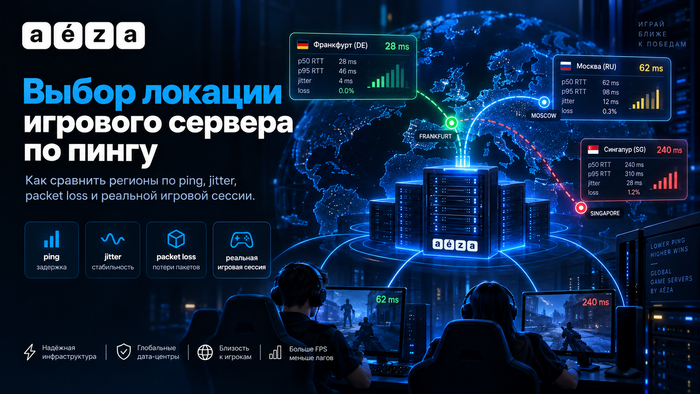
На выбор локации игрового сервера по пингу влияют не расстояния, а сети будущих игроков. Близкий город может проиграть, если пакеты идут к нему через перегруженный стык операторов. Для сравнения нужны несколько сетей, разные часы и пробная игровая сессия, так как служебные запросы ping могут проходить иначе, чем игровой трафик. Замеры проводите не из своей сети, а руками игроков: несколько человек из каждого города и от каждого оператора запускают один и тот же тест, а вы сводите результаты.
Какие тесты задержки провести до выбора локации?
До выбора локации нужны серии ping и трассировки из сетей игроков, затем пробная сессия на игровом сервере. Вместе они помогают оценить задержку, её колебания и потери в разные часы. Ответы на служебные запросы могут отличаться от поведения игрового трафика, поэтому одного ping недостаточно.
Для каких игроков выбираем сервер
Группы игроков различаются страной, городом, оператором и типом подключения. Даже у соседей с разными провайдерами путь до сервера бывает разным. Поэтому мерить нужно из тех сетей, которыми действительно пользуется аудитория. ASN, номер автономной системы, помогает различать сети.
Проверка задержки локации игрового сервера опирается на несколько добровольцев от каждой группы. Их результаты можно хранить под кодами G1-P1 и G1-P2, указав город, оператора и способ подключения. По Wi-Fi игрок меряет то подключение, которым и пользуется. Если результат у него заметно хуже, чем у остальных в группе, отдельный тест по кабелю покажет, дело в домашней сети или в маршруте.
До замеров стоит задать пороги: какая задержка, какая доля потерь и сколько разрывов сессии считаются приемлемыми. Пороги зависят от игры и ожиданий сообщества. Требования должны учитывать каждую значимую группу, ведь хороший средний результат легко скрывает проблемы меньшинства.
Какие серверы сравнивать
Локация должна остаться единственным отличием между кандидатами. У тестовых VM должны совпадать процессорные ресурсы, сетевые ограничения, версия игры и настройки firewall. У перегруженной машины задержки могут быть связаны с ресурсами. Список кандидатов включает доменное имя, фактический IP, игровой порт и срок доступа к стенду.
Провайдеры часто публикуют тестовый IP, по которому можно пинговать площадку до аренды. Этого хватает, чтобы отсеять явно далёкие регионы, но не чтобы выбрать между близкими: у поддержки стоит уточнить, относится ли адрес к нужной площадке и проходит ли через ту же защиту от атак, что будущая VM. Окончательные замеры идут уже на арендованной машине.
Показатели ping, jitter и packet loss отвечают на разные вопросы: как быстро приходит ответ, насколько ровно он приходит и сколько ответов не приходит вовсе. Низкое среднее спокойно уживается с рывками и пропажами. Маршруты IPv4 и IPv6 могут расходиться, поэтому при поддержке обоих протоколов их проверяют отдельно.
Как собрать сопоставимые замеры
Сравнение покажет, какую страну выбрать для VPS, только если каждый участник выполнит один и тот же сценарий для всех кандидатов. Для первого отбора подойдут несколько пятиминутных серий утром, вечером и в часы обычной игры. При близких результатах нужны дополнительные дни наблюдений.
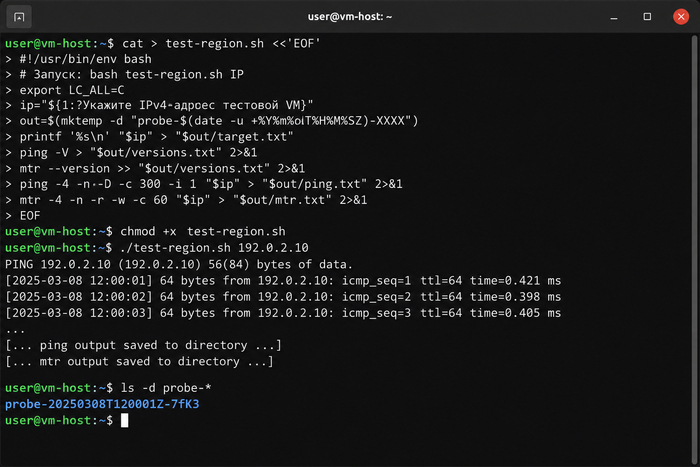
Скрипт рассчитан на Linux с Bash, утилитой ping из пакета iputils и MTR. Код сохраните в test-region.sh. IP в команде запуска – адрес тестовой VM. Результаты и версии утилит попадут в отдельную папку с временем UTC.
Если mtr откажется открывать сокеты, запустите скрипт через sudo, так как на части сборок ему нужны права root.
Ping отправит 300 запросов с интервалом в секунду, затем MTR соберёт отчёт о маршруте. Весь запуск займёт больше пяти минут. Порядок кандидатов между сериями стоит менять, чтобы один регион не проверялся всегда раньше остальных. Параметры команд доступны в документации ping и руководстве MTR.
Насколько jitter и потери важнее среднего ping?
Низкий средний ping не компенсирует частые скачки задержки и потери пакетов. Из-за них данные приходят неровно или не доходят до игры, даже если большинство ответов быстрые. Значимость каждого показателя зависит от механики игры и обработки потерь, поэтому окончательное сравнение требует проверки реальной сессии.
Что означают цифры в отчёте
RTT – время от отправки запроса до получения ответа. Медиана, или p50, делит полученные значения пополам. Показатель p95 отмечает задержку, которую не превышают примерно 95% полученных ответов. Так видны медленные ответы, скрытые за средним. Число запросов и ответов нужно для оценки выборки.
Для единообразия p95 можно считать так: расположить RTT по возрастанию и взять значение на позиции 0,95 × N с округлением вверх, где N означает число ответов. Для уверенных выводов по p99 короткой серии мало. График RTT по времени покажет, собрались ли всплески в один эпизод.
Словом jitter называют разные меры колебания задержки. Здесь это средняя абсолютная разница RTT между соседними запросами, у которых обоих есть ответ. Такой счёт не совпадает ни с mdev из вывода ping, ни с вариацией односторонней задержки по RFC 3393. Сравнивать числа из разных источников нельзя.
Доля запросов без ответа равна (tx − rx) / tx × 100%, где tx и rx означают число запросов и уникальных ответов. Пропуск не превращается ни в нулевой RTT, ни в задержку, равную таймауту. Через looking glass хостинга можно проверить связь со стороны провайдера, но замеры у игроков остаются необходимыми.
Как разобраться в неожиданном маршруте
Если один регион заметно проигрывает, traceroute до игрового сервера поможет увидеть отвечающие промежуточные узлы. MTR повторяет такие пробы и собирает статистику. Отчёты из нескольких сетей за проблемный период покажут, касается ли ухудшение одного оператора или нескольких.
Звёздочки и высокий процент потерь на отдельном промежуточном узле ещё не говорят о том, что он теряет проходящий трафик. Маршрутизатор может ограничивать служебные ответы, продолжая пересылать пакеты. Подозрение становится сильнее, когда ухудшение видно и на конечном адресе. Причину сбоя должен подтвердить оператор.
Названия узлов могут подсказать транзит через другой город, хотя география по имени или базе IP бывает неточной. Обратная трассировка с сервера до доступного адреса игрока добавит сведения о другом направлении. Прямой и обратный пути могут различаться, а RTT включает оба. Недоступный из-за NAT домашний адрес ограничивает такую проверку.
Проверка в самой игре
После сетевых проб нужна игровая сессия на каждом кандидате. У серверов должны совпадать версия игры, модификации, карта и настройки. Участникам лучше повторить похожие действия при одинаковом числе игроков. В отчёт пойдут задержка из клиента, разрывы соединения и доступные показатели потерь. У отдельных игр встроенный ping включает особенности обработки и сглаживания, поэтому он не обязан совпадать с ICMP RTT.
Нагрузка VM требует отдельного наблюдения. Например, в Minecraft MSPT означает миллисекунды на такт, а FPS относится к частоте кадров клиента. Медленные такты или падение FPS способны испортить игру при нормальной сети, поэтому эти показатели должны храниться отдельно от RTT.
Защита от DDoS может менять путь трафика. Часть провайдеров заворачивает его в центр очистки – выделенную площадку, где пакеты фильтруются и только потом идут к серверу. Другие фильтруют прямо на пограничных узлах, и тогда заметного крюка не появляется. Возможность теста нужно согласовать с провайдером, без самостоятельной организации атак. После известного включения или изменения фильтрации полезно повторить игровую сессию и сетевые пробы.
Почему ближайший на карте регион может оказаться медленнее?
1. Обмен трафиком между операторами, или peering, может идти через удалённую точку.
2. Перегруженный участок пути добавляет ожидание, даже если расстояние небольшое.
3. Фильтрация трафика может менять маршрут до сервера и увеличивать задержку.
Как выбрать по результатам
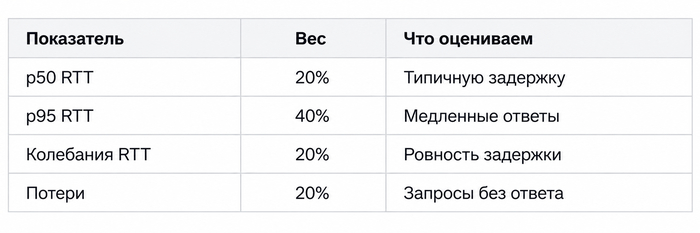
В таблице отдельная строка на каждое сочетание группы, кандидата и времени теста: удачный дневной запуск не должен скрыть плохой вечерний. Колонок четыре – p50, p95, колебания RTT и потери.
В сводном CSV поле group связывает строку с городом и оператором, trace хранит имя файла трассировки, game содержит итог пробной сессии.
Поле player хранит условный код участника. Задержки заданы в мс, loss в процентах. Одна строка соответствует одной серии. Общий p95 нельзя получить усреднением p95 участников.
Кандидаты с нарушениями обязательных требований значимой группы выбывают из сравнения. Остальные получают оценки показателей по заранее заданной шкале, например от 0 до 5, где 5 означает лучший результат. Веса определяются до расчёта, ниже приведён пример для адаптации к своей игре.
Оценка каждого показателя умножается на его вес, а сумма даёт балл группы. Баллы групп учитываются пропорционально их доле в аудитории. При близких баллах решает стабильность маршрута: routing path, который меняет транзитного оператора от серии к серии, рискованнее ровного пути даже при равном p95. Учитывается и доступность измерительных endpoints, поскольку регион, который нечем перепроверить после запуска, теряет в надёжности сравнения. Если общего подходящего региона нет, стоит оценить несколько серверов для разных групп.
Когда повторять тесты
После запуска те же участники и тот же сценарий помогут проверить качество на постоянном IP. Новые замеры нужны после смены адреса, провайдера, настроек фильтрации или появления жалоб из конкретной сети.
География игроков тоже меняется. Новая большая группа может изменить выбор даже при прежнем качестве маршрутов. Поэтому список городов, операторов и долей активных участников нуждается в обновлении.
У отчёта должны быть автор, даты и часовой пояс, тестовые адреса, конфигурация VM, версии утилит и игры. Сводный CSV без сырых данных не перепроверить, поэтому рядом сохраняют ряды RTT, трассировки и заметки об игре. Перед публикацией из журналов удаляют домашние IP и другие личные данные. Рядом с выводом укажите дату замеров. Маршрутизация меняется, и вывод стареет вместе с ней.
Выбор локации игрового сервера по пингу заканчивается решением с понятными условиями: для каких групп подходит регион, где остаются ограничения и когда проходила проверка. При близких результатах стоит продлить тест. До окончательного переноса стоит сохранить возможность вернуться на прежнюю площадку, если новый маршрут окажется нестабильным
Pеклама. ООО «Аеза Групп», ИНН: 7813654490. erid:2RanynGWvZy
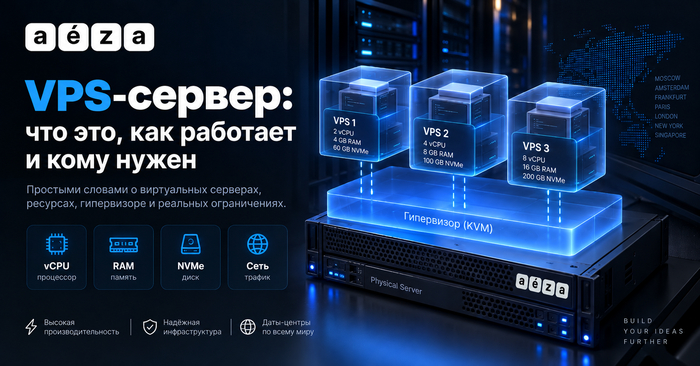
VPS-сервер даёт отдельную ОС и административный доступ без аренды целого физического узла. Такой формат подходит сервисам с постоянным адресом и предсказуемой нагрузкой. При выборе такого сервера важны технология виртуализации, ограничения CPU, памяти, диска и сети, а также то, где проходит граница ответственности. У двух тарифов с одинаковым описанием эти условия могут конкретно отличаться.
Что такое VPS простыми словами?
VPS это виртуальная машина с гостевой ОС, которую физический хост запускает через гипервизор. Пользователь получает административный доступ, IP-адрес, виртуальные диски и заданные лимиты ресурсов, а провайдер обслуживает физический хост и слой виртуализации. Реальная изоляция и гарантии зависят от технологии виртуализации, модели распределения и условий тарифа.
Что входит в услугу и что остаётся вашей задачей
Физический сервер делят на несколько виртуальных машин, каждая из которых запускает собственное ядро ОС, хранит отдельную файловую систему и работает со своими пользователями, процессами и сетевыми настройками. Процессы одной машины не видят файлы и память другой, хотя оборудование у всех гостей общее.
Тариф VPS обычно включает vCPU, RAM, диск, IP-адрес, лимит трафика либо скорость порта. Панель провайдера управляет питанием виртуальной машины, переустановкой образа и консолью. Она не заменит вашу работу внутри ОС: веб-сервер, база данных, обновления, учётные записи и резервные копии остаются задачей администратора, если договор не обещает иное.
Административный доступ даёт свободу выбора ПО, но вместе с ней и всю ответственность за то, что внутри: ошибка в условном sshd_config, открытая база данных или удалённый файл находятся внутри гостевой системы, поэтому просто наличие гипервизора их не исправит. Перед заказом нужно проверить, кто устанавливает обновления, реагирует на инциденты и восстанавливает данные.
Как гипервизор создаёт несколько серверов на одном хосте
На Linux-хосте модуль KVM использует аппаратные расширения CPU и открывает пользовательскому пространству API для работы с виртуальными машинами. Каждая VM обычно работает как отдельный процесс QEMU. Он выполняет код гостя через KVM и предоставляет модель устройств. Слой управления, обычно libvirt, задаёт vCPU, память, диски, сетевые интерфейсы и правила запуска. Созданный таким способом VPS сервер видит виртуальное оборудование и загружает собственную ОС как отдельную машину.
Схема этих слоёв такая:
CPU, RAM, NVMe и NIC физического хоста → ядро Linux с KVM → процесс QEMU и virtio-устройства → гостевая ОС → приложение
Планировщик хоста выделяет каждой vCPU процессорное время наравне с потоками других виртуальных машин, а закрепление за физическим ядром, квоты и оверкоммит зависят от конфигурации площадки. С памятью и устройствами так же, то есть гость работает не с железом напрямую, а с тем, что даёт ему процесс QEMU. Память живёт в его адресном пространстве, дисковые и сетевые операции идут через паравиртуальные очереди virtio.
Изоляция действует на уровне виртуальной машины, а физические CPU, накопители и сеть остаются общими. Поэтому для сравнения вариантов обычно нужны правила распределения ресурсов и тест на своей нагрузке, потому что просто факта наличия гипервизора недостаточно.
Что означают vCPU, RAM, NVMe, IOPS и полоса сети
Число vCPU показывает, сколько виртуальных процессоров видит гостевая ОС. Частоту, поколение CPU, квоту процессорного времени и степень конкуренции на хосте нужно выяснять отдельно. Для постоянной вычислительной нагрузки важны длительная производительность и задержка планирования. В Linux показатель %steal показывает время, когда гостевая vCPU была готова к работе, но гипервизор не дал ей процессор. Причину замедления одна эта метрика не покажет.
Объём RAM задаёт доступную гостю память. Поведение при её нехватке зависит от гарантий тарифа, ballooning, политики оверкоммита и swap на хосте. Частая выгрузка страниц увеличивает задержки, поэтому базе данных полезнее гарантированный объём с запасом под рабочий набор, чем большое номинальное число без условий.
NVMe обозначает протокол доступа к накопителю. Производительность определяют лимиты IOPS и throughput, размер блока, глубина очереди, доля чтения и записи. На результат также влияют кэширование и конкуренция. Лимит в 3000 IOPS при блоке 4 КиБ даёт примерно 11,7 МиБ/с случайного потока. Реальная цифра будет ниже из-за файловой системы и очередей, а последовательное чтение ограничит уже лимит throughput.
У сети есть несколько границ: скорость порта, трафик, пакеты в секунду, исходящий лимит и маршрут до пользователей. В тарифах Cloud VPS обычно есть API, почасовое создание ресурсов и сетевые сервисы. Но сможете ли вы быстро добавить ресурсы в пик и есть ли под это физический резерв – зависит от договора, а не от названия тарифа.
Чем VPS отличается от виртуального хостинга и выделенного сервера?
VPS даёт собственную ОС, административный доступ и лимиты ресурсов, тогда как виртуальный хостинг делит готовое окружение без полного контроля. Выделенный сервер предоставляет весь физический узел одному клиенту. Managed-тарифы и гарантии CPU, памяти или диска у разных поставщиков могут заметно различаться.
Unmanaged, managed и панели: кто за что отвечает
В unmanaged-тарифе провайдер обычно обслуживает физический хост, гипервизор, питание и внешнюю сеть, а пользователь управляет гостевой ОС: создаёт учётные записи, устанавливает пакеты, закрывает порты, следит за журналами и обновляет приложения. Точные границы ответственности задаёт договор, особенно для DDoS-защиты, резервных копий и аварийного доступа.
В managed-тарифе часть операций берёт на себя поставщик, но точный состав услуги всё ещё определяет договор. Базовый вариант может включать только первичную установку, а расширенный добавляет мониторинг, обновления, реакцию на алерты и восстановление. До заказа стоит проверить часы работы поддержки, допустимый стек, число обращений, способ эскалации и перечень действий при сбое.
Панель управления упрощает работу с доменами, сертификатами, почтой, базами и веб-серверами. Даже полностью настроенный VPS не становится managed-сервисом, если никто не отвечает за обновления, резервирование и ночные инциденты. Снапшоты тоже не равны полноценной резервной копии, так как они могут находиться на той же платформе и не подтверждают корректное восстановление приложения.
Проще всего свести всё это в одну таблицу и посмотреть, где не окажется владельца. В строках – ОС, firewall, приложения, мониторинг, копии и восстановление, в столбцах – кто отвечает, за какой срок реагирует и каким пунктом договора это закреплено. Ярлык managed становится проверяемым только после того, как такая таблица заполнена целиком.
Для чего используют VPS и где он не подходит
Небольшие сайты, API, боты, системы мониторинга, Git-раннеры и тестовые среды часто помещаются на одной виртуальной машине. Им нужен постоянный IP-адрес, контроль пакетов и возможность запускать фоновые процессы. При умеренном рабочем наборе такой VPS сервер проще в эксплуатации, чем выделенный узел, а тариф можно сменить после измерений.
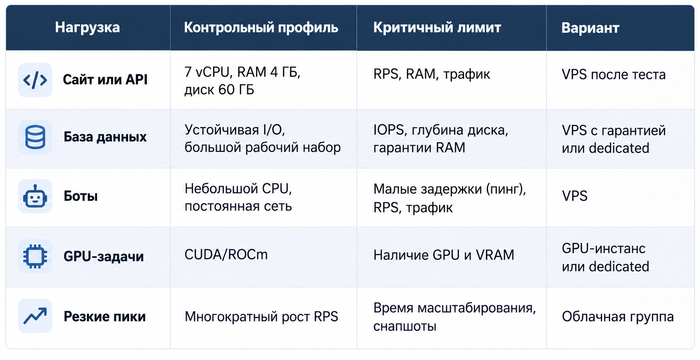
У тяжёлой базы данных постоянная загрузка vCPU, большой объём RAM и интенсивная запись, поэтому конкуренция за общие ресурсы бьёт по ней сильнее всего. Обучение и инференс упираются в ускоритель, а обычный тариф VPS его не включает. Сервису с резкими пиками может больше подойти облачная группа экземпляров.
В таблице собраны типовые варианты. Числа здесь – отправная точка для теста, проверять их всё равно нужно на своей нагрузке.
Проверять всё равно придётся прогоном, так как приложение с 2 vCPU и 4 ГиБ RAM может работать устойчиво при одном профиле запросов и упираться в память при другом. Решение обычно принимают по рабочему набору, p95/p99 задержки, очередям диска и запасу до лимитов.
Как подобрать тариф без переплаты за лишние ядра
Выбор начинается с измерений текущей системы. Для CPU нужны загрузка по ядрам, длительность насыщения и задержка запросов, для памяти – рабочий набор, page faults и swap. Диск оценивают по IOPS, throughput и p95/p99 latency, сеть по средней и пиковой скорости, PPS и исходящему трафику. Если исходной системы нет, начните с минимального тарифа и прогоните воспроизводимый тест. Если упрётесь в лимит, увеличьте только тот ресурс, который его создал, и повторите замер.
Например, тариф может включать 2 vCPU, 4 ГиБ RAM, 60 ГиБ диска, 3000 IOPS и порт 100 Мбит/с. Без модели CPU, квоты, типа диска, лимита throughput и правил трафика этих цифр недостаточно для оценки. VPS или VDS сервер в названии тарифа тоже ничего не говорит о способе виртуализации, поэтому смотреть нужно договор и технические параметры.
Базовый профиль после запуска составляют по данным за обычный рабочий период. В него входят загрузка CPU, %steal, свободная память, swap, дисковая задержка, ошибки файловой системы, сетевые потери и прикладные p95/p99. Переход на более крупный тариф логичен, если ресурс регулярно приближается к лимиту, а одновременно растут задержки или число ошибок. Обычный короткий пик не требует постоянной оплаты лишних ресурсов.
Расположение площадки определяет задержку до пользователей, а иногда и то, где по закону можно хранить данные. В условиях резервного копирования должны быть названы частота, срок хранения, место размещения и время восстановления. До миграции также важно узнать, как увеличивается диск, меняется тариф, выдаются адреса и выполняется перенос между регионами.
Для каких задач подходит VPS?
Сайты, API и небольшие базы с измеримым и относительно стабильным профилем нагрузки.
Боты, мониторинг, Git-раннеры и тестовые среды, которым нужен постоянный сетевой узел.
Сервисы с собственной ОС и административным доступом, если их лимиты подтверждены тестом.
Что настроить сразу и чего провайдер не сделает за вас
При первом подключении SSH-отпечаток желательно сверить через доверенный канал. Затем нужно создать отдельную учётную запись, добавить публичный ключ и проверить новый вход. Парольную авторизацию и прямой вход root лучше отключить, но только при наличии рабочего ключа и резервного доступа через консоль.
Firewall открывает лишь необходимые входящие порты, пакеты ОС и приложений обновляются по выбранному графику, а сервисы работают с минимальными привилегиями. Стоит иметь в виду, что VPS изолирует машину, а не код внутри неё. Уязвимый плагин, утёкший токен или ошибочное правило доступа остаются вашей зоной ответственности.
Резервная копия должна пережить потерю виртуальной машины и учётной записи управления, поэтому данные хранят отдельно, шифруют и периодически восстанавливают в чистое окружение. Успешный статус задания подтверждает создание копии, а тест восстановления показывает её пригодность.
Система мониторинга должна сообщать о заполнении диска, остановке сервиса, росте ошибок и скором окончании сертификата до обращения пользователя. Для критичного узла нужна короткая инструкция: как попасть через консоль, где лежат копии, кто принимает решение об откате и какой результат означает восстановление.
VPS, VDS, облако и dedicated: как выбрать модель
VPS и VDS на рынке часто используются как близкие маркетинговые названия, поэтому сами буквы не указывают на то, выделены ли ядра, разрешён ли оверкоммит и какие лимиты действуют для диска. Если нужен виртуальный сервер VPS с предсказуемой производительностью, проверять следует модель CPU, квоты, гарантии памяти, IOPS, полосу сети и SLA, а не то, что написано в карточке тарифа.
Публичное облако полезно, когда инфраструктуру нужно создавать через API, распределять по зонам и связывать с балансировщиками или управляемыми сервисами. Расчёт стоимости у такой модели сложнее, а зависимость от платформы выше. Один экземпляр без резервирования остаётся точкой отказа.
Dedicated-сервер резервирует весь физический узел для одного клиента и подходит для длительной высокой загрузки, крупной локальной базы или специальных накопителей. Вместе с ресурсами владелец получает более медленное масштабирование и дополнительные задачи по отказоустойчивости. Виртуальный хостинг снимает большую часть администрирования, но не даёт ни собственного ядра, ни полного контроля сети.
Если ресурсы стабильно упираются в лимит, следующий шаг – более крупный тариф или переход на dedicated. При непредсказуемых пиках и работе в нескольких зонах выигрывает облако. Когда заниматься администрированием ОС некогда или незачем, задачу закрывает managed-платформа. Выбор определяют требования к контролю, скорости восстановления и цене простоя.
VPS-сервер будет оправдан, когда проекту нужны постоянный сетевой узел, собственная ОС и контроль конфигурации, а отдельный физический хост пока избыточен. Перед оплатой параметры тарифа нужно сверить с границей ответственности и планом восстановления. Если тест подтверждает, что нагрузка укладывается в лимиты, а по данным мониторинга остаётся запас ресурсов, виртуальная машина решает задачу без лишней инфраструктуры.
Pеклама. ООО «Аеза Групп», ИНН: 7813654490. erid:2RanymCFSjV
Почти всем нам нужен мессенджер на телефоне. Причем такой, чтобы не плясать вокруг него с бубном, то прокси сервер надо искать, то один не работает и другой не работает, то сначала работает, а потом не работает. То ВПH искать, и платить еще за него. Меня такая концепция не устраивала и с стал думать над выходом из сложившейся ситуации.
Макс я ставить не хотел, т.к. активно использую API и мне надо иметь возможность отправки сообщений при помощи http запросов. Шлю себе сообщения из программы на 1с.
Постепенно мои поиски оформились в желание иметь такой мессенджер, который бы работал НА МОЕМ СЕРВЕРЕ. Чтобы послать в одно далекое место все роскомнадзоры с их ограничениями. Так что бы
я был полным хозяином моего собственного мессенджера и мог рулить им как угодно:
- добавлять и удалять пользователей
- отправлять кому угодно и что угодно
- смотреть логи, т.е. кто что и кому слал
- возможность тиражирования
И мои поиски увенчались успехом, я вычитал про мессенджер Rocket chat. Это как раз было то что надо.
Установка и начало работы с Rocket chat
Rocket chat ставится на Ubuntu (бесплатная операционная система!) сервер. Ну или на другие похожие, но мне как-то убунту ближе. Сразу скажу, что все поставить и запустить это очень прямо не просто. Может быть я конечно еще тот ламер, но у меня это почти месяц заняло. Расскажу подробнее.
1. Способ установки. Ставить Rocket chat можно разными способами. Или просто скачать пакет
или ставить его в контейнер docker. Я выбрал сначала первый способ. Причем на момент установки версия Rocket chat уже ушла вперед, а я-то этого не знал! В итоге поставил старую, которая работать у меня отказалась, пришлось все обнулять, думать, и переставлять уже на новую. Причем поначалу у меня ну никак не хотели работать уведомления. Т.е. сообщение приходило, но телефон молчал. Ни настройки андроида, ни настройки самого Rocket chat не помогали. Починить это удалось лишь после обновления Rocket chat на версию 8.8.0.
2. Дополнительное ПО. Rocket chat работает совместно с базой данных MongoDB. И не все версии Rocket chat подходят к разным версиям этой БД. А еще есть обратный прокси сервер Nginx. Он тоже нужен для Rocket chat. Причем тоже не все версии подходят. В общем, я плутал в трех соснах несколько дней, пока в итоге не нашел рабочую связку. У меня заработала отправка сообщений, фото, аудиофайлов.
3. Настройка аудио и видио звонков.
Для этого используется бесплатная программа jitsi. Это сервер видеоконференций. и Rocket chat может работать с ней совместно. Причем в Rocket chat есть такая штука "магазин приложений". Там тьма всяких допов и интеграций. Даже типа шлюза к Whatsapp и Telegramm. Так вот из этого магазина прямо в web интерфейсе Rocket chat и ставится (бесплатно) jitsi. Но тут есть один очень важный нюанс.Если эту самую джитси просто так поставить и даже все настроить, то видеозвонки как бы получаются, но работают они через официальный сервер jitsi а там есть авторизация, приходится при каждом звонке выбирать модератора, всем вводить пароли от google аккаунтов, это все долго, и в итоге это полная хрень. Но есть решение!!! Надо поставить свой jitsi сервер! А уж в моем сервере я все могу настроить как угодно. Или вообще отключить авторизацию (что опасно, т.к. сервер висит в инете, могут найтись желающие нахаляву через него пообщаться) или есть еще возможность настроить Rocket chat так чтобы он сам авторизовался уже на моем сервере jitsi, для чего и там и тут я задаю логины и пароли.
Вот тогда наступает кайф, ты звонишь пользователю Rocket chat, у него раздается звонок и и все,
начинаете разговор. Причем это все реально работает. Отдельная тема, это отправка сообщений в Rocket chat из 1С. Сделать это было точно можно, но информации в инете кот наплакал. Но в итоге, я все-таки написал в коде 1С несколько функций:
- отправка сообщения боту
- отправка сообщения пользователю в личку
- отправка web ссылки
- отправка фото
- отправка документа
Тут тоже возникала просто тьма сложностей. ИИ от гугла хотя мне сильно помог, но ответы на мои вопросы и примеры кода у него немного неправильные ВСЕГДА. Это наверное фишка такая. Всегда после ИИ приходилось все переделывать и дорабатывать. Хотя оснвные идеи он выдает годные. Вся работа идет через HTTP запросы. Для некоторых сложных случаев пришлось запускать сниффер трафика fiddler и ловить что моя 1с передает и что Rocket chat ей отвечает, чтобы понять где у меня затык. Но в итоге все более менее заработало. Также огромную сложность вызвало у меня установка Rocket chat и jitsi на один сервер. Т.к. и то и это хочет отдельный домен. В итоге заработало на разных портах. Rocket chat на 443 https порту, а jitsi на 8443. Так что оба работают уже в контейнерах docker и друг другу не мешают.
Вот что я в итоге поимел:
1. Свой личный мессенджер (по функционалу сравнимый с telegramm)
2. Его точно никто мне не отключит и не заблокирует
3. Клиенты работают где угодно (андроид, айфоны, windows)
4. Можно слать сообщения, файлы, делать видеозвонки
5. Отлично принимает сообщения (в т.ч. и конкретному пользователю) из 1С
Расширили линейку выделенных серверов в Москве с 22 до 187 конфигураций. Теперь подобрать сервер под нужную задачу можно еще точнее.
➖ Ходовые Intel Xeon E3, E5 и E-серии, Intel Core i7 и i9, AMD Ryzen 9 на DDR5. Под сайты, приложения, dev-стенды и 1С, где важна высокая частота ядер.
➖ Двухсокетные Intel Xeon Scalable Silver. Под виртуализацию, средние базы и все, где нужно много памяти и потоков.
➖ Мощные двух- и четырехсокетные Intel Xeon Gold 6230R, 6240 и 6330. Под тяжелые базы, большую аналитику и крупные проекты.
Чек-лист харденинга SSH помогает убрать лишние способы входа на VPS. Харденингом называют настройку защиты сервера. Безопасная настройка sshd_config сводится к тому, чтобы оставить один проверенный способ входа и уметь вернуть доступ, если что-то пойдёт не так.
Примеры рассчитаны на Ubuntu 24.04 LTS с OpenSSH из репозитория ОС. Параметры для другой ОС и требования аудита лучше заранее уточнить.
Какие параметры sshd_config важнее всего для аудита?
Основные параметры: PermitRootLogin для входа под root, PasswordAuthentication и KbdInteractiveAuthentication для способов проверки пользователя, AllowUsers или AllowGroups для ограничения круга пользователей. При многофакторной аутентификации важен AuthenticationMethods, который задаёт обязательные способы подтверждения входа. Результат настройки проверяют реальными попытками разрешённого и запрещённого входа.
Что именно нужно защитить
Безопасная настройка sshd_config начинается со списка тех, кому нужен SSH: владельца VPS, коллег, программы резервного копирования.
Пароль могут подобрать, ключ могут украсть, а доступ бывшего сотрудника иногда остаётся действующим месяцами. Вход только по ключам исключает подбор пароля. Украденный ключ нужно отозвать, а лишние учётные записи закрыть. Второй фактор, например одноразовый код, снижает риск входа с украденным ключом. Отдельная угроза – потеря журналов: если записи о входах хранятся только на самом сервере, злоумышленник с правами root может их изменить, и восстановить картину будет нечем.
Ошибка в настройках может закрыть вход самому администратору. До изменений проверьте, что консоль провайдера даёт доступ к файлам с правами администратора. В команде при необходимости назначьте ответственного за эту проверку.
Какие настройки сервер действительно использует
В чек-лист аудита SSH внесите версии ОС и OpenSSH, исходные настройки. Их покажут команды на сервере:
В Ubuntu файл /etc/ssh/sshd_config подключает через Include файлы из /etc/ssh/sshd_config.d/. Обычно действует первое прочитанное значение, а порядок чтения определяется именами файлов. Поэтому правка в конце основного файла может не сработать. Подробности есть в документации Ubuntu.
Блоки Match задают исключения для пользователей и адресов. Параметр -C учитывает их для конкретного подключения:
sudo /usr/sbin/sshd -T \ -C user=admin,addr=198.51.100.10,host=client.example sudo ss -ltnp
Подставьте своего пользователя, IP и имя клиента. Если Match содержит условия на адрес и порт сервера, укажите их через laddr и lport. Вывод -T показывает то, что записано в файлах на диске. Уже открытые сеансы продолжают работать по прежним настройкам, поэтому проверять изменения нужно новым подключением. Слушающие порты покажет команда ss, а её вывод стоит сверить с правилами межсетевого экрана на VPS и в панели провайдера.
Кому принадлежат учётные записи и ключи
Составьте список всех учётных записей, которые могут войти и выполнять команды. Отдельно отметьте тех, кто может выполнять команды от имени администратора через sudo. В authorized_keys хранятся разрешённые открытые ключи. У каждого должен быть известен владелец, потому что подпись рядом с ключом ещё не подтверждает его личность. Отключение входа по паролю SSH лучше делать только после того, как этот список собран.
Личные аккаунты помогают различать администраторов в журнале. Программе резервного копирования выделите отдельный ключ. Параметр command= в authorized_keys ограничивает его заданной командой, а restrict отключает дополнительные возможности, включая туннели. После настройки по справке OpenSSH убедитесь, что копирование работает.
При плановой замене ключа сначала проверьте новый, затем удалите старый со всех серверов. Удаление ключа не завершает открытые сеансы, поэтому при краже их придётся проверить отдельно.
Как отключить вход по паролю и не потерять доступ?
Сначала войдите по ключу под отдельным пользователем с sudo в новом SSH-сеансе и оставьте старое подключение открытым. До применения изменений проверьте конфигурацию, доступ через консоль провайдера и порядок отката. После применения повторите вход. Если используется многофакторная аутентификация, проверьте также работу второго фактора.
Какие способы входа оставить
Следующий пример разрешает вход только по ключам. Вместо admin укажите имя пользователя, под которым вы уже проверили вход и sudo:
# Вход только по ключу; без второго фактора через PAM PubkeyAuthentication yes AuthenticationMethods publickey PermitRootLogin no PasswordAuthentication no KbdInteractiveAuthentication no AllowUsers admin
В AllowUsers включите всех нужных пользователей и служебные аккаунты. Если удобнее управлять группой, вместо списка имён можно использовать AllowGroups. MFA и allowlist для SSH работают вместе: список ограничивает круг пользователей, второй фактор защищает от украденного ключа.
Параметр PermitRootLogin со значением no запрещает прямой вход под root. Значение prohibit-password сохраняет вход root по ключу.
Для ключа и одноразового кода через PAM, систему аутентификации Linux, нужны другие значения. Прежние значения замените следующими, а UsePAM добавьте, если его ещё нет:
Такая многофакторная аутентификация (MFA) работает лишь с заранее настроенным PAM-модулем. Сам keyboard-interactive может запрашивать обычный пароль. Поэтому одного PasswordAuthentication no недостаточно для запрета всех способов парольного входа.Как применить изменения и вернуться назад
До правок проверьте вход по ключу в новом соединении. На своём компьютере выполните команду со своим логином и адресом VPS:
Команда создаёт новое соединение и допускает только вход по ключу. Для MFA через PAM укажите в PreferredAuthentications publickey,keyboard-interactive. В новом сеансе проверьте sudo. Старый оставьте открытым.
В этом примере меняется только новый файл /etc/ssh/sshd_config.d/00-local-access.conf. Это имя и имя с окончанием .disabled должны быть свободны. Сохраните вывод -T до правок. После них убедитесь, что нужные значения действуют для каждого условия Match.
Сначала выясните, как запущен SSH. Команда systemctl is-enabled ssh.socket покажет, включена ли активация через сокет. В Ubuntu она включена по умолчанию с версии 22.10. sshd не работает постоянно, а поднимается на каждое входящее соединение и читает конфигурацию заново, поэтому reload не нужен, достаточно открыть новый сеанс. Если сокет отключён и работает постоянная служба, изменения применяет reload:
Проверка -t при успехе ничего не печатает. При ошибке команда после && не выполнится. Запрет root login и остальные ограничения проверяют попытками входа: повторите вход по ключу, проверку sudo и попытки запрещённого входа.
Для отката в старом сеансе или консоли переименуйте файл, после этого он не попадает под маску *.conf.
Этот откат относится только к новому файлу. PAM, межсетевой экран и порт меняйте отдельно, с собственными командами возврата. Старый сеанс закройте лишь после всех проверок.
Что делать с туннелями и алгоритмами
Безопасность SSH на VPS зависит и от возможностей после входа. Например, SSH-туннель передаёт трафик другой программы через зашифрованное соединение.
AllowTcpForwarding управляет TCP-туннелями. X11Forwarding разрешает вывод окон серверных программ на компьютер пользователя. AllowAgentForwarding даёт доступ через сервер к агенту с ключами на компьютере пользователя. Ненужные возможности стоит отключить. При этом пользователь с командной оболочкой может обойти запрет туннелей собственной программой пересылки трафика.
В поддерживаемой версии OpenSSH начните с настроек по умолчанию. Перед изменением списка шифров нужна проверка клиентов. Обновления лучше устанавливать регулярно.
MaxAuthTries ограничивает попытки входа в одном соединении. При слишком низком значении клиент может не успеть предложить подходящий ключ. ClientAliveInterval задаёт интервал проверки связи с клиентом. Пауза в наборе команд сама по себе не приводит к отключению.
Достаточно ли Fail2ban и нестандартного порта?
Нет, этих мер мало.
1. На другом порту обычно меньше автоматических попыток входа, но сканирование всё равно его найдёт.
2. Блокировка адресов за неудачные входы сдерживает перебор, однако украденный рабочий ключ пройдёт проверку с первой попытки.
3. Нужны контроль ключей и пользователей, ограничения доступа, обновления и журналы, а второй фактор выбирают с учётом рисков.
Как ограничить сеть и сохранить события входа
Межсетевой экран может принимать SSH только с адресов администраторов. Проверьте вход из разрешённой и посторонней сети, включая IPv6, если он используется.
Fail2ban временно блокирует адреса после серии неудачных входов. После установки убедитесь, что он читает журнал SSH и применяет блокировки. Тестовые попытки входа тоже могут привести к блокировке вашего IP.
Журнал должен содержать успешные входы, отказы и административные действия через sudo. Недавние записи в Ubuntu можно посмотреть так:
Злоумышленник с правами root может изменить локальный журнал. Копия на отдельном сервере поможет восстановить события. Убедитесь, что записи действительно туда попадают, время на обеих машинах синхронизировано по NTP, а журналы хранятся столько, сколько требует ваш аудит. Администраторам VPS не нужны права удаления этой копии.
Как подтвердить результат проверки
Отчёт содержит версии ОС и OpenSSH, список подключённых файлов, перечень пользователей и ключей, настройки до и после правок. К сравнению файлов до и после правок (diff) добавьте причины изменений. Приватные ключи и секреты второго фактора в отчёт входить не должны. Собранные файлы и результаты тестов и есть audit evidence, которое запросит аудитор.
В таблице ниже указаны ожидаемые результаты. Каждый сценарий нужно проверить на своём сервере:
Администратор из AllowUsers с верным ключом: вход и работа sudo
Тот же пользователь только с паролем: отказ во входе
Root с верным ключом: отказ во входе
Пользователь вне AllowUsers с верным ключом: отказ во входе
Подключение из запрещённой сети при настроенном межсетевом экране: блокировка межсетевым экраном
Возврат прежней конфигурации: новый вход по прежним правилам
Для проверки парольного входа выполните на своём компьютере:
Этот тест отключает ключи. Пользователя вне AllowUsers проверяйте с верным ключом, иначе причина отказа останется неясной. При MFA нужны попытки с верным, неверным и пропущенным кодом.
Рядом с результатом укажите дату, своё имя, адрес клиента и запись в журнале. Сетевую блокировку можно подтвердить ростом счётчика нужного правила межсетевого экрана. После обновлений и изменений в команде повторите проверку доступа.
Хороший результат выглядит просто: разрешённый пользователь входит, запрещённые сценарии получают отказ, а откат проверен заранее и не зависит от того, работает ли SSH. Чек-лист харденинга SSH храните вместе с инструкцией восстановления доступа. У каждого исключения должны быть причина, владелец и дата пересмотра. Так следующий администратор сможет отличить рабочую необходимость от забытой временной настройки.
Pеклама. ООО «Аеза Групп», ИНН: 7813654490. erid:2Ranyo42g59
Облачный сервер часто выглядит как привычный VPS: вы выбираете процессор, память и диск, получаете адрес и заходите по SSH. Разница становится заметной, когда нужно быстро добавить серверы, заменить сломавшийся экземпляр или подключить отдельное хранилище. Эти возможности стоит оценить перед переездом.
Настройка облачных серверов затрагивает сеть, права доступа и хранение данных. На платформе с отдельными сервисами это может потребовать больше работы, чем на привычном VPS. При этом единственная машина остаётся точкой отказа: если она недоступна, приложение тоже перестанет отвечать.
Чем облачный сервер отличается от VPS?
Облачный сервер обычно работает в составе платформы с программным управлением машинами, хранилищами и сетями. С её помощью проще создавать ресурсы и менять их количество вслед за нагрузкой. У VPS тоже бывают API (интерфейс программного управления) и почасовая оплата, поэтому различия нужно искать в условиях конкретных услуг.
Что скрывается за названиями VPS и облако
VPS называют виртуальную машину со своей операционной системой и назначенными ей ресурсами физического сервера. В облаке такую машину часто называют инстансом. Обе услуги могут использовать одну технологию виртуализации.
Облачная платформа объединяет вычисления, хранение и сеть под общим управлением. Пользователь сам запрашивает ресурсы и освобождает их, когда они больше не нужны. В определении NIST к признакам облака относятся самообслуживание по требованию, доступ по сети, общий пул ресурсов, быстрая эластичность и учёт потребления. Эластичность здесь означает возможность увеличивать и уменьшать выделенные ресурсы вслед за нагрузкой.
На практике граница между услугами размыта. Например, DigitalOcean предоставляет для своих виртуальных машин API и группы автоматического масштабирования. Полезно узнать, какие действия доступны через API – только перезагрузка или ещё и создание дисков, настройка сети и замена машин.
При редкой смене настроек автоматизация может остаться невостребованной, и настройка облачных серверов тогда мало отличается от работы с обычным VPS. Если команда ежедневно создаёт тестовые окружения, API избавляет её от повторения действий в панели.
Как настроить облачный сервер: образы, диски и доступы
Через API программа отправляет команды платформе: создать машину из образа, подключить диск, назначить адрес. Образ содержит подготовленную систему, а сценарий запуска устанавливает приложение и его зависимости. Образ и сценарий запуска делают настройку облачных серверов повторяемой. Пароли и другие секреты нужно хранить отдельно от общего образа и выдавать приложению с ограниченными правами доступа.
Доступом к ресурсам платформы управляет система IAM. Она задаёт права сотрудников и программ: например, скрипту резервного копирования незачем удалять рабочие серверы. Сами ресурсы обычно объединены в проекты, чтобы командам было проще ими управлять.
Перед выбором диска нужно выяснить, что останется после удаления машины. Локальный диск связан с физическим узлом, а подключаемый сетевой том может существовать отдельно от инстанса. Сохранится ли том, зависит в том числе от настроек удаления. Например, в облаке Amazon EC2 параметр DeleteOnTermination определяет, удалится ли сетевой том EBS вместе с машиной.
Для файлов пользователей часто подходит объектное хранилище. Приложение обращается к нему по API, а не как к обычному диску. Базу данных можно разместить на подходящем диске или поручить её обслуживание провайдеру, выбрав отдельный сервис БД.
Когда быстрое масштабирование действительно работает
Увеличение памяти и числа процессоров одной машины называют вертикальным масштабированием. Смена тарифа может требовать остановки, поэтому порядок изменения ресурсов лучше проверить заранее.
При горизонтальном масштабировании появляются дополнительные экземпляры приложения. Балансировщик распределяет между ними запросы пользователей. Любому экземпляру нужен доступ к общим данным: сведениям о входе пользователя, файлам и заказам. Если корзина магазина хранится только в памяти одной машины, второй сервер её не увидит.
Когда эластичность облака оправдывает сложность?
Эластичность полезна при заметных колебаниях нагрузки, когда дополнительные экземпляры приложения успевают запускаться и принимать работу до перегрузки. После спада лишние ресурсы можно освобождать и сокращать расходы. Если приложение нельзя разделить между машинами или пик заканчивается раньше их запуска, автоматическое масштабирование даст мало пользы.
После создания машины ей ещё нужны загрузка системы, запуск приложения и иногда заполнение кеша часто используемыми данными. В AWS настройка instance warmup задаёт время, в течение которого метрики новой машины не включаются в общие показатели для масштабирования. Готовность принимать запросы проверяется отдельно. Для этого балансировщику нужен health-check, проверка работоспособности приложения.
Метрика для масштабирования должна отражать нехватку мощности. Обработчикам фоновых заданий подходит число ожидающих заданий на один экземпляр, а вычислительной задаче может подойти загрузка процессора. Установка облачных серверов из готового образа ускоряет запуск, но не гарантирует его, поскольку даже с готовым образом старт может остановиться из-за квоты аккаунта или нехватки ресурсов в выбранной зоне. Предел числа машин ограничивает расходы, а заранее запущенный резерв помогает пережить короткий всплеск.
Почему одна машина всё ещё может отказать
Во время перезапуска после сбоя сервис может быть недоступен. Чтобы работа продолжалась при потере машины, запросы должны принимать другие экземпляры. Для защиты от сбоя площадки их размещают в разных зонах доступности. Зона объединяет один или несколько дата-центров, а независимость питания и сети нужно уточнять у провайдера.
Пример для веб-приложения: балансировщик принимает запросы и отправляет их на две копии приложения в разных зонах. У приложения общая БД: основной экземпляр в одной зоне, резервный в другой. Файлы пользователей находятся в объектном хранилище с копиями в нескольких зонах. Балансировщик тоже должен переживать отказ зоны, а исправная зона должна выдерживать всю нагрузку.
При выборе хранилища также нужно учитывать зоны, так как сетевой том может быть доступен лишь в одной из них. Для переноса работы БД в другую зону нужны репликация, то есть копирование изменений на резервный экземпляр, и переключение при сбое. Например, в Amazon RDS для этого предназначены варианты Multi-AZ. Резервные копии нужны и при наличии реплики, ведь ошибочное удаление данных может повториться на резервном экземпляре.
SLA, соглашение об уровне обслуживания, задаёт обязательства провайдера, в том числе по доступности ресурсов. Заявленный процент доступности инстанса нельзя автоматически переносить на весь сайт, поскольку ему ещё нужны служба доменных имён (DNS), сеть и БД. У Amazon EC2 обязательства для одного инстанса и размещения в нескольких зонах различаются. В условиях услуги проверьте компенсацию и обязанности вашей команды.
Как сравнить скорость и проверить восстановление
Даже с одинаковым числом виртуальных процессоров (vCPU) и объёмом памяти серверы могут работать с разной скоростью. На скорость влияют модель физического процессора, доля его времени, доступная виртуальной машине, диск и расстояние до клиентов. Для сравнения нужны одна версия приложения, одинаковые данные и запросы. Генератор нагрузки должен сам справляться с потоком запросов.
Сайт стоит оценивать по числу запросов в секунду, доле ошибок и времени ответа. Медиана p50 показывает время, в которое укладывается примерно половина ответов. В пределах p95 и p99 укладываются 95% и 99% запросов соответственно. Результаты при обычной и пиковой нагрузке стоит сопоставить с загрузкой процессора, диска и БД.
Короткий тест может пройти в режиме временного ускорения, burst. На некоторых тарифах оно доступно за счёт накопленного запаса, так называемых кредитов. После их расходования скорость может вернуться к базовому уровню. Диск ограничен и числом операций в секунду (IOPS), и объёмом данных в секунду. При крупных операциях лимит объёма данных может быть достигнут раньше лимита IOPS, пример есть в документации EBS. Если тариф допускает временное ускорение, тест должен продолжаться и после его окончания.
Дальше проверьте, сохраняются ли данные при замене машины. На тестовой копии сервиса запишите контрольные данные в БД и хранилище файлов. Проверка включает три отдельных действия: перезагрузку ОС, остановку с запуском и замену машины новой из образа. После каждого действия проверьте данные, адреса и доступность приложения. В EC2 локальное хранилище instance store переживает перезагрузку, но данные исчезают при остановке или замене машины.
Для проверки отказоустойчивости остановите одну тестовую копию приложения под нагрузкой и проверьте, принимает ли запросы вторая. В отчёте укажите время восстановления, ошибки клиентов и результат проверки данных. Потеря целой зоны требует отдельного испытания.
Из чего складывается счёт
Почасовая оплата удобна для временных задач. За работающую весь месяц машину начисляется полная месячная стоимость. К её цене добавляются диски и другие сервисы.
Месячный расчёт включает:
Виртуальные машины: часы каждого экземпляра × ставку, включая резерв
Диски и копии: объём, дополнительные IOPS, снимки и резервные копии
Сеть: исходящий трафик, обмен между зонами, платные адреса
Сервисы платформы: балансировщик, БД, хранение журналов и запросы к ним
Работа команды: миграция, поддержка, обновления и восстановление
Для иллюстрации возьмём условную ставку 10 ₽ в час. Одна машина за 30 дней, или 720 часов, стоит 7200 ₽. Если вторая нужна по четыре часа в течение 20 дней, она добавит 800 ₽, и общий расход на вычисления составит 8000 ₽. Два постоянно работающих экземпляра за тот же период обойдутся в 14 400 ₽. Ставка условная, а диски, трафик и остальные услуги в расчёт ещё не включены.
После остановки машины часть расходов сохраняется: например, в EC2 вычисления уже не оплачиваются, а за сохранённые тома EBS счёт продолжает идти. Условия для адресов, снимков и других ресурсов зависят от услуги. Ограничения на число ресурсов и автоматическое удаление ненужных нужно настроить отдельно.
Какие задачи лучше оставить на фиксированном VPS?
1. Небольшой сайт со стабильной посещаемостью, которому хватает выбранного тарифа и для которого допустим простой на время восстановления.
2. Бот или внутренний инструмент с предсказуемой нагрузкой и без требования непрерывной работы при отказе машины.
3. Приложение, которое пока не умеет работать на нескольких экземплярах, если ресурсов одного VPS достаточно.
Как выбрать вариант под свою задачу
Как создать свой облачный сервер, обычно понятно из документации провайдера. Сложнее другое: подготовка приложения к работе на нескольких машинах требует времени. Нужно наладить общее хранение файлов и данных о входе пользователей, настроить мониторинг. Затраты на эту работу тоже влияют на выбор.
В таблице сопоставлены типичный простой тариф VPS и облачная платформа. Возможности конкретного VPS могут быть шире.
Управление
Фиксированный VPS: панель; состав API зависит от услуги
Облачная платформа: создание связанных ресурсов через API
Рост нагрузки
Фиксированный VPS: более крупный тариф или дополнительные VPS
Облачная платформа: группы машин и правила масштабирования
Хранение
Фиксированный VPS: обычно диск в составе тарифа
Облачная платформа: отдельные тома, объектное хранилище, сервис БД
Сеть
Фиксированный VPS: адреса и доступные сетевые опции тарифа
Облачная платформа: частные сети, балансировщики, зоны
Доступность
Фиксированный VPS: восстановление по условиям услуги
Облачная платформа: несколько зон при подходящей архитектуре
Расходы
Фиксированный VPS: часто фиксированная сумма и доплаты
Облачная платформа: учёт нескольких ресурсов и их потребления
Магазину с редкими рекламными кампаниями может хватить временного увеличения VPS перед акцией. При частых, непредсказуемых колебаниях полезнее автоматическое добавление машин, если приложение к нему готово.
Облако бывает полезно и при постоянной нагрузке, если команде нужны управляемая БД и удобное восстановление. Несколько VPS с балансировкой также способны обслуживать распределённый сервис. И облачная платформа, и связка из нескольких VPS требуют обслуживания.
Как проверить идею до полного переезда
Пробный переезд, или пилот, проще начать с части приложения без уникальных локальных данных. Подойдёт обработчик изображений, который читает исходники и сохраняет результат в отдельном хранилище. Его проще пересоздать в облаке или вернуть на VPS. Перенос базы на первом шаге усложнит откат.
До запуска задайте пределы времени ответа, доли ошибок, срока восстановления и месячного бюджета. Сравнение p95 с заданным пределом покажет, годится ли конфигурация при рабочей нагрузке. Стоимость нужно рассчитать на полный месяц с пиками, даже если пилот длится неделю.
В плане пилота нужны регион и зоны, тарифы, типы дисков, версии ОС и приложения, образ и сценарий запуска. Журналы создания и удаления ресурсов, результаты запросов и выгрузка расходов помогут повторить проверку. Напишите коллеге инструкцию: как подключиться к облачному серверу, у кого запросить доступ и как восстановить компонент без вас.
В конце испытания верните приложение к прежнему размещению. Приложение должно сохранить нужные данные и продолжить работу. Обработчик может получить задание повторно после сбоя, поэтому повтор не должен создавать лишние записи или другие дубликаты результата. Эксперимент стоит остановить при потере данных, выходе за бюджет или постоянных ручных исправлениях. После пилота удалите ненужные диски, адреса и копии, за которые продолжаются начисления.
После пробного запуска сравните выигрыш со стоимостью переезда и обслуживания. Облако окупается, когда команда пользуется им как платформой: создаёт ресурсы через API, держит приложение в нескольких зонах, отдаёт часть работы управляемым сервисам и умеет восстанавливаться по написанной процедуре. Одна виртуальная машина, купленная в облаке вместо VPS, остаётся одной машиной с той же точкой отказа и обычно даёт только более сложный счёт. Если облачный сервер пока не решает ни одной текущей задачи, работающий VPS можно оставить на месте, а к переезду вернуться, когда появится конкретная причина: рост нагрузки, требование по доступности или нехватка рук на ручные операции.
Pеклама. ООО «Аеза Групп», ИНН: 7813654490. erid:2RanykefAcs
Представим некого разработчика, который по выходным делает собственный пет-проект. Сначала всё живёт на одной виртуальной машине. Проект небольшой, поэтому вся инфраструктура находится там же. API, база данных, обработка запросов и фоновые задачи. На этом этапе всё просто, а нагрузки почти нет.
После завершения разработки MVP версии, этот разработчик решил показать проект своим друзьям и знакомым.
Проект многим понравился, да настолько, что пользователи начали неконтролируемо расти, только за счёт рекомендаций других пользователей.
Инфраструктура та же. Одни пользователи загружают файлы, другие активно работают с сайтом, третьи ждут ответа, чтобы получить результат.
Сервер начинает отвечать медленнее. В логах появляются тайм-ауты, очередь растёт и сервер просто захлёбывается от наплыва задач, которые не может обработать.
Первая мысль, это улучшить код. В основном помогает, но не спасает от слабого сервера, на котором запущен проект.
Опять же, это может помочь, но не всегда. Запросы распределяются честно, а работа нет. Один запрос отвечает за десятки миллисекунд, другой несколько минут.
В этой статье разберём, какие подходы используют крупные компании, и как я решил эту задачу в своём проекте.
Представим сайт с публикациями, комментариями и загрузкой файлов. Запрос на открытие страницы обычно короткий. Backend сходил в кэш или базу данных и вернул ответ.
А генерация отчёта, изменение размера изображения или конвертация большого файла могут занимать секунды и минуты.
Есть и третий класс работы, операции ввода-вывода и вызовы внешних API. Они могут упираться не в процессор, а в скорость сети, диск или чужие лимиты.
Пока запросов мало, один процесс может принять обращение, сходить в базу, прочитать файл и вернуть результат.
С ростом потока возникают очереди ожидания. Часть из них видна разработчику. Например очередь фоновых заданий. Другая часть скрыта внутри операционной системы, пула соединений к базе, диска или внешнего API.
Поэтому фраза «сервер тормозит» бесполезна без уточнения.
Сначала нужно найти ресурс, который не успевает обслуживать работу:
CPU или память;
база данных и её пул соединений;
диск или сетевой канал;
внешний сервис с медленными ответами или лимитами.
Масштабировать систему можно по-разному
Есть 2 подхода по увеличению производительности:
Горизонтальное масштабирование — это добавить ещё одну машину или процесс той же роли. После этого появляются новые вопросы: кто выберет сервер, где хранить состояние, как синхронизировать данные и что произойдёт при падении одного узла.
Вертикальное масштабирование — это взять более мощную машину. Добавить CPU, память, быстрый диск или GPU. Приложение почти не меняется, поэтому для небольшого проекта это хороший первый шаг. Ограничения тоже понятны: у машины есть предел, а при её отказе приложение остановится целиком.
Оба подхода бесполезны против общего узкого ресурса. Если все серверы приложения обращаются к одной перегруженной базе, новая машина только увеличит давление на неё.
❯ Что насчёт асинхронности?
Асинхронность часто называют лекарством от медленного сервера, что в большинстве случаев действительно так и есть. Но точнее будет сказать, что это способ не тратить поток исполнения на бесполезное ожидание.
Примеры выше, я приводил на основе того что код проекта является синхронным.
В синхронной модели обработчик ждёт завершения операции. Если он читает медленный диск или ждёт внешний HTTP-ответ, конкретный поток занят ожиданием. В асинхронной модели приложение может отдать управление event loop циклу событий, который переключается между операциями, пока одна из них ждёт сеть или диск, и принять другой запрос.
Например, API принимает запрос на построение отчёта, сохраняет описание работы и сразу возвращает идентификатор. Отдельный процесс забирает фоновые задачи из очереди.
Пользователь не держит HTTP-соединение открытым несколько минут, а API продолжает отвечать на короткие запросы.
Асинхронность не ускоряет вычисление само по себе. Если внутри event loop запустить длительный расчёт на CPU, этот поток всё равно будет занят вычислениями. То же касается и GPU. Асинхронная оболочка не создаёт второй GPU и не увеличивает объём его памяти. Для такой работы нужен отдельный процесс или worker, а число одновременно запущенных задач приходится ограничивать.
источник
❯ YouTube: как Google экономит магистральные каналы
Большая часть нагрузки видеосервиса — это не вычисления, а передача файлов. Если каждый просмотр обслуживать из одного центрального дата-центра, популярный ролик придётся снова и снова отправлять по магистральной сети.
Когда вы открываете видео на YouTube, файл не обязательно летит через полмира из центрального дата-центра Google. Значительная часть контента хранится на серверах, которые физически находятся внутри сети вашего провайдера или рядом с ней. Это и есть Google Global Cache (GGC).
Google Global Cache
Суть этой технологии простая: если сервер с видео находится внутри сети провайдера, то трафик остаётся локальным и не нагружает внешние магистральные каналы. Так же когда сервер находится за границей, провайдер вынужден тянуть тот же объём данных через платные транзитные линии. GGC помогает решить эту проблему.
Два режима кэширования:
Реактивный: контент попадает в кеш после нескольких запросов от пользователей. Например, после 5-10 просмотров одного ролика в сети провайдера он закрепляется на локальном сервере, и следующие зрители получают его оттуда.
Превентивный: самые популярные видео заранее загружаются на кеш-серверы, независимо от того, сколько раз их уже смотрели в конкретной сети. Это позволяет отдавать видео без задержек.
Что именно он кэширует?
GGC обслуживает не только YouTube, но и другие статические сервисы. Google карты, Chrome, картинки из поиска и т.д.
Для YouTube в первую очередь кэшируются сами видеопотоки и превью.
Типичная оценка Google: 70–90% кэшируемого трафика можно отдать с узла, hit rate зависит от того, что смотрят абоненты.
Если GGC отключить, запросы на видео пойдут напрямую к удалённым серверам Google. Это увеличит задержки, ухудшит качество воспроизведения и повысит нагрузку на магистральные каналы.
Внутри YouTube нет «одной программы». Это набор микросервисов: рекомендации, поиск, метаданные роликов, комментарии, реклама и т.д. Когда вы открываете главную страницу, один сервис делает десятки внутренних RPC-вызовов к другим, чтобы собрать всё воедино. Каждый из этих сервисов запущен в сотнях реплик, поэтому перед каждым вызовом нужно решить, на какую реплику отправить запрос.
Для этого компания Google разработала Prequal (Probing to Reduce Queuing and Latency). Её цель не «уравнять загрузку CPU», а минимизировать реальную задержку запросов и избежать очередей, особенно в хвосте распределения.
Prequal
Вместо того, чтобы балансировать по средней загрузке процессора, Prequal выбирает реплику по двум сигналам.
RIF (Requests In Flight): сколько запросов прямо сейчас обрабатывается на реплике. Это мгновенный показатель, который хорошо предсказывает будущую нагрузку и потребление памяти.
Оценка задержки: медианная латентность недавно завершенных запросов при похожем уровне RIF.
Реплика выбирается по определенным правилам.
Сначала, клиент оценивает распределение RIF по всем репликам и помечает зонды:
«горячие» (hot): RIF выше выбранного квантиля (например, выше 80–90% реплик).
«холодные» (cold): остальные.
Если в пуле есть хотя бы один «холодный» зонд, выбирается холодный с наименьшей задержкой. Если же все зонды «горячие», то выбирается тот зонд, где RIF имеет меньшее значение.
Эти правила отражают приоритеты. Главное, не допустить, чтобы реплика ушла в перегруз по памяти и числу активных запросов. А второе, это минимизировать задержку.
Зонды Prequal отправляются асинхронно. Текущий запрос использует данные от зондов, запущенных предыдущими запросами, чтобы не добавлять задержку на критический путь. Каждый зонд переиспользуется несколько раз, но не бесконечно. Старые записи удаляются по возрасту, по лимиту переиспользования и через периодическую чистку «худших» зондов, чтобы пул не смещался в сторону перегруженных реплик.
Почему отказались от WRR
Почему prequal лучше старой реализации балансировки по CPU (WRR) ?
До внедрения Prequal, YouTube (и многие другие сервисы Google) долгое время использовался балансировку по CPU на основе Weighted Round Robin (WRR).
Её базовый принцип: каждая реплика получает «вес» пропорционально своей средней утилизации процессора, и запросы распределяются по репликам циклически с учётом этих весов, чтобы в среднем нагрузка по CPU была примерно одинаковой.
WRR хорошо выравнивал среднюю загрузку CPU, но плохо реагировал на короткие всплески и «несчастливые» реплики. Это приводило к росту очередей, увеличению хвостовых задержек и периодическим таймаутам на чувствительных к латентности сервисах.
Даже при «нормальной» средней утилизации CPU отдельные реплики регулярно уходили в перегруз из-за конкуренции с другими процессами на той же машине. Балансировка по CPU не успевала это фиксировать и продолжала направлять запросы на уже перегруженные узлы.
Prequal сместил фокус с «средней утилизации CPU» на реальную задержку и число активных запросов. Это позволило быстрее обходить проблемные реплики, сократить хвостовые задержки на 40–50% и практически устранить ошибки из-за дисбаланса нагрузки, что и стало причиной перехода.
источник
❯ Яндекс Диск: как избежать двойной нагрузки на сеть
Обычный балансировщик принимает запрос пользователя и пересылает его на один из серверов. Для небольшого ответа это нормально. С большими файлами возникает лишняя работа. Балансировщик сначала принимает весь файл, а затем передаёт те же данные серверу хранения. Сеть используется дважды.
При загрузке файлов на Яндекс Диск трафик идёт через промежуточное звено, которое не хранит данные, но вынуждено пропускать через себя гигабайты. Это создаёт узкое место. Балансировщик тратит ресурсы на передачу чужих данных, а сеть нагружается вдвое сильнее, чем нужно.
Разделение Control- и Data-запросов
В Яндекс Диске этот путь разделили. Сначала клиент отправляет маленький управляющий запрос и спрашивает, куда загружать файл. В ответ получает ссылку на конкретный сервер и передаёт данные сразу туда, минуя промежуточный балансировщик.
Компонент, который выбирает сервер, в Яндексе назвали Балансерун. Сервер-приёмник получил имя Кладун. Балансерун знает список доступных Кладунов, следит за их состоянием и возвращает пользователю ссылку на один из них.
Основная суть:
Control-запросы: лёгкие HTTP-запросы для получения адреса загрузки. Они проходят через стандартный балансировщик, так как почти не создают сетевой нагрузки.
Data-запросы: сами файлы, которые идут напрямую от клиента к выбранному Кладуну, минуя балансировщик.
Это снимает двойную нагрузку на сеть. Данные больше не проходят через промежуточное звено.
Почему не подходят Random и Round Robin
Оба алгоритма распределяют запросы, но не учитывают реальную скорость загрузки:
Random: случайный выбор узла. При высокой дисперсии скоростей пользователей (от 10 Мбит/с до 1 Гбит/с) некоторые узлы получают несколько «тяжёлых» клиентов подряд и перегружаются, пока другие простаивают.
Round Robin: чередование узлов. Даёт равное число запросов, но не равный трафик. Один узел может получить трёх быстрых клиентов, другой, трёх медленных.
В обоих случаях нагрузка на сеть распределяется неравномерно, возникают «хвосты» перегруженных узлов.
Решение проблемы: HOBA
Для решения этой проблемы каждый Балансерун получает собственную группу серверов. Выдав ссылку пользователю, он сразу увеличивает расчётную нагрузку выбранного Кладуна на ожидаемую скорость загрузки. Ждать следующего отчёта от сервера не нужно. Периодические общие показатели лишь исправляют накопившуюся ошибку прогноза. В Яндексе этот алгоритм назвали HOBA (Hierarchical Optimized Balancing Algorithm).
Как это работает:
Локальные пулы. Каждый Балансерун получает непересекающийся пул Кладунов. При назначении загрузки он мгновенно обновляет виртуальную нагрузку выбранного узла на ожидаемую скорость клиента, не дожидаясь отчётов. Это даёт актуальную «картину мира» в ту же миллисекунду.
Учёт скорости. Балансировщик хранит данные о скорости пользователя (текущей, средней по истории или медианной по системе) и оперирует прогнозируемой нагрузкой на канал, а не числом запросов.
Глобальная статистика. Периодические отчёты от Кладунов (раз в K секунд) теперь используются не для мгновенных решений, а для коррекции накопленной погрешности локальных расчётов. Это позволило увеличить интервал K и разгрузить шину управления.
Остаётся понять, какой Балансерун отвечает за какие серверы. Для каждого Кладуна все балансировщики независимо вычисляют одного и того же владельца. Если Балансерун исчезает, переназначаются только его серверы. Этот метод называется Rendezvous Hashing.
Принцип работы:
1. Для каждой пары «Кладун + Балансерун» вычисляется весовая функция. 2. Кладун назначается в пул того балансировщика, у которого вес максимален. 3. Если один Балансерун падает, пересчитываются веса только для его Кладунов — остальные пары сохраняют свои веса и остаются в прежних пулах.
Это минимизирует миграции и сохраняет локальную статистику на живых балансировщиках.
Ограничение размера пулов
Чтобы случайность не отдала одному Балансеруну слишком много Кладунов, размер каждой группы дополнительно ограничивается:
Вычисляется «идеальный» размер пула: uploaders_num / balancers_num.
При назначении Кладуна проверяется, не достиг ли пул балансировщика лимита. Если да, выбирается следующий по весу балансировщик.
Дополнительно можно ограничивать пул снизу, чтобы разница между наиболее и наименее заполненными пулами не превышала единицы.
После внедрения HOBA распределение загрузки сети стало более равномерным. Стандартное отклонение снизилось на 22%, количество перегруженных «хвостов» уменьшилось, а утилизация сети выровнялась. Алгоритм особенно эффективен при высокой дисперсии скоростей пользователей.
источник
❯ Timeweb Cloud: не запустить всё сразу
Иногда физический сервер нужно освободить для ремонта или замены. Запущенные на нём виртуальные машины переносят на другие серверы. Если начать десятки таких миграций одновременно, они займут весь сетевой канал и помешают не только друг другу, но и работающим клиентским машинам.
Внутренний сервис Timeweb Cloud под названием vapi-server сначала измеряет доступную скорость между исходным и целевым сервером. Затем он решает, сколько виртуальных машин можно переносить одновременно, и делит между ними канал. Новая миграция начинается, когда освобождается место.
Принцип:
1. Если запустить все миграции сразу, они «забьют» сеть, и каждая будет идти медленно, мешая остальным.
2. Если ограничить число одновременных переносов и разделить канал, миграции пройдут быстрее и не повлияют на работу клиентских машин.
Решение: агенты на гипервизорах
При создании виртуальных машин используется другой подход. Физический сервер, на котором запускаются виртуальные машины, называется гипервизором. Раньше команды для всех гипервизоров проходили через центральный API и образовывали длинную общую цепочку.
Теперь на каждом гипервизоре работает небольшой служебный процесс или агент. Центральный API сообщает, что нужно сделать, а агент выполняет команду на своей машине и возвращает результат. Несвязанные операции могут идти параллельно.
Как это работает:
Центральный API: принимает запросы от пользователей и распределяет задачи между гипервизорами.
Агент на гипервизоре: получает команду, выполняет её локально (создание ВМ, старт, остановка) и возвращает результат.
Это убирает узкое место в виде единой очереди и позволяет выполнять независимые операции параллельно. Похожую логику можно использовать не только внутри облачной платформы, но и при построении собственной инфраструктуры.
Как взять этот принцип и применить у себя
Похожий подход можно использовать и при настройке пользовательской инфраструктуры.
Например, проект можно разместить на нескольких облачных серверах Timeweb Cloud, а входящий трафик распределить между ними с помощью балансировщика нагрузки.
Вместо одной машины, которая принимает все запросы, нагрузка разделяется между несколькими серверами. Если проект растёт, к схеме можно добавить новый сервер и направить на него часть трафика. Балансировщик также проверяет доступность подключённых машин и исключает из распределения те, которые перестали отвечать.
Такой сценарий позволяет постепенно расширять инфраструктуру. Начать с двух серверов, а затем добавлять новые ресурсы по мере роста нагрузки. Серверы создаются через панель Timeweb Cloud.
Здесь используется тот же общий принцип, что и во внутренней инфраструктуре Timeweb Cloud. Не отправлять все операции или запросы одному исполнителю, а распределять нагрузку между несколькими доступными ресурсами.
Что дала новая архитектура
В июльском дайджесте Timeweb Cloud указывает результат этой перестройки. Что от нажатия кнопки до готовой виртуальной машины проходит около 30 секунд.
Такой подход работает не только внутри платформы. Когда вы разворачиваете проект на облачных серверах Timeweb Cloud, аналогичные принципы применяются и к вашей инфраструктуре. балансировщик нагрузки распределяет трафик между несколькими VPS, а новые виртуальные машины создаются за секунды через API или панель управления.
В одном случае компания распределяет команды между локальными исполнителями. В другом ограничивает число одновременных переносов реальной скоростью сети. Это внутренняя инфраструктура Timeweb Cloud, а не описание балансировщика, который предлагается пользователям.
Для гипотетического разработчика из начала статьи как раз этот слой и нужен. Две-три машины, балансировщик между ними, без собственного мини-Диска. Продукт здесь инструмент в истории, не заголовок.
❯ .sound: пример из жизни
Музыкальная платформа с загрузкой треков, поиском, рекомендациями и автоматической синхронизацией текста с аудио
Одна из самых тяжёлых операций выглядит так: 1. Получить аудиофайл. 2. При необходимости отделить вокал через Demucs. 3. Распознать слова с помощью faster-whisper. 4. Сопоставить строки с моментами в аудио. 5. Вернуть текст и тайм-коды в основную серверную часть, или Backend.
Сначала такая обработка выполнялась рядом с основным приложением. В итоге веб-запросы и распознавание музыки конкурировали за процессор, память и диск. Масштабировать весь Backend ради одной тяжёлой операции было бессмысленно.
Я вынес вычисления в отдельный репозиторий.
При его запуске создаётся отдельный worker. Он сам подключается к Backend и просит следующую задачу. Такой порядок называют pull-моделью. Не сервер ищет свободного исполнителя, а исполнитель приходит за работой.
Благодаря этому, на домашнем компьютере или сервере с видеокартой не нужно открывать входящий порт. Да и нагрузка значительно снижается, ведь распределена между разными серверами.
Разные задачи, разные способы обработки
В «.sound» разные типы задач не складываются в одну общую очередь.
Для каждой группы используется отдельный способ хранения и обработки. Обычные фоновые операции выполняются рядом с сайтом, а ресурсоёмкие вычисления и распознавание аудио обрабатываются отдельно.
Это позволяет задавать для них разные ограничения, правила запуска и повторной обработки.
На архитектурной схеме единая очередь выглядела бы аккуратнее. Но в коде разделение оказалось понятнее. Короткие фоновые задачи, удалённые вычисления и длительная обработка аудио по-разному восстанавливаются после сбоев.
Как исполнители делят задачи между собой
При подключении исполнитель указывает профиль: cpu_light (обычный процессор) или gpu_full (видеокарта) и какие типы задач умеет брать. Распознавание песен (ASR) обычно ждёт машину с видеокартой.
Сервер (Backend) выбирает работу по типу, приоритету, профилю и времени, когда можно пробовать снова. Если несколько исполнителей тянут одну задачу сразу, PG на короткое время блокирует эту запись. Остальные не ждут, а берут следующую.
Забрав задачу, исполнитель держит её только ограниченное время. Раз в минуту отдельный фоновый процесс находит просроченные задачи и возвращает их в очередь с паузой перед новой попыткой.
Это не гарантия, что задача физически запустится ровно один раз. После сбоя её могут выполнить снова. Поэтому повторная постановка не должна создавать копии, а повторное сохранение результата, портить данные.
Как Backend понимает, что исполнитель жив
Каждые 15 секунд исполнитель шлёт запрос «я жив» на сервер, и обновляет время последней связи.
И в том же ответе может сказать: не бери новые задачи или отмени текущую задачу.
Почему аудио и остальные задачи выполняются по-разному?
Сложные GPU задачи работают строго по одой задаче. Пока текущая не закончена, следующую не берут.
Остальные вычисления можно делать параллельно. Есть общий потолок и отдельные лимиты по типам.
Что даёт отдельный исполнитель
Тяжёлые задачи больше не живут в том же процессе, который отвечает пользователям. База и выдача музыки отделены от вычислений.
Исполнителя можно перенести на другую машину. Можно добавить несколько исполнителей, чтобы разгрузить очередь. Можно сменить процессор на видеокарту или поставить машины с другим набором задач. Снаружи проект от этого не меняется.
Если исполнитель падает, задание не зависает в статусе «обрабатывается». Когда отведённое время кончается, фоновый процесс возвращает его в очередь. Перегруженную машину можно поставить на паузу: сервер говорит об этом в ответе на очередной пульс.
Про «в десять раз быстрее» писать не буду. Задачи стали обрабатываться быстрее, но траты на аренду тоже выросли. Воркеры живут на отдельных серверах.
❯ Общие принципы
Не чеклист на все случаи, а то, что выявил разбирая примеры выше.
Балансируй конкретный ресурс, а не «запросы вообще». В примерах выше узким местом оказывался не CPU в целом, а что-то одно: магистральный канал (YouTube), сеть на балансировщике при загрузке файлов (Яндекс Диск), очередь RPC-реплик с разной латентностью (Prequal), канал между гипервизорами (Timeweb), GPU/CPU под тяжёлыми вычислениями (.sound). Прежде чем выбирать алгоритм, нужно определить ресурс который будете оптимизировать.
Разделяй короткие HTTP-запросы и тяжёлую работу. В .sound тяжёлые задачи вынесены в отдельных воркеров, которые сами забирают задачи. В YouTube тяжёлый трафик вынесен на кэш-узлы у провайдера, в Яндексе data-запросы идут напрямую на узел хранения. Если тяжёлая операция живёт в том же процессе, что и веб-ответы, она будет воровать CPU, память и диск у обычных запросов.
Метрика важнее названия алгоритма. Google ушёл от WRR (балансировка по среднему CPU) к Prequal, потому что «средний CPU за минуту» врал. Реплики уходили в перегруз по памяти и числу активных запросов, а хвостовые задержки росли. В Яндексе HOBA оперирует не числом запросов, а прогнозируемой нагрузкой на канал с учётом скорости клиента. Выбор метрики (RIF + латентность, нагрузка на сеть, число активных миграций) определяет, будет ли алгоритм работать.
❯ Заключение
Балансировать нужно не абстрактные запросы, а ресурс, который заканчивается.
Масштабирование не начинается с покупки самого мощного сервера или подключения случайного балансировщика. Сначала нужно понять, что именно не справляется: CPU, GPU, сеть, диск, база данных или очередь задач.
У крупных сервисов разные решения, но принцип один. Тяжёлую работу отделяют от коротких запросов, данные стараются не гонять через лишние узлы, а нагрузку измеряют метрикой, которая связана с реальной проблемой.
Для небольшого проекта не нужно копировать инфраструктуру YouTube или Яндекс Диска. На первых этапах достаточно вынести долгие операции в отдельные воркеры, ограничить число параллельных задач и при необходимости добавить несколько серверов за балансировщиком. Инфраструктура должна расти вместе с продуктом, а не опережать его.