Google сообщила об атаках на доменные зоны .gh (Гана), .sl (Сьерра-Леоне) и .as (Американское Самоа). Злоумышленники изменили DNS-записи и получили несанкционированные HTTPS-сертификаты для нескольких доменов Google и других организаций. По данным компании, её собственные системы скомпрометированы не были.
Chrome заблокировал использование обнаруженных сертификатов. Google также связалась с центрами сертификации, чтобы их отозвали и для пользователей других браузеров. Пользователям Chrome ничего делать не нужно.
При этом Google предупреждает: браузерная блокировка не гарантирует, что удалось обнаружить все затронутые домены, и не обеспечивает защиту пользователей других браузеров. Компания советует владельцам сайтов отслеживать новые сертификаты и ограничивать их выдачу через DNS-записи CAA.
Представим некого разработчика, который по выходным делает собственный пет-проект. Сначала всё живёт на одной виртуальной машине. Проект небольшой, поэтому вся инфраструктура находится там же. API, база данных, обработка запросов и фоновые задачи. На этом этапе всё просто, а нагрузки почти нет.
После завершения разработки MVP версии, этот разработчик решил показать проект своим друзьям и знакомым.
Проект многим понравился, да настолько, что пользователи начали неконтролируемо расти, только за счёт рекомендаций других пользователей.
Инфраструктура та же. Одни пользователи загружают файлы, другие активно работают с сайтом, третьи ждут ответа, чтобы получить результат.
Сервер начинает отвечать медленнее. В логах появляются тайм-ауты, очередь растёт и сервер просто захлёбывается от наплыва задач, которые не может обработать.
Первая мысль, это улучшить код. В основном помогает, но не спасает от слабого сервера, на котором запущен проект.
Опять же, это может помочь, но не всегда. Запросы распределяются честно, а работа нет. Один запрос отвечает за десятки миллисекунд, другой несколько минут.
В этой статье разберём, какие подходы используют крупные компании, и как я решил эту задачу в своём проекте.
Представим сайт с публикациями, комментариями и загрузкой файлов. Запрос на открытие страницы обычно короткий. Backend сходил в кэш или базу данных и вернул ответ.
А генерация отчёта, изменение размера изображения или конвертация большого файла могут занимать секунды и минуты.
Есть и третий класс работы, операции ввода-вывода и вызовы внешних API. Они могут упираться не в процессор, а в скорость сети, диск или чужие лимиты.
Пока запросов мало, один процесс может принять обращение, сходить в базу, прочитать файл и вернуть результат.
С ростом потока возникают очереди ожидания. Часть из них видна разработчику. Например очередь фоновых заданий. Другая часть скрыта внутри операционной системы, пула соединений к базе, диска или внешнего API.
Поэтому фраза «сервер тормозит» бесполезна без уточнения.
Сначала нужно найти ресурс, который не успевает обслуживать работу:
CPU или память;
база данных и её пул соединений;
диск или сетевой канал;
внешний сервис с медленными ответами или лимитами.
Масштабировать систему можно по-разному
Есть 2 подхода по увеличению производительности:
Горизонтальное масштабирование — это добавить ещё одну машину или процесс той же роли. После этого появляются новые вопросы: кто выберет сервер, где хранить состояние, как синхронизировать данные и что произойдёт при падении одного узла.
Вертикальное масштабирование — это взять более мощную машину. Добавить CPU, память, быстрый диск или GPU. Приложение почти не меняется, поэтому для небольшого проекта это хороший первый шаг. Ограничения тоже понятны: у машины есть предел, а при её отказе приложение остановится целиком.
Оба подхода бесполезны против общего узкого ресурса. Если все серверы приложения обращаются к одной перегруженной базе, новая машина только увеличит давление на неё.
❯ Что насчёт асинхронности?
Асинхронность часто называют лекарством от медленного сервера, что в большинстве случаев действительно так и есть. Но точнее будет сказать, что это способ не тратить поток исполнения на бесполезное ожидание.
Примеры выше, я приводил на основе того что код проекта является синхронным.
В синхронной модели обработчик ждёт завершения операции. Если он читает медленный диск или ждёт внешний HTTP-ответ, конкретный поток занят ожиданием. В асинхронной модели приложение может отдать управление event loop циклу событий, который переключается между операциями, пока одна из них ждёт сеть или диск, и принять другой запрос.
Например, API принимает запрос на построение отчёта, сохраняет описание работы и сразу возвращает идентификатор. Отдельный процесс забирает фоновые задачи из очереди.
Пользователь не держит HTTP-соединение открытым несколько минут, а API продолжает отвечать на короткие запросы.
Асинхронность не ускоряет вычисление само по себе. Если внутри event loop запустить длительный расчёт на CPU, этот поток всё равно будет занят вычислениями. То же касается и GPU. Асинхронная оболочка не создаёт второй GPU и не увеличивает объём его памяти. Для такой работы нужен отдельный процесс или worker, а число одновременно запущенных задач приходится ограничивать.
источник
❯ YouTube: как Google экономит магистральные каналы
Большая часть нагрузки видеосервиса — это не вычисления, а передача файлов. Если каждый просмотр обслуживать из одного центрального дата-центра, популярный ролик придётся снова и снова отправлять по магистральной сети.
Когда вы открываете видео на YouTube, файл не обязательно летит через полмира из центрального дата-центра Google. Значительная часть контента хранится на серверах, которые физически находятся внутри сети вашего провайдера или рядом с ней. Это и есть Google Global Cache (GGC).
Google Global Cache
Суть этой технологии простая: если сервер с видео находится внутри сети провайдера, то трафик остаётся локальным и не нагружает внешние магистральные каналы. Так же когда сервер находится за границей, провайдер вынужден тянуть тот же объём данных через платные транзитные линии. GGC помогает решить эту проблему.
Два режима кэширования:
Реактивный: контент попадает в кеш после нескольких запросов от пользователей. Например, после 5-10 просмотров одного ролика в сети провайдера он закрепляется на локальном сервере, и следующие зрители получают его оттуда.
Превентивный: самые популярные видео заранее загружаются на кеш-серверы, независимо от того, сколько раз их уже смотрели в конкретной сети. Это позволяет отдавать видео без задержек.
Что именно он кэширует?
GGC обслуживает не только YouTube, но и другие статические сервисы. Google карты, Chrome, картинки из поиска и т.д.
Для YouTube в первую очередь кэшируются сами видеопотоки и превью.
Типичная оценка Google: 70–90% кэшируемого трафика можно отдать с узла, hit rate зависит от того, что смотрят абоненты.
Если GGC отключить, запросы на видео пойдут напрямую к удалённым серверам Google. Это увеличит задержки, ухудшит качество воспроизведения и повысит нагрузку на магистральные каналы.
Внутри YouTube нет «одной программы». Это набор микросервисов: рекомендации, поиск, метаданные роликов, комментарии, реклама и т.д. Когда вы открываете главную страницу, один сервис делает десятки внутренних RPC-вызовов к другим, чтобы собрать всё воедино. Каждый из этих сервисов запущен в сотнях реплик, поэтому перед каждым вызовом нужно решить, на какую реплику отправить запрос.
Для этого компания Google разработала Prequal (Probing to Reduce Queuing and Latency). Её цель не «уравнять загрузку CPU», а минимизировать реальную задержку запросов и избежать очередей, особенно в хвосте распределения.
Prequal
Вместо того, чтобы балансировать по средней загрузке процессора, Prequal выбирает реплику по двум сигналам.
RIF (Requests In Flight): сколько запросов прямо сейчас обрабатывается на реплике. Это мгновенный показатель, который хорошо предсказывает будущую нагрузку и потребление памяти.
Оценка задержки: медианная латентность недавно завершенных запросов при похожем уровне RIF.
Реплика выбирается по определенным правилам.
Сначала, клиент оценивает распределение RIF по всем репликам и помечает зонды:
«горячие» (hot): RIF выше выбранного квантиля (например, выше 80–90% реплик).
«холодные» (cold): остальные.
Если в пуле есть хотя бы один «холодный» зонд, выбирается холодный с наименьшей задержкой. Если же все зонды «горячие», то выбирается тот зонд, где RIF имеет меньшее значение.
Эти правила отражают приоритеты. Главное, не допустить, чтобы реплика ушла в перегруз по памяти и числу активных запросов. А второе, это минимизировать задержку.
Зонды Prequal отправляются асинхронно. Текущий запрос использует данные от зондов, запущенных предыдущими запросами, чтобы не добавлять задержку на критический путь. Каждый зонд переиспользуется несколько раз, но не бесконечно. Старые записи удаляются по возрасту, по лимиту переиспользования и через периодическую чистку «худших» зондов, чтобы пул не смещался в сторону перегруженных реплик.
Почему отказались от WRR
Почему prequal лучше старой реализации балансировки по CPU (WRR) ?
До внедрения Prequal, YouTube (и многие другие сервисы Google) долгое время использовался балансировку по CPU на основе Weighted Round Robin (WRR).
Её базовый принцип: каждая реплика получает «вес» пропорционально своей средней утилизации процессора, и запросы распределяются по репликам циклически с учётом этих весов, чтобы в среднем нагрузка по CPU была примерно одинаковой.
WRR хорошо выравнивал среднюю загрузку CPU, но плохо реагировал на короткие всплески и «несчастливые» реплики. Это приводило к росту очередей, увеличению хвостовых задержек и периодическим таймаутам на чувствительных к латентности сервисах.
Даже при «нормальной» средней утилизации CPU отдельные реплики регулярно уходили в перегруз из-за конкуренции с другими процессами на той же машине. Балансировка по CPU не успевала это фиксировать и продолжала направлять запросы на уже перегруженные узлы.
Prequal сместил фокус с «средней утилизации CPU» на реальную задержку и число активных запросов. Это позволило быстрее обходить проблемные реплики, сократить хвостовые задержки на 40–50% и практически устранить ошибки из-за дисбаланса нагрузки, что и стало причиной перехода.
источник
❯ Яндекс Диск: как избежать двойной нагрузки на сеть
Обычный балансировщик принимает запрос пользователя и пересылает его на один из серверов. Для небольшого ответа это нормально. С большими файлами возникает лишняя работа. Балансировщик сначала принимает весь файл, а затем передаёт те же данные серверу хранения. Сеть используется дважды.
При загрузке файлов на Яндекс Диск трафик идёт через промежуточное звено, которое не хранит данные, но вынуждено пропускать через себя гигабайты. Это создаёт узкое место. Балансировщик тратит ресурсы на передачу чужих данных, а сеть нагружается вдвое сильнее, чем нужно.
Разделение Control- и Data-запросов
В Яндекс Диске этот путь разделили. Сначала клиент отправляет маленький управляющий запрос и спрашивает, куда загружать файл. В ответ получает ссылку на конкретный сервер и передаёт данные сразу туда, минуя промежуточный балансировщик.
Компонент, который выбирает сервер, в Яндексе назвали Балансерун. Сервер-приёмник получил имя Кладун. Балансерун знает список доступных Кладунов, следит за их состоянием и возвращает пользователю ссылку на один из них.
Основная суть:
Control-запросы: лёгкие HTTP-запросы для получения адреса загрузки. Они проходят через стандартный балансировщик, так как почти не создают сетевой нагрузки.
Data-запросы: сами файлы, которые идут напрямую от клиента к выбранному Кладуну, минуя балансировщик.
Это снимает двойную нагрузку на сеть. Данные больше не проходят через промежуточное звено.
Почему не подходят Random и Round Robin
Оба алгоритма распределяют запросы, но не учитывают реальную скорость загрузки:
Random: случайный выбор узла. При высокой дисперсии скоростей пользователей (от 10 Мбит/с до 1 Гбит/с) некоторые узлы получают несколько «тяжёлых» клиентов подряд и перегружаются, пока другие простаивают.
Round Robin: чередование узлов. Даёт равное число запросов, но не равный трафик. Один узел может получить трёх быстрых клиентов, другой, трёх медленных.
В обоих случаях нагрузка на сеть распределяется неравномерно, возникают «хвосты» перегруженных узлов.
Решение проблемы: HOBA
Для решения этой проблемы каждый Балансерун получает собственную группу серверов. Выдав ссылку пользователю, он сразу увеличивает расчётную нагрузку выбранного Кладуна на ожидаемую скорость загрузки. Ждать следующего отчёта от сервера не нужно. Периодические общие показатели лишь исправляют накопившуюся ошибку прогноза. В Яндексе этот алгоритм назвали HOBA (Hierarchical Optimized Balancing Algorithm).
Как это работает:
Локальные пулы. Каждый Балансерун получает непересекающийся пул Кладунов. При назначении загрузки он мгновенно обновляет виртуальную нагрузку выбранного узла на ожидаемую скорость клиента, не дожидаясь отчётов. Это даёт актуальную «картину мира» в ту же миллисекунду.
Учёт скорости. Балансировщик хранит данные о скорости пользователя (текущей, средней по истории или медианной по системе) и оперирует прогнозируемой нагрузкой на канал, а не числом запросов.
Глобальная статистика. Периодические отчёты от Кладунов (раз в K секунд) теперь используются не для мгновенных решений, а для коррекции накопленной погрешности локальных расчётов. Это позволило увеличить интервал K и разгрузить шину управления.
Остаётся понять, какой Балансерун отвечает за какие серверы. Для каждого Кладуна все балансировщики независимо вычисляют одного и того же владельца. Если Балансерун исчезает, переназначаются только его серверы. Этот метод называется Rendezvous Hashing.
Принцип работы:
1. Для каждой пары «Кладун + Балансерун» вычисляется весовая функция. 2. Кладун назначается в пул того балансировщика, у которого вес максимален. 3. Если один Балансерун падает, пересчитываются веса только для его Кладунов — остальные пары сохраняют свои веса и остаются в прежних пулах.
Это минимизирует миграции и сохраняет локальную статистику на живых балансировщиках.
Ограничение размера пулов
Чтобы случайность не отдала одному Балансеруну слишком много Кладунов, размер каждой группы дополнительно ограничивается:
Вычисляется «идеальный» размер пула: uploaders_num / balancers_num.
При назначении Кладуна проверяется, не достиг ли пул балансировщика лимита. Если да, выбирается следующий по весу балансировщик.
Дополнительно можно ограничивать пул снизу, чтобы разница между наиболее и наименее заполненными пулами не превышала единицы.
После внедрения HOBA распределение загрузки сети стало более равномерным. Стандартное отклонение снизилось на 22%, количество перегруженных «хвостов» уменьшилось, а утилизация сети выровнялась. Алгоритм особенно эффективен при высокой дисперсии скоростей пользователей.
источник
❯ Timeweb Cloud: не запустить всё сразу
Иногда физический сервер нужно освободить для ремонта или замены. Запущенные на нём виртуальные машины переносят на другие серверы. Если начать десятки таких миграций одновременно, они займут весь сетевой канал и помешают не только друг другу, но и работающим клиентским машинам.
Внутренний сервис Timeweb Cloud под названием vapi-server сначала измеряет доступную скорость между исходным и целевым сервером. Затем он решает, сколько виртуальных машин можно переносить одновременно, и делит между ними канал. Новая миграция начинается, когда освобождается место.
Принцип:
1. Если запустить все миграции сразу, они «забьют» сеть, и каждая будет идти медленно, мешая остальным.
2. Если ограничить число одновременных переносов и разделить канал, миграции пройдут быстрее и не повлияют на работу клиентских машин.
Решение: агенты на гипервизорах
При создании виртуальных машин используется другой подход. Физический сервер, на котором запускаются виртуальные машины, называется гипервизором. Раньше команды для всех гипервизоров проходили через центральный API и образовывали длинную общую цепочку.
Теперь на каждом гипервизоре работает небольшой служебный процесс или агент. Центральный API сообщает, что нужно сделать, а агент выполняет команду на своей машине и возвращает результат. Несвязанные операции могут идти параллельно.
Как это работает:
Центральный API: принимает запросы от пользователей и распределяет задачи между гипервизорами.
Агент на гипервизоре: получает команду, выполняет её локально (создание ВМ, старт, остановка) и возвращает результат.
Это убирает узкое место в виде единой очереди и позволяет выполнять независимые операции параллельно. Похожую логику можно использовать не только внутри облачной платформы, но и при построении собственной инфраструктуры.
Как взять этот принцип и применить у себя
Похожий подход можно использовать и при настройке пользовательской инфраструктуры.
Например, проект можно разместить на нескольких облачных серверах Timeweb Cloud, а входящий трафик распределить между ними с помощью балансировщика нагрузки.
Вместо одной машины, которая принимает все запросы, нагрузка разделяется между несколькими серверами. Если проект растёт, к схеме можно добавить новый сервер и направить на него часть трафика. Балансировщик также проверяет доступность подключённых машин и исключает из распределения те, которые перестали отвечать.
Такой сценарий позволяет постепенно расширять инфраструктуру. Начать с двух серверов, а затем добавлять новые ресурсы по мере роста нагрузки. Серверы создаются через панель Timeweb Cloud.
Здесь используется тот же общий принцип, что и во внутренней инфраструктуре Timeweb Cloud. Не отправлять все операции или запросы одному исполнителю, а распределять нагрузку между несколькими доступными ресурсами.
Что дала новая архитектура
В июльском дайджесте Timeweb Cloud указывает результат этой перестройки. Что от нажатия кнопки до готовой виртуальной машины проходит около 30 секунд.
Такой подход работает не только внутри платформы. Когда вы разворачиваете проект на облачных серверах Timeweb Cloud, аналогичные принципы применяются и к вашей инфраструктуре. балансировщик нагрузки распределяет трафик между несколькими VPS, а новые виртуальные машины создаются за секунды через API или панель управления.
В одном случае компания распределяет команды между локальными исполнителями. В другом ограничивает число одновременных переносов реальной скоростью сети. Это внутренняя инфраструктура Timeweb Cloud, а не описание балансировщика, который предлагается пользователям.
Для гипотетического разработчика из начала статьи как раз этот слой и нужен. Две-три машины, балансировщик между ними, без собственного мини-Диска. Продукт здесь инструмент в истории, не заголовок.
❯ .sound: пример из жизни
Музыкальная платформа с загрузкой треков, поиском, рекомендациями и автоматической синхронизацией текста с аудио
Одна из самых тяжёлых операций выглядит так: 1. Получить аудиофайл. 2. При необходимости отделить вокал через Demucs. 3. Распознать слова с помощью faster-whisper. 4. Сопоставить строки с моментами в аудио. 5. Вернуть текст и тайм-коды в основную серверную часть, или Backend.
Сначала такая обработка выполнялась рядом с основным приложением. В итоге веб-запросы и распознавание музыки конкурировали за процессор, память и диск. Масштабировать весь Backend ради одной тяжёлой операции было бессмысленно.
Я вынес вычисления в отдельный репозиторий.
При его запуске создаётся отдельный worker. Он сам подключается к Backend и просит следующую задачу. Такой порядок называют pull-моделью. Не сервер ищет свободного исполнителя, а исполнитель приходит за работой.
Благодаря этому, на домашнем компьютере или сервере с видеокартой не нужно открывать входящий порт. Да и нагрузка значительно снижается, ведь распределена между разными серверами.
Разные задачи, разные способы обработки
В «.sound» разные типы задач не складываются в одну общую очередь.
Для каждой группы используется отдельный способ хранения и обработки. Обычные фоновые операции выполняются рядом с сайтом, а ресурсоёмкие вычисления и распознавание аудио обрабатываются отдельно.
Это позволяет задавать для них разные ограничения, правила запуска и повторной обработки.
На архитектурной схеме единая очередь выглядела бы аккуратнее. Но в коде разделение оказалось понятнее. Короткие фоновые задачи, удалённые вычисления и длительная обработка аудио по-разному восстанавливаются после сбоев.
Как исполнители делят задачи между собой
При подключении исполнитель указывает профиль: cpu_light (обычный процессор) или gpu_full (видеокарта) и какие типы задач умеет брать. Распознавание песен (ASR) обычно ждёт машину с видеокартой.
Сервер (Backend) выбирает работу по типу, приоритету, профилю и времени, когда можно пробовать снова. Если несколько исполнителей тянут одну задачу сразу, PG на короткое время блокирует эту запись. Остальные не ждут, а берут следующую.
Забрав задачу, исполнитель держит её только ограниченное время. Раз в минуту отдельный фоновый процесс находит просроченные задачи и возвращает их в очередь с паузой перед новой попыткой.
Это не гарантия, что задача физически запустится ровно один раз. После сбоя её могут выполнить снова. Поэтому повторная постановка не должна создавать копии, а повторное сохранение результата, портить данные.
Как Backend понимает, что исполнитель жив
Каждые 15 секунд исполнитель шлёт запрос «я жив» на сервер, и обновляет время последней связи.
И в том же ответе может сказать: не бери новые задачи или отмени текущую задачу.
Почему аудио и остальные задачи выполняются по-разному?
Сложные GPU задачи работают строго по одой задаче. Пока текущая не закончена, следующую не берут.
Остальные вычисления можно делать параллельно. Есть общий потолок и отдельные лимиты по типам.
Что даёт отдельный исполнитель
Тяжёлые задачи больше не живут в том же процессе, который отвечает пользователям. База и выдача музыки отделены от вычислений.
Исполнителя можно перенести на другую машину. Можно добавить несколько исполнителей, чтобы разгрузить очередь. Можно сменить процессор на видеокарту или поставить машины с другим набором задач. Снаружи проект от этого не меняется.
Если исполнитель падает, задание не зависает в статусе «обрабатывается». Когда отведённое время кончается, фоновый процесс возвращает его в очередь. Перегруженную машину можно поставить на паузу: сервер говорит об этом в ответе на очередной пульс.
Про «в десять раз быстрее» писать не буду. Задачи стали обрабатываться быстрее, но траты на аренду тоже выросли. Воркеры живут на отдельных серверах.
❯ Общие принципы
Не чеклист на все случаи, а то, что выявил разбирая примеры выше.
Балансируй конкретный ресурс, а не «запросы вообще». В примерах выше узким местом оказывался не CPU в целом, а что-то одно: магистральный канал (YouTube), сеть на балансировщике при загрузке файлов (Яндекс Диск), очередь RPC-реплик с разной латентностью (Prequal), канал между гипервизорами (Timeweb), GPU/CPU под тяжёлыми вычислениями (.sound). Прежде чем выбирать алгоритм, нужно определить ресурс который будете оптимизировать.
Разделяй короткие HTTP-запросы и тяжёлую работу. В .sound тяжёлые задачи вынесены в отдельных воркеров, которые сами забирают задачи. В YouTube тяжёлый трафик вынесен на кэш-узлы у провайдера, в Яндексе data-запросы идут напрямую на узел хранения. Если тяжёлая операция живёт в том же процессе, что и веб-ответы, она будет воровать CPU, память и диск у обычных запросов.
Метрика важнее названия алгоритма. Google ушёл от WRR (балансировка по среднему CPU) к Prequal, потому что «средний CPU за минуту» врал. Реплики уходили в перегруз по памяти и числу активных запросов, а хвостовые задержки росли. В Яндексе HOBA оперирует не числом запросов, а прогнозируемой нагрузкой на канал с учётом скорости клиента. Выбор метрики (RIF + латентность, нагрузка на сеть, число активных миграций) определяет, будет ли алгоритм работать.
❯ Заключение
Балансировать нужно не абстрактные запросы, а ресурс, который заканчивается.
Масштабирование не начинается с покупки самого мощного сервера или подключения случайного балансировщика. Сначала нужно понять, что именно не справляется: CPU, GPU, сеть, диск, база данных или очередь задач.
У крупных сервисов разные решения, но принцип один. Тяжёлую работу отделяют от коротких запросов, данные стараются не гонять через лишние узлы, а нагрузку измеряют метрикой, которая связана с реальной проблемой.
Для небольшого проекта не нужно копировать инфраструктуру YouTube или Яндекс Диска. На первых этапах достаточно вынести долгие операции в отдельные воркеры, ограничить число параллельных задач и при необходимости добавить несколько серверов за балансировщиком. Инфраструктура должна расти вместе с продуктом, а не опережать его.
Сайт кажется простым: ввёл адрес, нажал Enter — и через мгновение видишь страницу. Но до этого момента браузер успевает проделать целую цепочку работы: найти сервер, установить соединение, получить HTML, загрузить дополнительные файлы и собрать из них изображение на экране.
Обычно мы не замечаем эти этапы. Они становятся заметны, когда сайт начинает тормозить. Задержка может появиться ещё до обращения к серверу — например, во время DNS-резолвинга, — или уже после получения ответа, когда браузер разбирает JavaScript и строит интерфейс.
Я выбрал эту тему, потому что хотел разобраться, что именно происходит между вводом адреса и появлением страницы. Разберём этот путь от адресной строки до первого отрисованного пикселя и посмотрим, на каком этапе может возникнуть задержка.
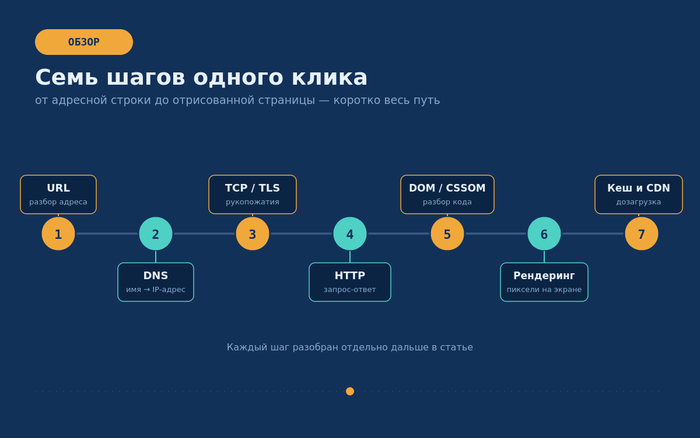
Прежде чем разбирать каждый этап подробно, полезно увидеть картину целиком.
Разбор URL — браузер понимает, что вы имеете в виду.
DNS-резолвинг — имя сайта превращается в IP-адрес.
Установка соединения — рукопожатия TCP и, для HTTPS, TLS.
HTTP-запрос и ответ — браузер спрашивает, сервер отвечает.
Разбор HTML, CSS и JavaScript — превращение кода в структуру.
Рендеринг — структура превращается в пиксели на экране.
Дозагрузка ресурсов — картинки, шрифты, кеш и CDN.
Дальше — подробно о каждом шаге.
Основные этапы загрузки страницы в браузере
❯ Сначала — вся цепочка загрузки страницы
Когда вы вводите что-то в адресную строку, браузер сначала решает: это адрес сайта или поисковый запрос. Если похоже на адрес — начинается разбор.
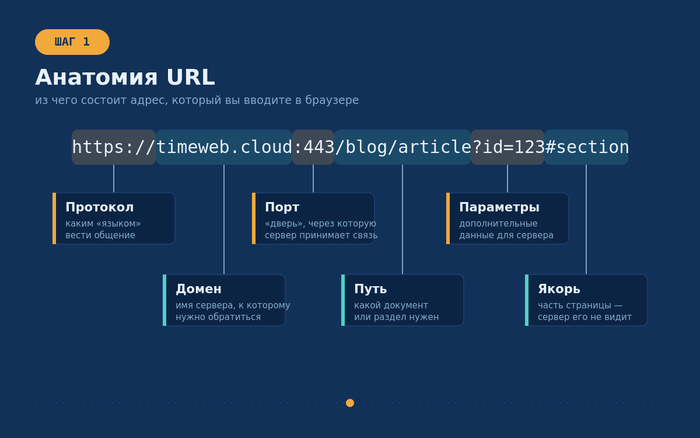
Полный URL состоит из нескольких частей.
Протокол (http или https) — по какому «языку» будет вестись общение.
Домен (например, timeweb.cloud) — имя сервера, к которому нужно обратиться.
Порт (обычно скрыт: по умолчанию 80 для http и 443 для https) — «дверь», через которую сервер принимает соединения.
Путь (/blog/article) — какой именно документ или раздел нужен.
Параметры запроса (?id=123) — дополнительные данные для сервера.
Якорь (#section) — часть страницы, к которой нужно прокрутить; сервер его даже не увидит, это забота браузера.
Прежде чем куда-то обращаться, браузер проверяет несколько вещей на месте: не сохранена ли страница в собственном кеше и не входит ли домен в список принудительного HTTPS. Это список сайтов, которые нельзя открывать по незащищенному http, даже если так написано в адресе, — он называется HSTS.
Из каких частей состоит URL
❯ Шаг 2. DNS: превращаем имя сайта в IP-адрес
Компьютеры и маршрутизаторы в интернете работают с числами — IP-адресами вида 192.0.2.1. Люди же запоминают имена: timeweb.cloud куда удобнее, чем набор цифр. Служба, которая связывает одно с другим, называется DNS — Domain Name System, или система доменных имен.
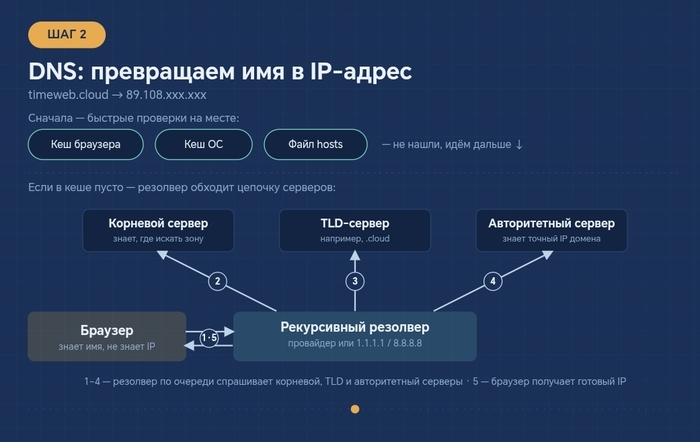
Чтобы найти IP-адрес нужного домена, браузер проходит цепочку проверок, и любая из них может дать готовый ответ и остановить поиск.
Кеш браузера — может, этот адрес уже искали недавно.
Кеш операционной системы — то же самое, но на уровне всей системы.
Файл hosts — локальный список «имя → адрес», который можно отредактировать вручную.
Рекурсивный DNS-резолвер — обычно сервер провайдера или публичный сервис вроде 1.1.1.1 или 8.8.8.8.
Если ни один из уровней не помог, в дело вступает сам резолвер. Он опрашивает корневые серверы (их адреса зашиты в каждый резолвер) и получает ссылку на серверы зоны — например, .cloud или .ru. Затем обращается к ним и получает ссылку уже на авторитетный сервер конкретного домена, который и отдает финальный ответ — IP-адрес. Результат резолвер запоминает на время, указанное в настройках домена (TTL), чтобы не повторять всю цепочку при следующем запросе.
Обычно DNS-запросы летают по протоколу UDP на порт 53 — он быстрее TCP, потому что не требует установки соединения. Часть современных браузеров и резолверов также умеет шифровать DNS-запросы через DNS-over-HTTPS или DNS-over-TLS, чтобы провайдер не видел, какие сайты вы посещаете.
Упрощённая схема поиска IP-адреса через DNS
Проверить, какой IP-адрес сейчас связан с доменом, можно самостоятельно. В терминале Linux и macOS для этого используют:
Команда покажет полученный IP-адрес и сведения об ответе DNS. Время полной загрузки страницы лучше смотреть отдельно — во вкладке Network в инструментах разработчика браузера.
❯ Шаг 3. Устанавливаем соединение: TCP и TLS
IP-адрес найден. Теперь браузеру нужно установить соединение с сервером. Для обычного HTTPS здесь участвуют два протокола: TCP отвечает за транспорт, а TLS — за шифрование.
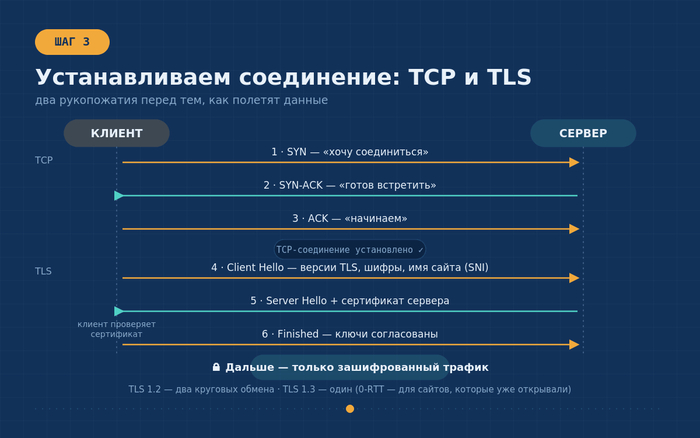
Сначала — рукопожатие TCP, протокола, который отвечает за надежную доставку данных. Оно состоит из трех сообщений: клиент отправляет SYN («хочу соединиться»), сервер отвечает SYN-ACK («принято, я тоже готов»), клиент подтверждает ACK («отлично, начинаем»). После этого обмена соединение считается установленным.
Если сайт работает по HTTPS — а сегодня это подавляющее большинство сайтов — поверх TCP сразу начинается второе рукопожатие, уже TLS, протокола шифрования. Браузер отправляет Client Hello: какие версии TLS и шифры он поддерживает, и имя сайта, к которому обращается. Это нужно, чтобы сервер с несколькими доменами на одном IP понял, какой сертификат показать. Сервер отвечает Server Hello: выбранный шифр и сертификат, который браузер проверяет на подлинность — совпадает ли имя, не истек ли срок действия, подписан ли он доверенным центром сертификации. Если все сходится, стороны договариваются об общем ключе шифрования, и дальнейшее общение становится зашифрованным.
TLS 1.3 обычно требует меньше сетевых обменов, чем TLS 1.2, поэтому соединение может установиться быстрее. При повторном подключении браузер также способен возобновить ранее созданную сессию. Режим 0-RTT возможен только при определённых условиях и не является обязательной частью каждого соединения.
HTTP/3 работает поверх QUIC — транспорта на основе UDP. В QUIC транспортные механизмы и TLS тесно связаны, поэтому при установлении соединения можно сократить число сетевых обменов. Кроме того, потеря одного пакета не обязательно блокирует передачу независимых потоков, как это может происходить при использовании TCP.
Установка TCP-соединения и TLS-рукопожатие
❯ Шаг 4. Отправляем HTTP-запрос и получаем ответ
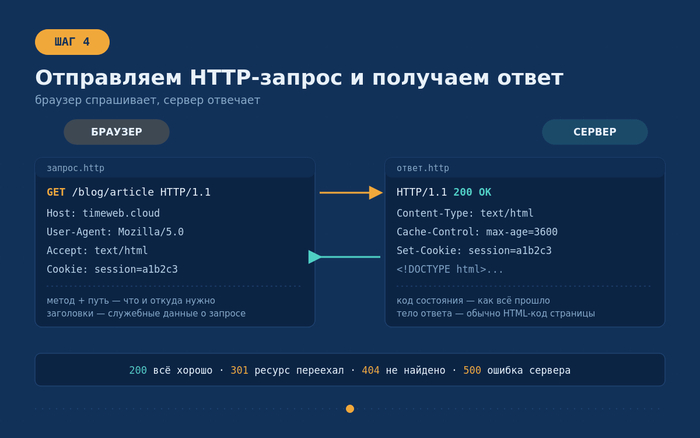
Соединение готово — можно отправлять сам запрос. Выглядит он примерно так: метод (чаще всего GET — «дай мне документ»), путь к нужной странице и набор заголовков. Заголовки — это служебная информация: какой браузер отправляет запрос, какой формат ответа он ожидает и какие cookies уже сохранены для этого сайта.
На стороне сервера запрос обычно проходит через несколько узлов. Балансировщик нагрузки распределяет его между несколькими машинами. Обратный прокси, например nginx, может сразу отдать закешированную копию страницы или передать запрос дальше — серверному приложению, которое обращается к базе данных за нужными данными. Ответ собирается в обратном порядке и уходит к браузеру.
Ответ сервера тоже состоит из нескольких частей. Код состояния показывает, как все прошло: 200 значит все хорошо, 301 — ресурс переехал, 404 — не найдено, 500 — ошибка на сервере. Дальше идут заголовки — например, тип содержимого или правила кеширования, — и тело ответа, обычно HTML-код страницы.
Важная деталь: то, как физически передаются запрос и ответ, зависит от версии HTTP. В HTTP/1.1 на одно соединение приходится один запрос за раз. Поэтому браузеры исторически открывали сразу несколько параллельных соединений к одному серверу — как правило, около шести, — чтобы грузить ресурсы одновременно. HTTP/2 решил эту проблему иначе: он умеет вести сразу много запросов и ответов в рамках одного соединения — это называется мультиплексированием. А еще он сжимает заголовки, чтобы не гонять одни и те же данные повторно. HTTP/3 пошел еще дальше и убрал саму причину проблемы, отказавшись от TCP в пользу QUIC.
Условный пример HTTP-запроса и ответа сервера
❯ Шаг 5. Браузер разбирает HTML, CSS и JavaScript
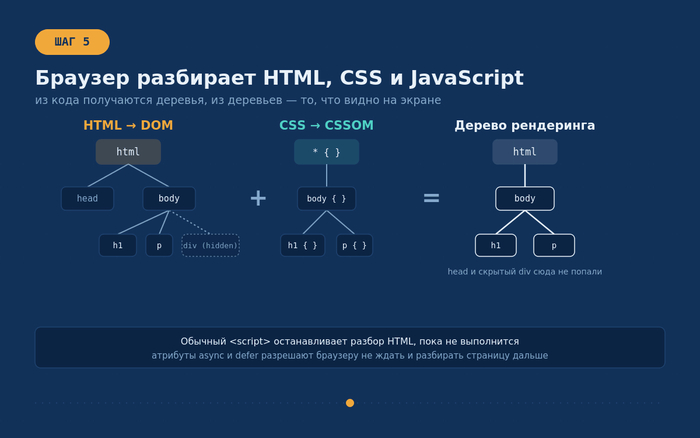
Получив HTML, браузер не ждет, пока загрузится весь документ, — он начинает разбирать его сразу, по мере поступления данных. Из тегов строится DOM — дерево, отражающее структуру документа: какие элементы вложены друг в друга, какой у них текст и атрибуты.
Стоит браузеру встретить ссылку на таблицу стилей, он запускает параллельную загрузку CSS-файла. Разобранные стили складываются в похожее дерево — CSSOM, которое описывает, как должен выглядеть каждый элемент.
JavaScript может вмешаться в этот процесс. Обычный тег <script> способен приостановить разбор HTML до загрузки и выполнения файла. Атрибуты async и defer изменяют это поведение, но работают по-разному: async запускает скрипт сразу после его загрузки, а defer сохраняет порядок выполнения скриптов и запускает их после завершения разбора документа.
Когда DOM и CSSOM готовы, браузер объединяет их в дерево рендеринга — тоже похожее на DOM. Но без скрытых элементов вроде тех, что помечены display: none, и без служебных тегов вроде head.
Как браузер превращает код в структуру страницы
❯ Шаг 6. Рендеринг: как дерево превращается в картинку
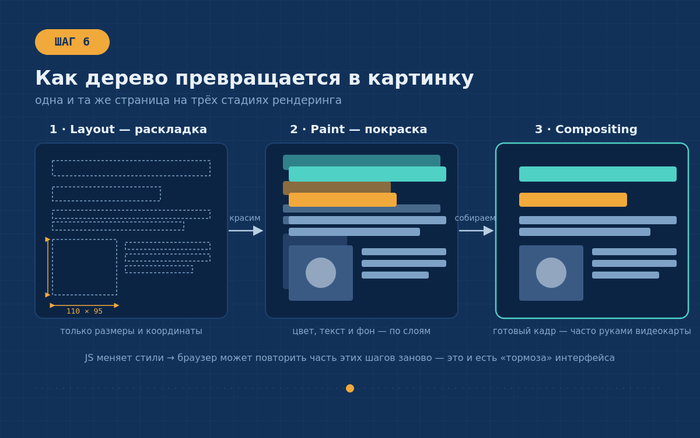
Дерево рендеринга описывает, что нужно показать, но изображением ещё не является. Сначала браузер рассчитывает размеры и координаты элементов, затем рисует их и собирает отдельные слои в итоговый кадр.
Сначала — layout, раскладка: для каждого элемента вычисляются точные размеры и координаты на странице. Затем — покраска (paint): элементы закрашиваются цветом, получают текст, границы, тени и фон, обычно на нескольких отдельных слоях. Последний этап — компоновка (compositing): все слои собираются в итоговое изображение, и часто эта работа перекладывается на видеокарту, что особенно заметно на анимациях и прокрутке.
Практическое следствие: если JavaScript потом меняет структуру или стили страницы, браузеру может понадобиться заново пройти часть этих этапов. Это стоит времени и может ощущаться как подтормаживание интерфейса. Именно поэтому в вопросах производительности веб-страниц часто советуют менять как можно меньше элементов на странице за один раз.
Три этапа формирования изображения страницы
❯ Шаг 7. Дозагрузка ресурсов, кеширование и ускорение
Первый ответ сервера — обычно только HTML. Внутри него браузер находит ссылки на картинки, шрифты, дополнительные стили и скрипты и запрашивает их тоже, по возможности параллельно.
Чтобы не гонять одни и те же файлы по сети заново, существует несколько уровней кеширования. Браузер хранит уже загруженные файлы локально и, ориентируясь на заголовки вроде Cache-Control, решает, можно ли использовать сохраненную копию вместо нового запроса. Если сайт использует CDN — сеть серверов, распределенных географически, — статичные файлы отдаются с ближайшего к пользователю сервера, а не с одного центрального. Некоторые сайты дополнительно используют service worker — скрипт, который может перехватывать запросы браузера и обслуживать их из локального хранилища даже без подключения к интернету.
Небольшие, но полезные приемы ускорения — это подсказки браузеру вроде preconnect (заранее установить соединение с нужным сервером) или preload (заранее загрузить конкретный файл, который точно понадобится).
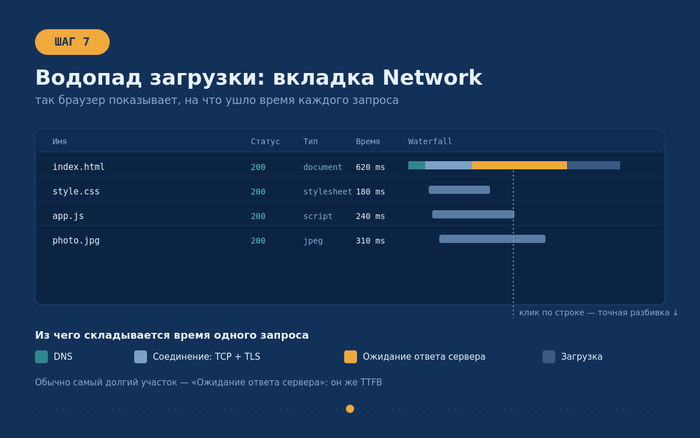
Условный пример вкладки Network и waterfall загрузки
❯ Зачем это знать на практике
При диагностике медленной загрузки обычно начинают со вкладки Network в инструментах разработчика. Она показывает, сколько времени заняли DNS, установка соединения, ожидание ответа, загрузка и обработка ресурсов. Так можно понять, на каком именно участке появляется задержка. Если долго выполняется DNS-запрос, стоит проверить резолвер. Если сервер долго отвечает, причину нужно искать в приложении, базе данных или настройках кеша. Если задержка появляется уже при рендеринге, внимание стоит обратить на JavaScript и стили.
Для тех, кто выбирает хостинг или настраивает сервер, из всей этой цепочки видно: на скорость влияет буквально каждый шаг. Играют роль близость сервера к пользователю, поддержка современных версий HTTP и TLS, настройка кеширования. Эти решения измеряются в миллисекундах и складываются в разницу, которую замечает пользователь.
❯ Итоги
Между нажатием Enter и готовой страницей происходит гораздо больше, чем кажется. Браузер может сначала обратиться к кешу, затем найти IP-адрес через DNS, установить соединение, получить HTML и только после этого начать строить изображение страницы.
Поэтому медленная загрузка — это не одна универсальная проблема. Задержка может появиться на этапе DNS, при соединении с сервером, во время ожидания ответа или уже в браузере, когда выполняется JavaScript и перерисовывается интерфейс. Вкладка Network помогает отделить один случай от другого.
❯ Что почитать дальше
MDN Web Docs, «How the web works» — подробный разбор всего пути запроса от адресной строки до отрисованной страницы (на английском языке).
RFC 9110 (HTTP Semantics) и RFC 9114 (HTTP/3) — официальные спецификации для тех, кто хочет разобраться в деталях протоколов.
Cloudflare Learning Center, статья «What is DNS» — доступное объяснение DNS-резолвинга с наглядной схемой.
Компактная и портабельная программа, четко выполняющая свое предназначение — редкая для современного мира красота и услада для глаз опытного разработчика. Именно такие проекты, реализующие серверы и клиенты для веба вы найдете в этой статье.
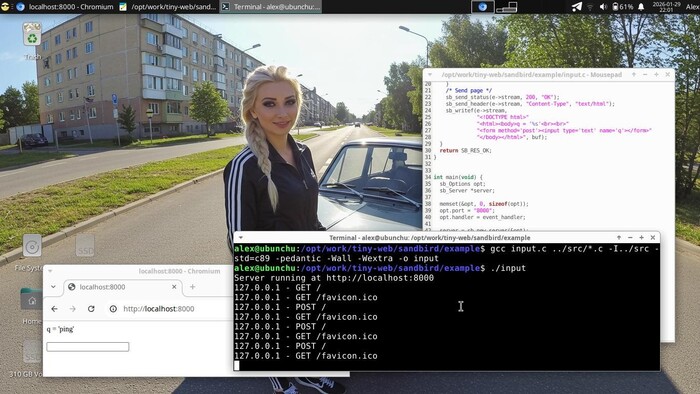
Проект "Sandbird' в действии.
Ода миниатюризации
Есть много причин, по которым миниатюрные девушк.. ээ реализации программ заслуживают внимания:
обучение — врядли получится разобраться как устроен вебсервер, перелопачивая исходники монстров вроде Apache или Nginx, спасет только миниатюрная реализация;
основа для собственных проектов — большой объем чужого исходного кода под капотом вашего проекта будет висеть гирей и отвлекать ресурсы на поддержку, в отличие от чего-то маленького и простого;
борьба с энтропией — популярные библиотеки постоянно растут и раздуваются, при этом объем используемого функционала не особо меняется. Таким образом, большая часть кода в современном проекте с кучей внешних библиотек не используется никогда.
Разумеется есть определенные риски использования таких «наколенных» библиотек, связанные с неполной реализацией, безопасностью, работой под нагрузкой и так далее.
Но говоря откровенно, всего этого хватает с головой и в больших, известных реализациях, которые вы используете каждый день на работе.
Еще с опытом приходит понимание, что любая программа — не более чем инструмент а реальную опасность всегда представляют живые люди, а не тупые машины.
Тестовое окружение
Не стал опять заморачиваться с *BSD, чтобы в третий раз не описывать специальную прослойку epoll-shim, позволяющую быстро и более-менее безболезненно портировать серверный софт с линукса. На этот раз в качестве тестового окружения выступает обычная Ubuntu Linux 25.10, хотя и с немного нестандартным ядром.
Компилятором выступит штатный же GCC, без изысков:
A tiny (~800sloc) embeddable HTTP server written in C89, compatible with Linux, OSX and Windows.
800 строк на чистом С, причем наиболее портабельного стандарта С89, c поддержкой Windows, Linux и MacOS — отличный набор для реального применения, например в качестве встроенного вебсервера для WiFi-роутера.
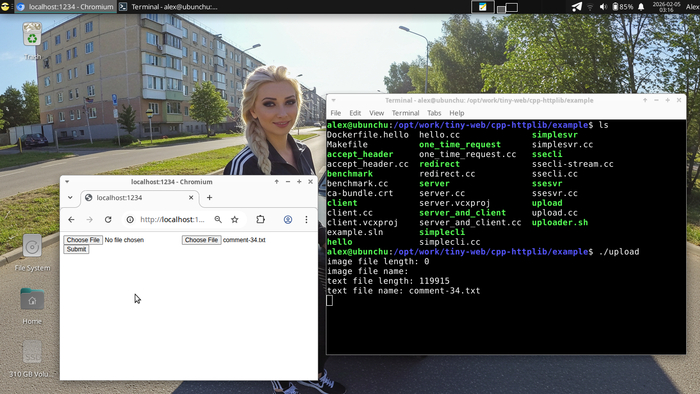
Один из примеров, демонстрирующих работу этой библиотеки — на заглавном скриншоте к статье, причем показана обработка вебформы.
Вот так выглядит сборка примера:
cd example gcc hello.c ../src/*.c -I../src -std=c89 -pedantic -Wall -Wextra -o hello
Так выглядит код тестового приложения с использованием этой библиотеки:
К сожалению этот интересный проект по большей части прототип, иллюстрирующий как можно на коленке без внешних библиотек реализовать серверную сторону вебсокетов на чистом С.
В случае реального использования, столь вольное использование malloc для обработки входящих пакетов быстро превратится в проблему:
.. /* deal with normal frames (non-fragmented) */ if (WEBSFR_GET_OPCODE(frm.info) != 0x0) { /* read data */ if (data) free(data); data = malloc(frm.length + 1); ..
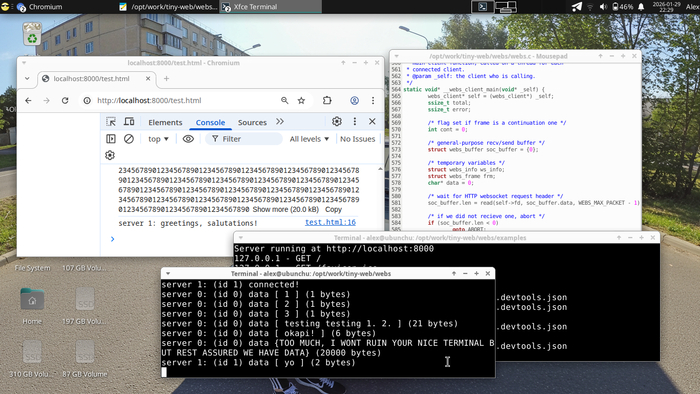
Так выглядит сокращенная версия тестового сервера вебсокетов, c минимумом обработчиков:
#include "../webs.h"
int myFuncZ(webs_client* self) { printf("server %ld: (id %ld) connected!\n", self->srv->id, self->id); webs_send(self, "greetings, salutations!"); return 0; } int myFunc2(webs_client* self) { printf("server %ld: (id %ld) disconnected!\n", self->srv->id, self->id); return 0; } int main(void) { webs_server* server1 = webs_start(7754); if (!server1) { printf("failed to initialise a server.\n"); return 1; } server1->events.on_open = myFuncZ; server1->events.on_close = myFunc2;
Как видно из кода выше, все интересное происходит именно в обработчиках, где собственно и будет находиться ваша собственная логика, если вдруг решитесь использовать эту штуку.
Повторюсь, что весь этот проект, несмотря на всю свою интересность — сырой прототип и тащить в прод подобный код без переработки, "as-is" точно не стоит.
Собирается только для Linux и только с помощью gcc.
Реализуют весьма продвинутый HTTP/HTTPS сервер и клиент, причем фактически в одном файле. Есть поддержка сборки как на Linux так и Windows, причем для второй есть готовый проект для Visual Studio.
Разумеется это не мейнстрим и к качеству есть вопросы, зато все уместилось в очень небольшом коде, без особых ухищрений по миниатюризации и потому вполне читаемому.
Так выглядит сборка тестового сервера, использующего эту библиотеку:
Всего 1.5к строк на С++11 от безвестного китайского автора реализуют полнофункциональный FTP/FTPS‑сервер — с chroot, поддержкой локальных и анонимных юзеров и всем прочим.
FTPS это довольно редко встречающееся расширение протокола FTP, с поддержкой шифрования передачи данных. Не набравшее большой популярности ввиду появления SFTP и органичений самого FTP и потому мало известное широкой админской публике.
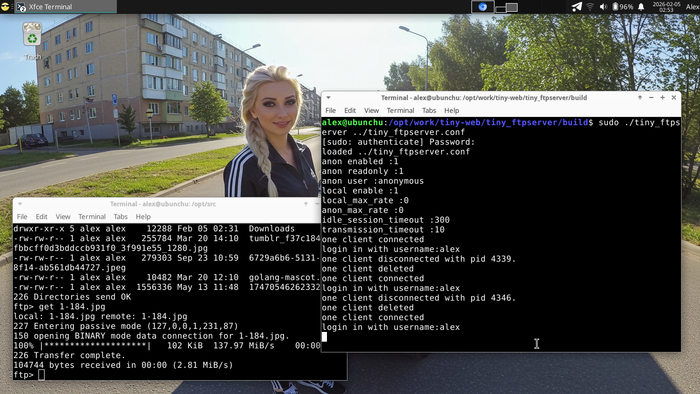
В работе:
Проект использует известную библиотеку libnet, о чем автор забыл сообщить и которую необходимо установить до сборки:
apt install libnet1-dev
Сама сборка происходит с помощью обычного cmake:
mkdir build && cd build cmake ..
Реализация FTP-сервера тут максимально классическая — используется chroot а использование 21 и 20 портов зашито в код:
Все это означает, что запускать сервер придется от суперпользователя:
sudo ./tiny_ftpserver ../tiny_ftpserver.conf
У этого проекта есть один неожиданный нюанс:
на самом деле это.. студенческая работа.
И подобныхпроектов на Github оказалось великоемножество. Так что далеко не везде в 2026м году забыли что такое высшее техническое образование, что не может не радовать.
FineFTP is a minimal FTP server library for Windows and Unix flavors.
~2k строк на С++14 реализуют FTP-сервер в виде.. библиотеки!
В этом и есть основная фишка этого проекта — возможность встроить FTP (причем сервер а не клиент) в ваше собственное приложение.
Так выглядит код примера, с внедрением FTP-сервера:
#include <fineftp/server.h> #include <thread>
int main() { // Create an FTP Server on port 2121. We use 2121 instead of the default port // 21, as your application would need root privileges to open port 21. fineftp::FtpServer ftp_server(2121);
// Add the well known anonymous user. Clients can log in using username // "anonymous" or "ftp" with any password. The user will be able to access // your C:\ drive and upload, download, create or delete files. On Linux just // replace "C:\\" with any valid path. FineFTP is designed to be cross-platform. ftp_server.addUserAnonymous("C:\\", fineftp::Permission::All);
// Start the FTP Server with a thread-pool size of 4. ftp_server.start(4);
// Prevent the application from exiting immediately for (;;) std::this_thread::sleep_for(std::chrono::milliseconds(100)); return 0; }
Зачем и для чего такое может быть нужно — другой вопрос, все же обычно работу с файлами в конечном приложении (например обновление прошивки) стараются реализовать в виде клиента и через HTTP/HTTPS.
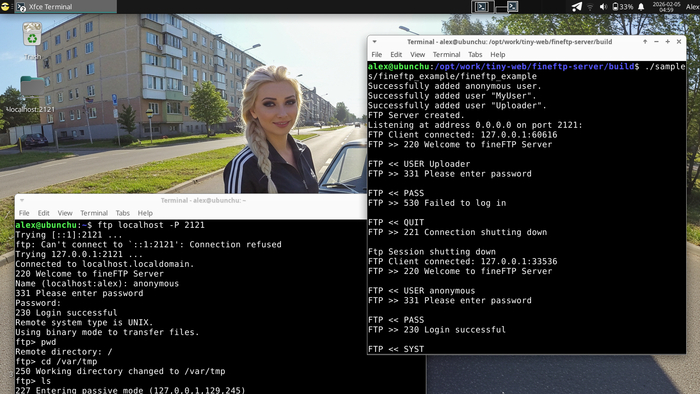
Но с точки зрения использования все отлично работает:
Это хорошая, взрослая библиотека, с несколькими коммитерами, с историей разработки, которая активно поддерживается и развивается.
Старого цирка с chroot и 21м портом тут нет, поэтому все работает без привилегий суперпользователя — на скриншоте выше как раз видно использование нестандартного порта для работы.
Поддерживается сборка для Linux, MacOS и Windows c приоритетом для последней.
Отличный проект, но далеко не последний в сегодняшней подборке.
Этот проект — привет из далекого и славного прошлого:
This is a modern re-implementation of rcp (remote copy protocol) daemon, originally part berkeley r-commands.
Да, это самый настоящий сервер RCP, всего 300 строк на Golang от знаменитого в узких кругах компьютерных реконструкторов автора Tenox.
RCP, если кто вдруг не знает, это такой устаревший протокол передачи файлов между компьютерами с UNIX, мало пригодный для использования в современных реалиях, ввиду отсутствия какого-либо шифрования и авторизации.
Но крайне актуальный, если имеете дело с устаревшим оборудованием или встраиваемыми системами, которые до сих пор используют rcp для например загрузки обновлений прошивок по сети.
Возвращаясь к проекту:
rcpd от Tenox реализует серверную сторону — сервер RCP
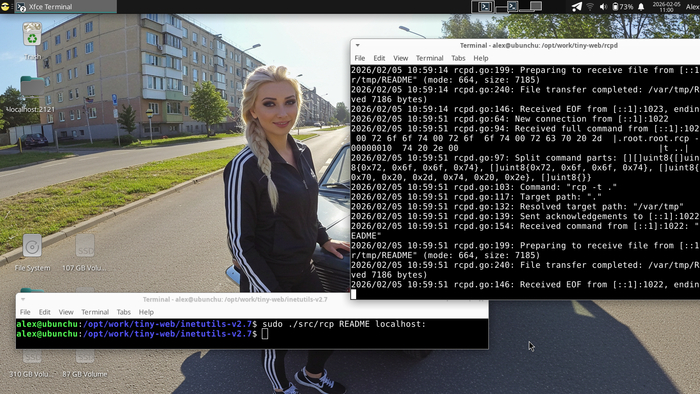
К этому серверу подключаются клиенты для загрузки или скачивания файлов. Так выглядит процесс копирования файла, в качестве клиента тут rcp из пакета GNU Inetutils:
Как видите и клиент и сервер запускаются от суперпользователя — такие были времена, RCP использует 514 порт, который нельзя занять без привилегий.
Сборка:
go build -o rcpd .
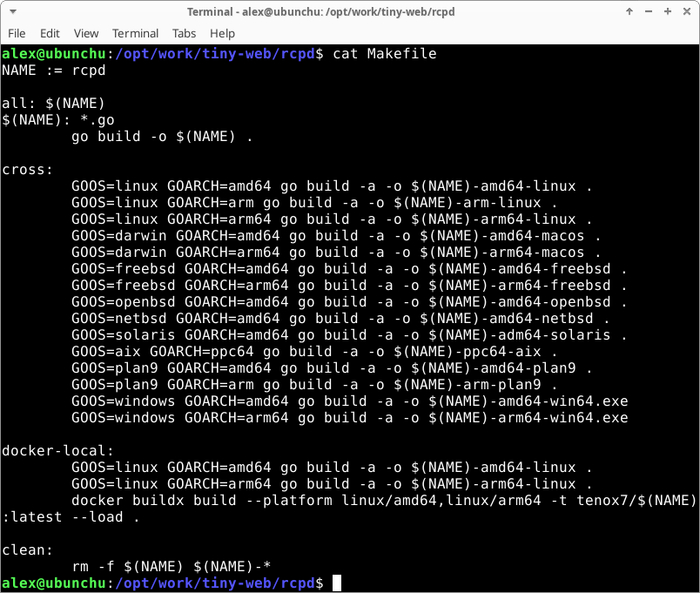
Кстати в Makefile проекта есть поддержка кроссплатформенных сборок, с весьма богатым выбором:
Стоит добавить, что протокол RCP сам по себе очень простой и не менялся весь период своего существования, что позволяет подключаться к этому RCP-серверу 21 века даже с помощью клиентских программ из 80х и 90х.
За кадром
Детально разобрать удалось лишь малую часть интересных находок, поэтому ниже буквально одной строкой про интересные миниатюрные, точно заслуживающие внимания.
В Bash встроен синтаксис виртуальных путей вида /dev/tcp/host/port. Если попытаться открыть такой "файл" через редирект, Bash перехватит запрос и сам поднимет TCP-соединение.