
0 просмотренных постов скрыто


Alibaba показала свой самый мощный ИИ-чип. Купить его нельзя, и это главное, что нужно о нём знать
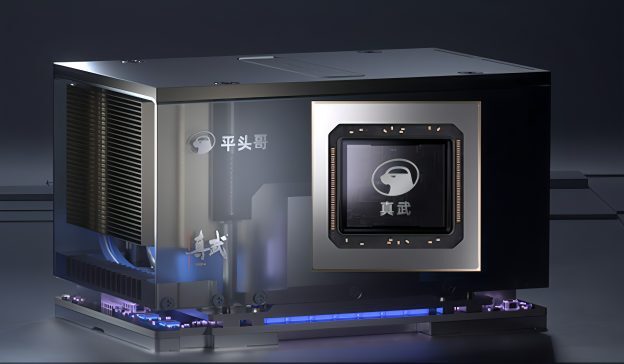
Alibaba представила ускоритель Zhenwu V900 — по словам гендиректора Эдди У, самый мощный ИИ-чип, сделанный в Китае. Акции компании подскочили. Разбираем два практических вопроса: когда это можно получить и насколько оно лучше того, что есть.
Когда
Массовое производство и коммерческий запуск запланированы на первый квартал 2027 года. То есть прямо сейчас это анонс, а не товар.
Причём «купить» здесь в принципе неверное слово. Zhenwu не продаётся в рознице и не встанет в домашний компьютер: это серверный ускоритель, который едет либо в собственные дата-центры Alibaba Cloud, либо к корпоративным клиентам. Доступ к нему обычный человек получает так же, как к любому облачному GPU, — арендуя вычисления. Суммарно чипов линейки Zhenwu отгружено уже 560 тысяч штук более чем четырёмстам клиентам в двух десятках отраслей.
Насколько лучше
Главная заявленная цифра — втрое выше производительность, чем у предшественника M890, который вышел всего в мае. Из характеристик называют 216 ГБ памяти на ускоритель, 1200 ГБ/с межчиповой пропускной способности, нативную поддержку форматов FP8 и FP4 и возможность собирать кластеры до 500 тысяч чипов.
А вот честный ответ на «лучше ли, чем у Nvidia»: прямых сравнений с актуальными флагманами Nvidia никто не приводит. Ориентир, который упоминают, — что предыдущий M890 по общей производительности был сопоставим с H20. Стоит помнить, что H20 — это не топовая Nvidia, а специально урезанная версия, которую делали под экспортные ограничения для Китая. Так что рост втрое — это рост относительно довольно скромной базовой планки, а не обгон Blackwell.
Зачем это Alibaba
Чип нужен под конкретную задачу: компания собирается обучать модель на 5–10 триллионов параметров. Для сравнения, нынешний флагманский Qwen работает примерно на 2,4 триллиона — то есть речь о скачке в два-четыре раза. Обучать такое на чужом железе Китаю попросту не на чем: американские экспортные ограничения отрезали и топовые ускорители Nvidia, и доступ к TSMC. Zhenwu Alibaba называет отечественным, а разрабатывает его собственное подразделение T-Head.
Под это подписаны и деньги: более 53 миллиардов долларов в ИИ за три года и цель выйти на 20 гигаватт дата-центровых мощностей к 2032 году.
Что может пойти не так
Два узких места, и оба вне контроля Alibaba. Первое — производство: отечественные фабрики должны вытянуть нужный объём с приемлемым выходом годных, и если не вытянут, сроки поедут. Второе назвал сам Эдди У: глобальный дефицит по всей цепочке поставок для ИИ-дата-центров ограничивает скорость расширения. Памяти, стоек и питания сегодня не хватает всем, включая тех, у кого с чипами проблем нет.
Так что пока это заявка, а не факт на складе. Проверять её будем в начале 2027-го.
Источники: CNBC, Investing.com, CryptoBriefing
Показать полностью

Anthropic создаёт собственный ИИ-чип для Claude — Nvidia получила нового соперника
Компания Anthropic, разработчик семейства моделей Claude, формирует собственную команду по разработке специализированных процессоров для искусственного интеллекта.
Компания уже нанимает инженеров, которые должны совместно оптимизировать аппаратное обеспечение и ИИ-модели. Цель — повысить производительность Claude, снизить стоимость вычислений и эффективнее масштабировать инфраструктуру по мере роста моделей и числа пользователей. Reuters подтверждает, что речь идёт именно о формировании внутренней команды по проектированию кастомных ИИ-чипов.
Однако это не означает, что Anthropic завтра откажется от Nvidia.
Компания уже использует сразу несколько аппаратных платформ. Claude обучается и работает на AWS Trainium и Nvidia GPU, а Amazon остаётся основным облачным и тренировочным партнёром Anthropic. Такой подход позволяет распределять разные нагрузки между архитектурами, наиболее подходящими для конкретных задач.
Масштаб инфраструктуры уже огромен. Anthropic сообщала об использовании более миллиона AWS Trainium2, а новое соглашение с Amazon предусматривает до 5 ГВт дополнительных вычислительных мощностей. Параллельно компания расширяет сотрудничество с Google и другими поставщиками инфраструктуры.
Собственный процессор может дать Anthropic ещё одно преимущество: оптимизировать архитектуру непосредственно под особенности Claude, вместо того чтобы адаптировать модель к универсальным ускорителям.
И компания явно рассматривает аппаратное направление всерьёз. В августе Reuters сообщил, что Anthropic обсуждала приобретение стартапа MatX, основанного бывшими инженерами Google TPU. Возможная стоимость сделки оценивалась примерно в $7 млрд, хотя впоследствии обсуждение сместилось в сторону партнёрства.
Разработка передового ИИ-чипа — чрезвычайно дорогой проект. По отраслевым оценкам, только создание современного специализированного процессора может потребовать порядка $500 млн, ещё до масштабного производства и строительства соответствующей программной экосистемы.
Но для крупнейших разработчиков искусственного интеллекта собственное железо становится всё более привлекательным. Google давно развивает TPU, Amazon — Trainium, а OpenAI также работает над собственной аппаратной стратегией.
Теперь к этой гонке присоединяется Anthropic.
Если компания действительно создаст процессор, глубоко оптимизированный под Claude, следующая битва между разработчиками ИИ будет идти уже не только между моделями — Claude, ChatGPT и Gemini будут конкурировать целыми вертикальными вычислительными платформами.
Показать полностью
Intel Foundry взрывает индустрию: Процессоры 240x240 мм уже здесь!
Intel Foundry разрабатывает новый класс сверхкрупных многокристальных корпусов для искусственного интеллекта и высокопроизводительных вычислений. Концепция получила название Hyper-Large Form Factor — HLFF, а самые амбициозные варианты предусматривают размеры до 240×240 мм.
Это не один гигантский монолитный процессор. Внутри такого корпуса Intel планирует объединять множество специализированных вычислительных чиплетов, кэш, интерфейсы ввода-вывода и большое количество стеков высокоскоростной памяти HBM. По сути, один корпус превращается в целую вычислительную систему — «кремниевую мозаику».
Главное ограничение современных чипов связано с размером фотолитографического шаблона — reticle limit. Один монолитный кристалл нельзя бесконечно увеличивать, поэтому производители переходят к чиплетам и передовой упаковке.
Intel использует технологии EMIB, EMIB-T и Foveros, позволяющие соединять отдельные кристаллы высокоскоростными мостами и формировать систему значительно больше стандартного фотошаблона. В 2026 году компания говорит о комплексах более 8× reticle, а к 2028 году планирует выйти за 12×, разместив в одном устройстве 16 и более стеков HBM4/HBM5.
Но Intel исследует и намного более экстремальный вариант. На ECTC 2026 инженеры представили архитектурную концепцию корпусов размером до 240×240 мм, соответствующих приблизительно 24-кратной площади стандартного фотошаблона. В более дальней перспективе рассматриваются даже панельные конструкции почти до 50× reticle.
Одна из главных проблем таких огромных систем — механическая деформация и упаковка. При увеличении площади подложка может изгибаться, а между многочисленными кристаллами и компаундом возникают пустоты. Intel сообщает, что разработала процесс инкапсуляции без пустот и уже проверила его на экспериментальных системах с семью кристаллами. Исследовательская технология упаковки продвинулась примерно до 7× reticle.
Такие конструкции создаются прежде всего для ИИ и HPC, где необходимо соединять всё больше вычислительных блоков с огромными объёмами HBM и обеспечивать между ними колоссальную пропускную способность.
Возможно, следующий этап развития процессоров — это уже не уменьшение одного кристалла, а превращение корпуса чипа в полноценный миниатюрный суперкомпьютер.
Станут ли гигантские чиплетные системы главным оружием Intel в борьбе с Nvidia, AMD и TSMC?
Показать полностью
Китаю больше не нужен EUV?
Китаю больше не нужен EUV? Пока говорить об этом рано — но направление становится всё интереснее.
Вместо простой гонки за всё меньшими кремниевыми транзисторами исследователи изучают совершенно другие подходы: двумерные материалы толщиной в несколько атомов, MoS₂-транзисторы, волновые вычисления, фотонику и память, где состояние может определяться буквально единичными электронами. Именно с этого вопроса начинается наш большой выпуск о том, что может прийти после кремния. Главная интрига: сможет ли Китай не просто догонять лидеров в традиционной микроэлектронике, а развивать альтернативные технологии, уменьшающие зависимость от самых передовых производственных процессов?
Полный выпуск уже на канале Xenon Lab.
Показать полностью
AMD ШОКИРОВАЛА ВСЕХ! AM5 БУДЕТ ЖИТЬ ДО 2029 ГОДА!
AMD продолжает делать ставку на долгоживущие платформы. Компания официально объявила, что сокет AM5 будет поддерживаться до 2029 года, сохраняя возможность устанавливать новые поколения процессоров Ryzen без обязательной замены материнской платы. Платформа появилась ещё в 2022 году вместе с Ryzen 7000 и уже пережила несколько поколений процессоров.
Следующим большим этапом станет архитектура Zen 6. AMD ранее подтвердила её для 2026 года, а настольному семейству приписывается кодовое название Olympic Ridge. После него компания перейдёт к Zen 7 — уже официально подтверждённой следующей архитектуре процессорных ядер AMD.
В серверном сегменте AMD уже раскрыла дальнейшую дорожную карту: EPYC Florence на Zen 7 появится в 2028 году, а следующее поколение EPYC Ravenna на Zen 8 запланировано на 2030 год.
И именно здесь появляется самая интересная часть. По неофициальным данным, настольные Ryzen на Zen 7 могут стать последним крупным поколением для AM5. Если AMD сохранит привычный интервал между серверными и потребительскими архитектурами, такие процессоры действительно могут появиться примерно к завершению заявленного срока поддержки AM5.
Следующий этап — предполагаемый AM6. Утечки связывают новую платформу с архитектурой Zen 8, оперативной памятью DDR6 и интерфейсом PCIe 6.0. Однако AMD пока не подтверждала ни название AM6, ни характеристики будущего настольного сокета. Поэтому DDR6 и PCIe 6.0 пока следует воспринимать как ожидаемые характеристики, а не окончательные спецификации.
Если такой сценарий подтвердится, владельцы AM5 получат чрезвычайно длинный цикл обновления: одна материнская плата сможет поддерживать процессоры на протяжении большей части десятилетия.
Стоит ли сейчас собирать компьютер на AM5 и обновиться позднее до Zen 7 — или лучше дождаться нового поколения AM6?
Показать полностью
Ozon, помогите вернуть процессор, забытый в в возврате №104039431-R12
Приветствую! Обращаюсь к представителям Ozon здесь, так как стандартная поддержка в чате приложения присылает автоматические отписки, а ситуация критическая и требует ручного вмешательства.Суть проблемы: 28 августа я оформил и сдал в ПВЗ возврат материнской платы. Из пункта выдачи посылку забрали ориентировочно 30 августа. Номер заявки на возврат: 104039431-R12.При отправке я совершил серьезную ошибку — в спешке забыл извлечь из сокета платы свой личный процессор intel core 13700kf . Это дорогая комплектующая, которая покупалась отдельно, полностью принадлежит мне и не имеет никакого отношения к возвращаемому товару.Поскольку прошло уже больше двух недель, посылка либо находится на финальной стадии доставки, либо уже прибыла на склад приёмки Ozon.Почему я пишу сюда: Я понимаю, что это моя невнимательность. Но сейчас единственный способ спасти вещь — это передать информацию на склад приёмки возвратов. Я очень прошу сотрудников склада Ozon при вскрытии коробки (которое фиксируется на видео) составить акт о несоответствии вложения, зафиксировать излишек и не утилизировать мой процессор.Я готов полностью оплатить обратную пересылку процессора за свой счет или забрать весь возврат обратно (вместе с платой), если склад отклонит заявку из-за некорректной комплектации.Уважаемый Ozon! Пожалуйста, помогите составить внутренний срочный запрос на склад приёмки, пока посылку не обработали «на автомате».
Готов предоставить любые чеки и доказательства того, что процессор мой. Жду от вас новостей.

Ваш процессор спит на работе. Показываем, как это прекратить
Пакет приезжает в сервер. Миллисекунды на счету. А ядро процессора в этот момент — в глубоком сне, и его сначала надо разбудить.
Кто виноват? Энергосбережение.
Linux из коробки умеет экономить энергию и не держит процессор постоянно в режиме максимальной производительности.
За производительность отвечает CPUFreq: governor задаёт политику, а драйвер и сам процессор выбирают подходящий P-state. В результате частота может гулять вверх-вниз.
За сон — отдельная история: простаивающее ядро уходит в C-state.
Для обычного веб-хостинга это разумно. Для высокочастотного трейдинга, VoIP и других систем, чувствительных к задержкам, это уже может стать проблемой. Выход из глубокого C-state занимает микросекунды. Микросекунды складываются в джиттер, лаги и потерянные тики.
Сначала — как устроен сон процессора. Есть несколько состояний, и это почти как на работе:
C0 — работает. Исполняет инструкции, кофе, всё такое.
C1/C1E — задремал на стуле. Исполнение остановлено, но просыпается быстро.
C3/C6 и глубже — уехал домой. Всё больше блоков процессора переводится в энергосберегающий режим.
Экономия растёт с глубиной сна. Но вместе с ней обычно растёт и время выхода из idle.
Правило простое: чем глубже уснул, тем дороже просыпаться.

Ядро без работы, тихо сваливающее в C6.
Теперь лечение. Понадобятся две утилиты: cpupower — смотреть и крутить параметры CPU, и tuned — применять готовые профили настройки системы.
Ubuntu/Debian:
sudo apt update
sudo apt install linux-tools-common linux-tools-generic tuned -y
CentOS/RHEL:
sudo dnf install kernel-tools tuned -y
И запускаем демон, чтобы настройки переживали перезагрузку:
sudo systemctl enable --now tuned
Шаг второй — смотрим, что сейчас
Сначала — политика управления частотой:
cpupower frequency-info
В выводе ищем блок current policy: минимальную и максимальную частоты, активный governor и используемый scaling driver.
Для наглядности можно посмотреть и на частоты из /proc/cpuinfo:
watch -n 1 "grep 'cpu MHz' /proc/cpuinfo"
Но воспринимать это как точный осциллограф не стоит: на современных CPU реальная частота может меняться быстрее, чем успевает обновляться такой вывод.
Теперь смотрим idle-состояния:
cpupower idle-info
А если хочется увидеть, сколько времени CPU действительно проводит в разных состояниях:
sudo cpupower monitor -i 1
Вот это уже интереснее. Мы можем не только что-то настроить, но и потом проверить, действительно ли процессор перестал проводить время в глубоких C-states.

Смотрим, как частоты и idle-состояния живут своей жизнью.
Дальше — профиль. Вместо ручной крутилки десятков параметров у TuneD есть готовые профили. Для систем, чувствительных к задержкам, нас интересует latency-performance.
tuned-adm list
sudo tuned-adm profile latency-performance
tuned-adm active
Профиль переводит CPU в режим, ориентированный на производительность: включает performance, поднимает минимально запрашиваемый уровень производительности и отключает часть энергосберегающих оптимизаций.
Процессор перестаёт экономить на каждом удобном случае.
Но физическая частота всё ещё может меняться. Причины: Turbo, аппаратное управление производительностью, ограничения по температуре и мощности. Поэтому правильнее говорить не «частота прибита гвоздями», а «система больше не пытается агрессивно её занижать».
Для сетевых задач у TuneD есть родственный профиль network-latency, но сегодня мы говорим именно про latency-performance.
Но есть нюанс: частота — это P-states. Глубокий сон — C-states.
Сам Governor запретить ядрам уезжать домой не может.

Нельзя просто взять и запретить процессору спать через Governor.
Но мы включили не просто Governor, а профиль TuneD.
latency-performance знает про эту проблему и ограничивает допустимую задержку выхода из idle через PM QoS. В результате CPUIdle перестаёт выбирать слишком глубокие C-states с большой exit latency.
То есть в большинстве случаев на этом уже можно остановиться.
Проверяем:
tuned-adm verify
sudo cpupower monitor -i 1
Если профиль применён корректно, в мониторинге должно быть видно, что процессор перестал надолго проваливаться в глубокие idle-состояния.
А если хочется жёстче?
Иногда хочется не попросить CPUIdle избегать глубоких состояний, а вообще не давать драйверу их использовать.
Тогда можно ограничить C-states через параметры ядра.
Но сначала нужно понять, какой CPUIdle-драйвер работает:
cat /sys/devices/system/cpu/cpuidle/current_driver
Если используется intel_idle, можно ограничить его, например:
intel_idle.max_cstate=1
Если используется acpi_idle:
processor.max_cstate=1
Ориентироваться только на логотип Intel или AMD здесь не стоит. Важен именно активный CPUIdle-драйвер.
На Ubuntu/Debian параметры обычно добавляют в /etc/default/grub в строку:
GRUB_CMDLINE_LINUX_DEFAULT="..."
После чего:
sudo update-grub
И перезагрузка.
На RHEL/CentOS удобнее использовать grubby, например:
sudo grubby --update-kernel=ALL --args="intel_idle.max_cstate=1"
Для acpi_idle соответственно:
sudo grubby --update-kernel=ALL --args="processor.max_cstate=1"
После перезагрузки проверяем ещё раз:
cpupower idle-info
sudo cpupower monitor -i 1
Теперь глубокие idle-состояния должны быть недоступны или практически не использоваться — в зависимости от выбранного способа настройки.
Послесловие
Итог: сервер стал прожорливее и горячее (а счета за электричество весомее), зато ядрам больше не дают проваливаться в глубокий сон.
Пакет приехал — разбудить процессор можно гораздо быстрее.
Если процессор не уходит в глубокий сон, из латентности исчезает ещё один источник непредсказуемости.
Для трейдинга, VoIP и других систем, чувствительных к задержкам, это как раз тот случай, когда микросекунды действительно имеют значение.
Показать полностью
3