
Кто страшнее – урщух или лимень?
Стрела, стремительный, стриж, струя, ястреб – все это быСТРые вещи. Лилия, мимоза, лань – МиЛые и Нежные. "Хрип" ХРипит, «шелест» Шелестит, а хрыч и карагач отличаются редкой корявостью.
Почему так? Есть ли в этом реальная закономерность или мы имеем дело с очередной лингвистической шизой и фоменковщиной? Существуют ли какие-нибудь объективные принципы, по которым люди наделяют звуки теми или иными качествами?
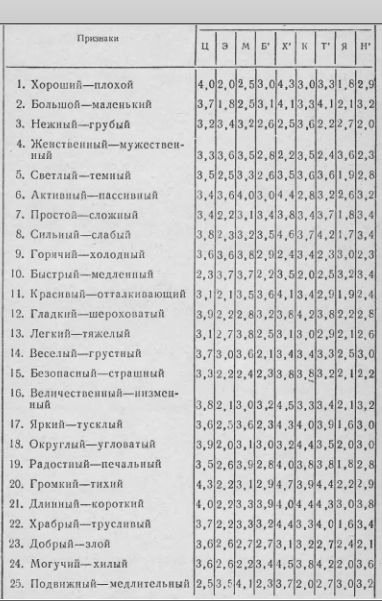
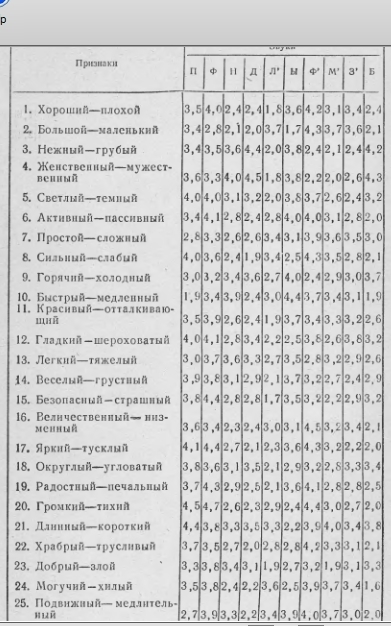
Для начала попробуйте ответить на вопрос: слово «облако» округлое или скорее угловатое? А слово «зигзаг»? Если вы ответили что облако округлое, а зигзаг угловатый, то поздравляю – вы попали в подавляющее статистическое большинство. Но вы можете мне возразить: все мы знаем, как выглядят облако и зигзаг, неудивительно, что образы предметов мы переносим и на их звучание. Хорошо, давайте тогда ответим на такой вопрос. Кто страшнее – урщух или лимень? Представьте их обоих, оцените с позиции хорошести, угрозы… Статистика показывает, что урщух оказывается гораздо страшнее лименя. Что за статистика, спросите вы? В 80-х годах в России лингвист по фамилии Журавлёв провёл множество экспериментов, чтобы понять какими нам слышатся звуки. Оказалось, что каждый звук имеет довольно чёткую, повторяющуюся характеристику в нашем сознании. Что Р, например оказывается сильным, смелым. Х – плохим и так далее.
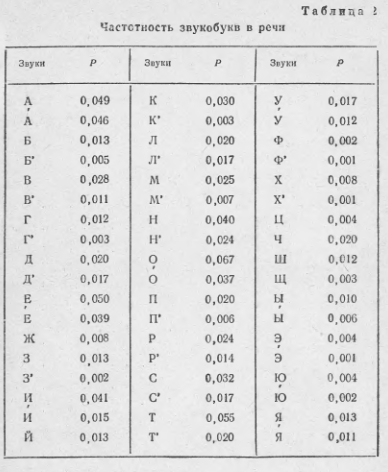
Вслед за экспериментами, накопив материал и составив таблицу характеристики всех звуков, он принялся за расчёты, чтобы понять, как из их набора создаётся образ слова. Оказалось, что вес звуков в составлении этого набора неодинаков. Например, те,, что встречаются редко, влияют гораздо сильнее на наше восприятие, чем частые. То есть условный Ф, Ц или Щ могут забить собой весь эффект прочих букв слова, перетянуть его на свои характеристики. А если такая буква будет ещё и первой в слове… Выяснилось, что первый звук слова влияет на его образ в нашем сознании примерно в четыре раза сильнее, чем все остальные. Так родилась формула, по которой можно подсчитать характеристику каждого слова.
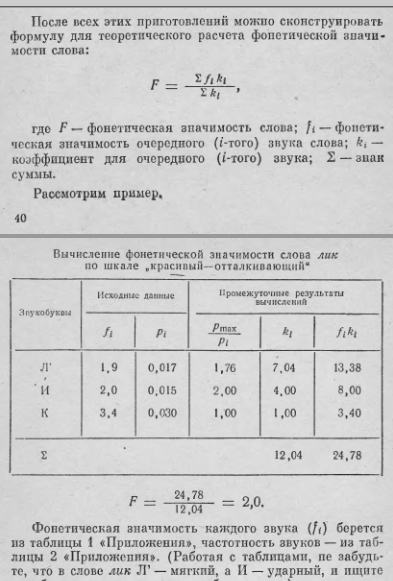
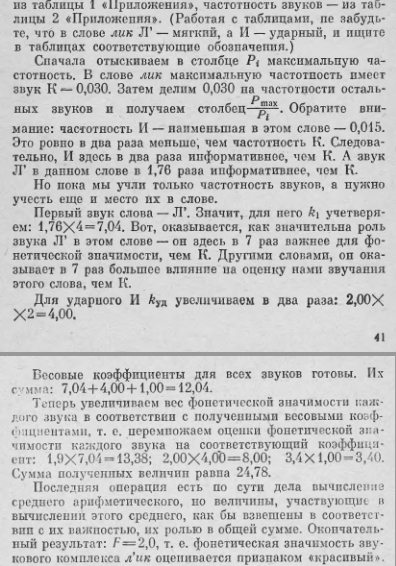
Чтобы проверить эту формулу, ученый загнал в компьютер несколько слов. Понятно, что большинство характеристик оказывались в районе нейтральной части, учитывались только крайние значения. Вот, например, какие результаты у него получались:
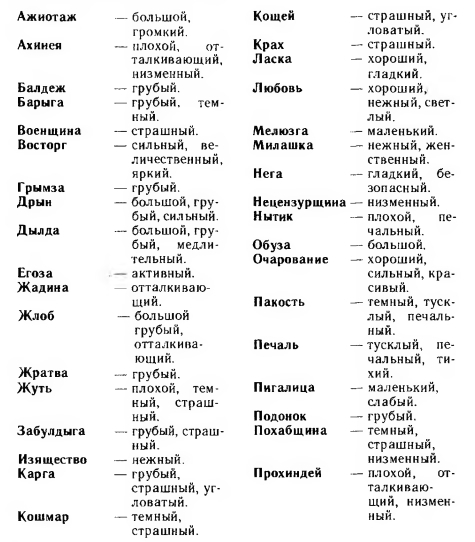
Понятно, что далеко не все слова придумываются в соответствии с их звучанием. И нередко случается так, что слово, чьё звучание имеет чёткую характеристику, совсем не предполагает такого же значения. Если значение и звучание не входят в сильный конфликт, то слово функционирует как есть. А вот если конфликт между ними оказывается серьёзным, то это может и повлиять на судьбу слова… Например, «юноша» по этой формуле оказалось чем-то женственным, нежным и слабым. А теперь скажите, часто ли вы используете это слово в отношении молодых людей? Но как же так вышло, ведь раньше же его использовали, и ничего? Ну во-первых, мы не можем гарантировать, что тысячу лет назад все звуки воспринимались такими же, как сейчас. А во-вторых, вообще-то и не использовали. Древнерусский вариант этого слова звучал как «унош» - и это вполне мужественное звучание с точки зрения фонетики.
Или например, согласно этой формуле слово «женщина» получило признаки «темный, отталкивающий, тяжелый, устрашающий, низменный, злой». Ну и часто ли вы используете это слово вне контекста «женщщщщина, куда вы лезете»?
Вообще, если интересно, можете почитать его книгу «Звук и смысл» - там интересно, и про имена, и про заимствования, и про синестезию, и подробнее про сам ход эксперимента и выработку формулы. И даже предвидение нейронок, правда автор предлагал, чтобы компьютер определял содержание слова по его звучанию.
А вы теперь можете рассчитать характеристики любого слова, опираясь на эту таблицу, и сравнить их с личными впечатлениями.



Автор - Виолетта Хайдарова
Подписывайтесь, чтобы не пропустить новые посты!
Наука | Научпоп
9.9K поста83.3K подписчиков
Правила сообщества
Основные условия публикации
- Посты должны иметь отношение к науке, актуальным открытиям или жизни научного сообщества и содержать ссылки на авторитетный источник.
- Посты должны по возможности избегать кликбейта и броских фраз, вводящих в заблуждение.
- Научные статьи должны сопровождаться описанием исследования, доступным на популярном уровне. Слишком профессиональный материал может быть отклонён.
- Видеоматериалы должны иметь описание.
- Названия должны отражать суть исследования.
- Если пост содержит материал, оригинал которого написан или снят на иностранном языке, русская версия должна содержать все основные положения.
- Посты-ответы также должны самостоятельно (без привязки к оригинальному посту) удовлетворять всем вышеперечисленным условиям.
Не принимаются к публикации
- Точные или урезанные копии журнальных и газетных статей. Посты о последних достижениях науки должны содержать ваш разъясняющий комментарий или представлять обзоры нескольких статей.
- Юмористические посты, представляющие также точные и урезанные копии из популярных источников, цитаты сборников. Научный юмор приветствуется, но должен публиковаться большими порциями, а не набивать рейтинг единичными цитатами огромного сборника.
- Посты с вопросами околонаучного, но базового уровня, просьбы о помощи в решении задач и проведении исследований отправляются в общую ленту. По возможности модерация сообщества даст свой ответ.
Наказывается баном
- Оскорбления, выраженные лично пользователю или категории пользователей.
- Попытки использовать сообщество для рекламы.
- Фальсификация фактов.
- Многократные попытки публикации материалов, не удовлетворяющих правилам.
- Троллинг, флейм.
- Нарушение правил сайта в целом.
Окончательное решение по соответствию поста или комментария правилам принимается модерацией сообщества. Просьбы о разбане и жалобы на модерацию принимает администратор сообщества. Жалобы на администратора принимает и общество Пикабу.