
Вышла новая модель для генерации видео MiniMax H3
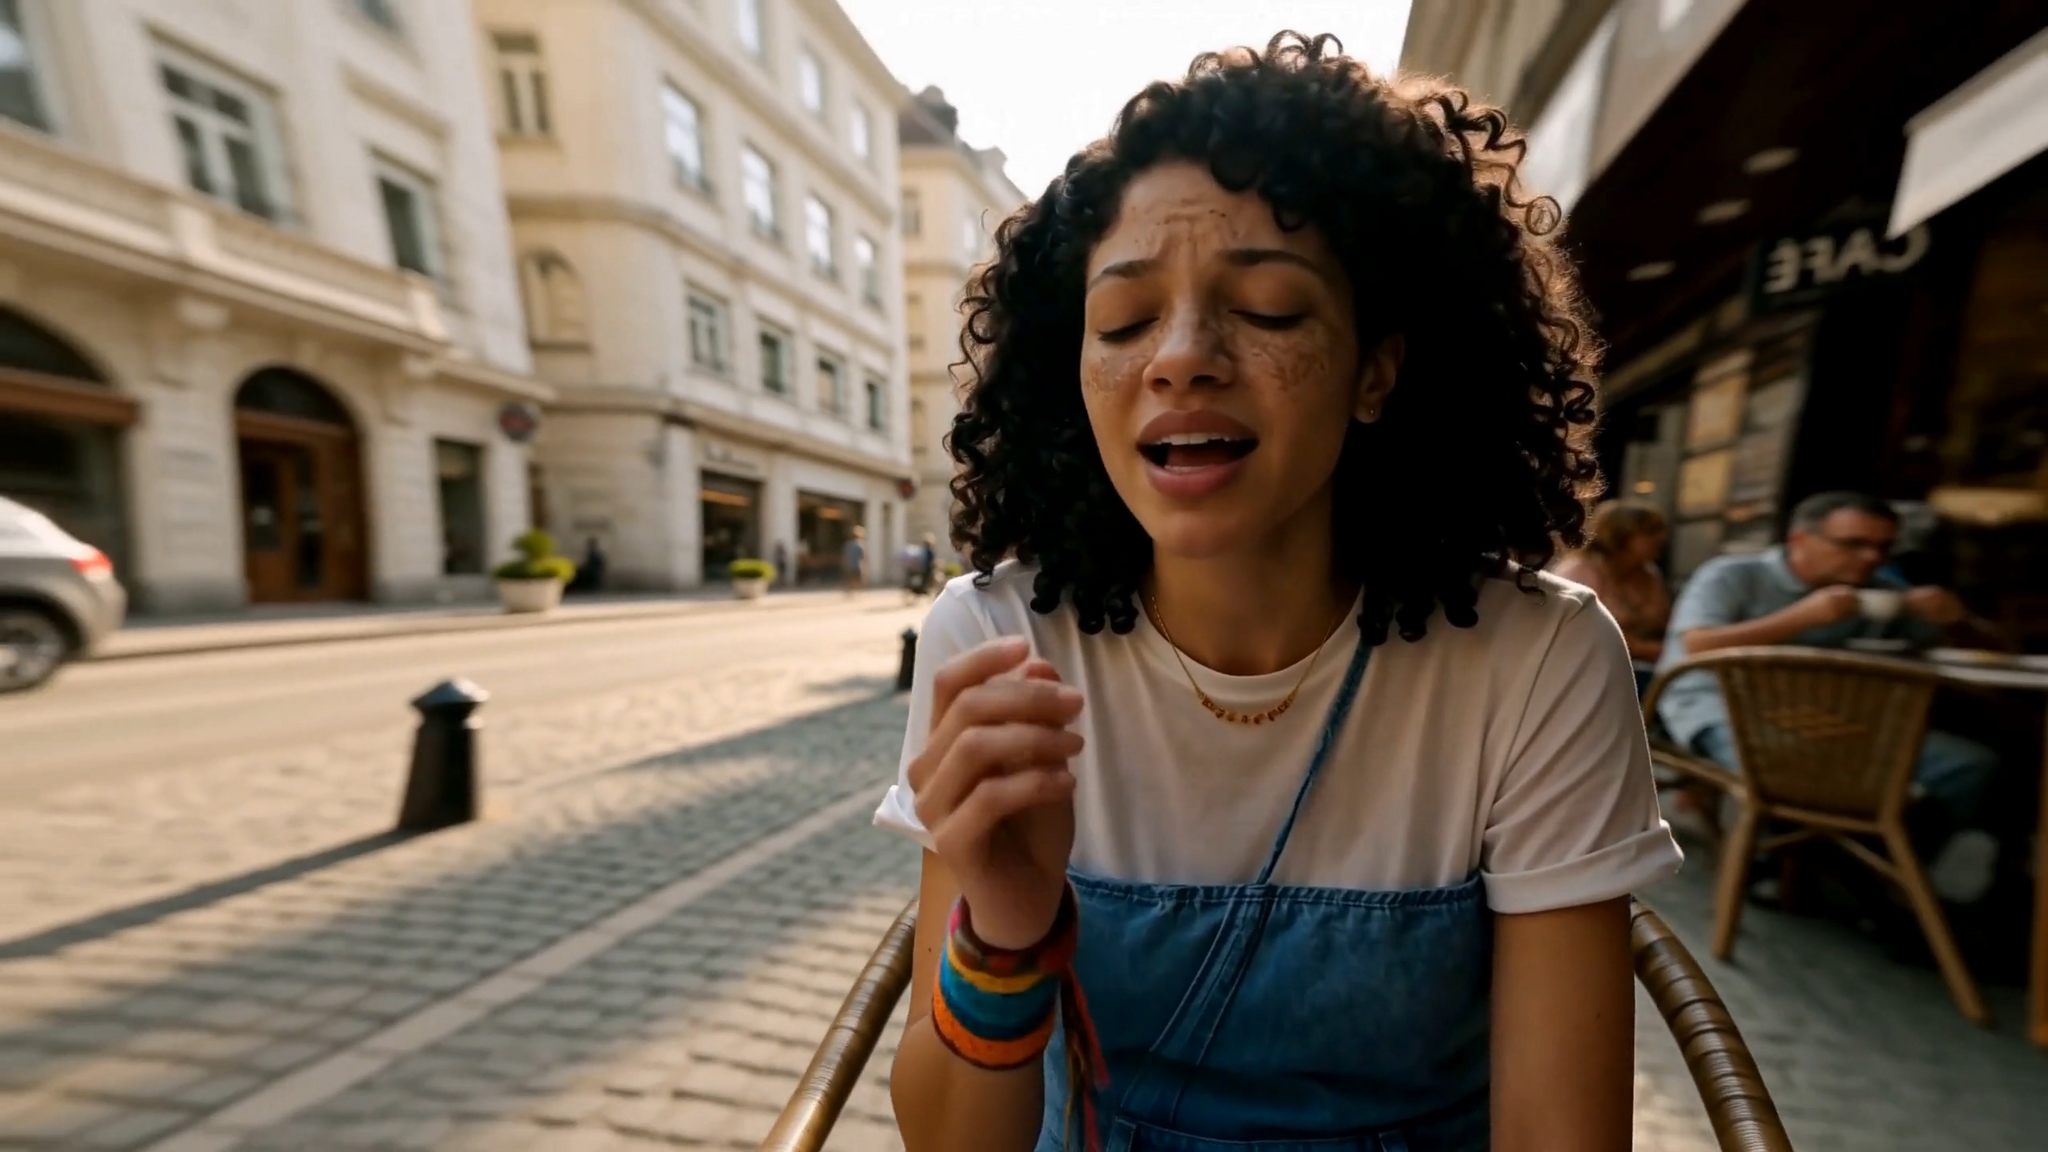
Подготовлена новая универсальная мультимодальная генеративная модель MiniMax H3 (https://huggingface.co/collections/MiniMaxAI/minimax-h3), понимающая единый контекст из текста, изображений, видео и аудио, также генерирующая видео до 15 с, 2K, 24 fps, с нативным стереозвуком, ориентированная на коммерческое создание контента (реклама, брендинг, e-commerce, игры, UI/UX и другие) под лицензией MiniMax H3 Community License.
Основные технологии объединяют контекстуальное омни-представление (Contextual Omni Representation), H3-VAE в виде пространственно-временного видеоавтоэнкодера и стереоаудио-VAE, плотную модель H3-Omni Transformer с 33B для единого потока совместного предсказания видео и аудио. Кроме того, используется In-Context Regeneration, регенерирующий от 768p до 2K в контексте исходных условий.
Следуя философии обобщающей задачи, применили единую модель вместо набора специализированных экспертов, описывая обобщённое редактирование и реферирование естественным языком.
Система состоит из трёх модулей, включая H3-Context-IR для препроцессинга мультимодальных инструкций (через API), H3-Base, генерирующий видео и аудио 768p (открытый чекпоинт FL2VA и Ref2VA), и H3-Regenerate-2K, повышающий качество до 2K через контекстную регенерацию (API).
В результате ценовая эффективность высокая, ведь стоимость за секунду 2K менее трети от цены мейнстримных моделей, а 768p обходится дешевле половины цены 720p.