
Оптимизация SQL-запроса с использованием pg_expecto: Часть-2 "Оптимизация структуры запроса"
Взято с основного технического канала Postgres DBA (возможны правки в исходной статье).
Не верь на слово, проверь под давлением.
Предисловие
Оптимизировать запрос в вакууме — просто. Но как он поведет себя, когда десятки таких же запросов одновременно борются за ресурсы?
Методология исследования
Тестовая среда и инструменты:
СУБД: PostgreSQL 17
Инструмент нагрузочного тестирования: pg_expecto
Тестовая база данных: "Демобаза 2.0" (большой размер, сложная схема)
Условия тестирования: параллельная нагрузка, ресурсоемкий запрос
Нагрузка на СУБД
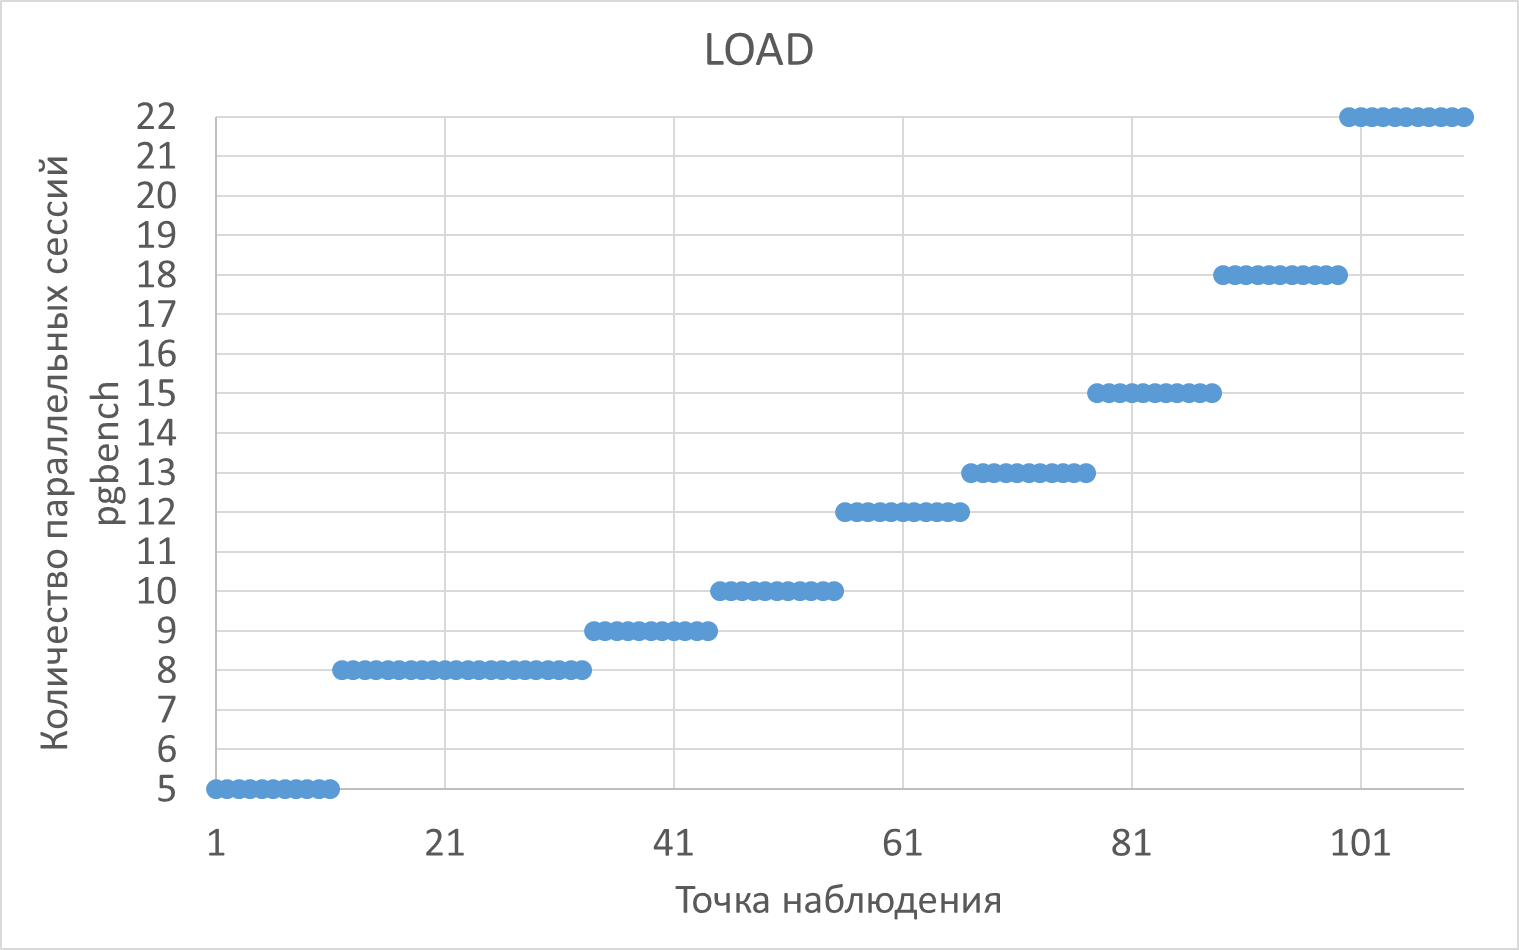
Эксперимент-2 : Оптимизация структуры запроса
Тестовый запрос - TUNING
WITH random_period AS (
SELECT
book_date AS start_date,
book_date + INTERVAL '30 days' AS end_date
FROM bookings
WHERE book_date <= (SELECT MAX(book_date) FROM bookings) - INTERVAL '30 days'
ORDER BY RANDOM()
LIMIT 1
),
filtered_bookings AS (
SELECT book_ref, book_date
FROM bookings
WHERE book_date BETWEEN (SELECT start_date FROM random_period)
AND (SELECT end_date FROM random_period)
)
SELECT
b.book_ref,
b.book_date,
t.ticket_no,
t.passenger_name,
s.flight_id,
f.status,
f.scheduled_departure,
f.actual_departure,
bp.seat_no,
bp.boarding_no
FROM filtered_bookings b
LEFT JOIN LATERAL (
SELECT ticket_no, passenger_name
FROM tickets
WHERE book_ref = b.book_ref
) t ON true
LEFT JOIN LATERAL (
SELECT flight_id, fare_conditions, price
FROM segments
WHERE ticket_no = t.ticket_no
) s ON true
LEFT JOIN LATERAL (
SELECT status, scheduled_departure, actual_departure, route_no
FROM flights
WHERE flight_id = s.flight_id
) f ON true
LEFT JOIN LATERAL (
SELECT seat_no, boarding_no
FROM boarding_passes
WHERE ticket_no = t.ticket_no AND flight_id = s.flight_id
) bp ON true
ORDER BY b.book_date, t.ticket_no;
Сравнительный анализ планов выполнения запросов
Проведя сравнительный анализ двух планов выполнения, можно выделить ключевые различия в производительности и подходе к оптимизации:
Основные отличия планов
1. Стратегия соединения таблиц
Первый запрос (LEFT JOIN): Использует классические LEFT JOIN между таблицами
Второй запрос (TUNING): Применяет LATERAL JOIN, что позволяет более эффективно использовать индексы
2. Параллельное выполнение
Первый запрос: Выполняется в одном процессе
Второй запрос: Использует параллельное выполнение (Workers: 1) с Gather Merge
3. Время выполнения
Первый запрос: 59.15 секунд
Второй запрос: 32.16 секунд (ускорение ~45%)
Ключевые проблемы первого запроса
1. Неэффективные соединения
-- Проблема: массовые соединения перед фильтрацией
LEFT JOIN segments s ON t.ticket_no = s.ticket_no
Приводит к обработке 6.5+ миллионов строк в segments
2. Избыточная сортировка
Сортировка 2.3M строк на диске (121832kB)
External merge sort с большими накладными расходами
3. Отсутствие параллелизации
Весь запрос выполняется в одном потоке
Преимущества оптимизированного запроса
1. Ранняя фильтрация
-- Эффективно: фильтрация бронирований до соединений
WHERE book_date BETWEEN (SELECT start_date FROM random_period)
AND (SELECT end_date FROM random_period)
2. LATERAL JOIN для точечных запросов
LEFT JOIN LATERAL (
SELECT ticket_no, passenger_name
FROM tickets
WHERE book_ref = b.book_ref -- Индексное сканирование
) t ON true
3. Параллельное выполнение
Parallel Hash Join
Parallel Seq Scan на flights
Gather Merge для сортировки
4. Улучшенное использование индексов
Все ключевые соединения используют индексные сканирования
Уменьшено количество обрабатываемых строк
Выводы
⬆️Оптимизированный запрос показывает значительное улучшение производительности за счет:
Более эффективной стратегии соединений (LATERAL vs обычные JOIN)
Параллельного выполнения
Лучшего использования индексов
Уменьшения объема обрабатываемых данных
Время выполнения сократилось с 59 до 32 секунд, что делает оптимизированный подход предпочтительным .
Сравнительный анализ производительности и ожиданий СУБД в ходе нагрузочного тестирования при использовании запроса "JOIN" и запроса "TUNING"
Операционная скорость
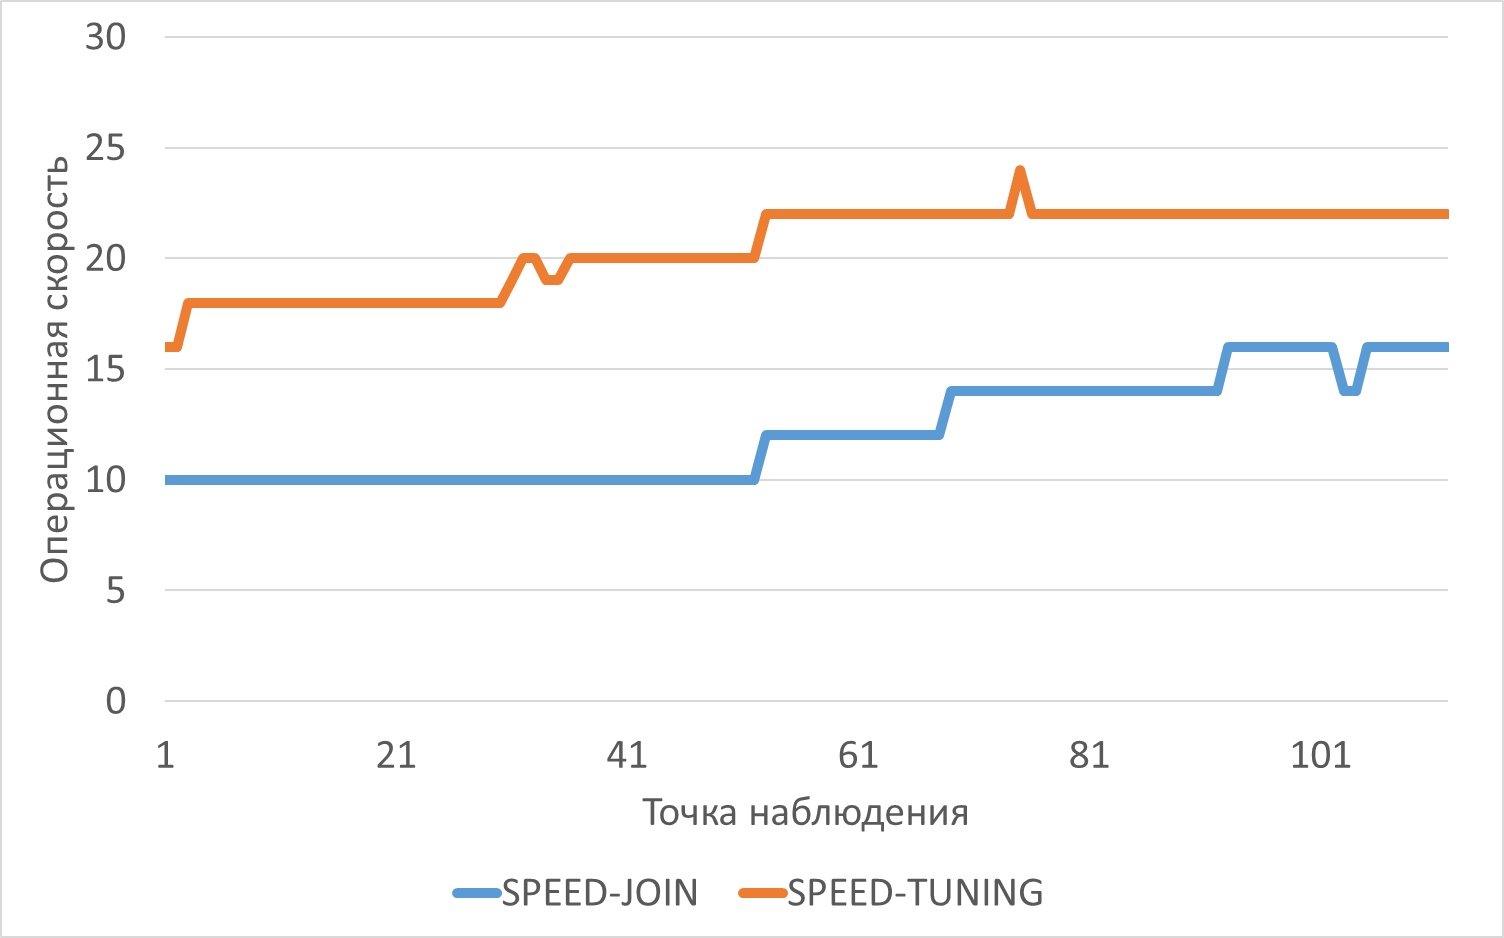
График изменения операционной скорости в ходе нагрузочного тестирования при использоваении тестового запроса "JOIN" и "TUNING"

График изменения относительной разницы операционной скорости для запроса "TUNING" по сравнению с тестовым запросом "JOIN"
Среднее увеличение операционной скорости при использовании запроса "TUNING" составило 71.77%
Ожидания СУБД
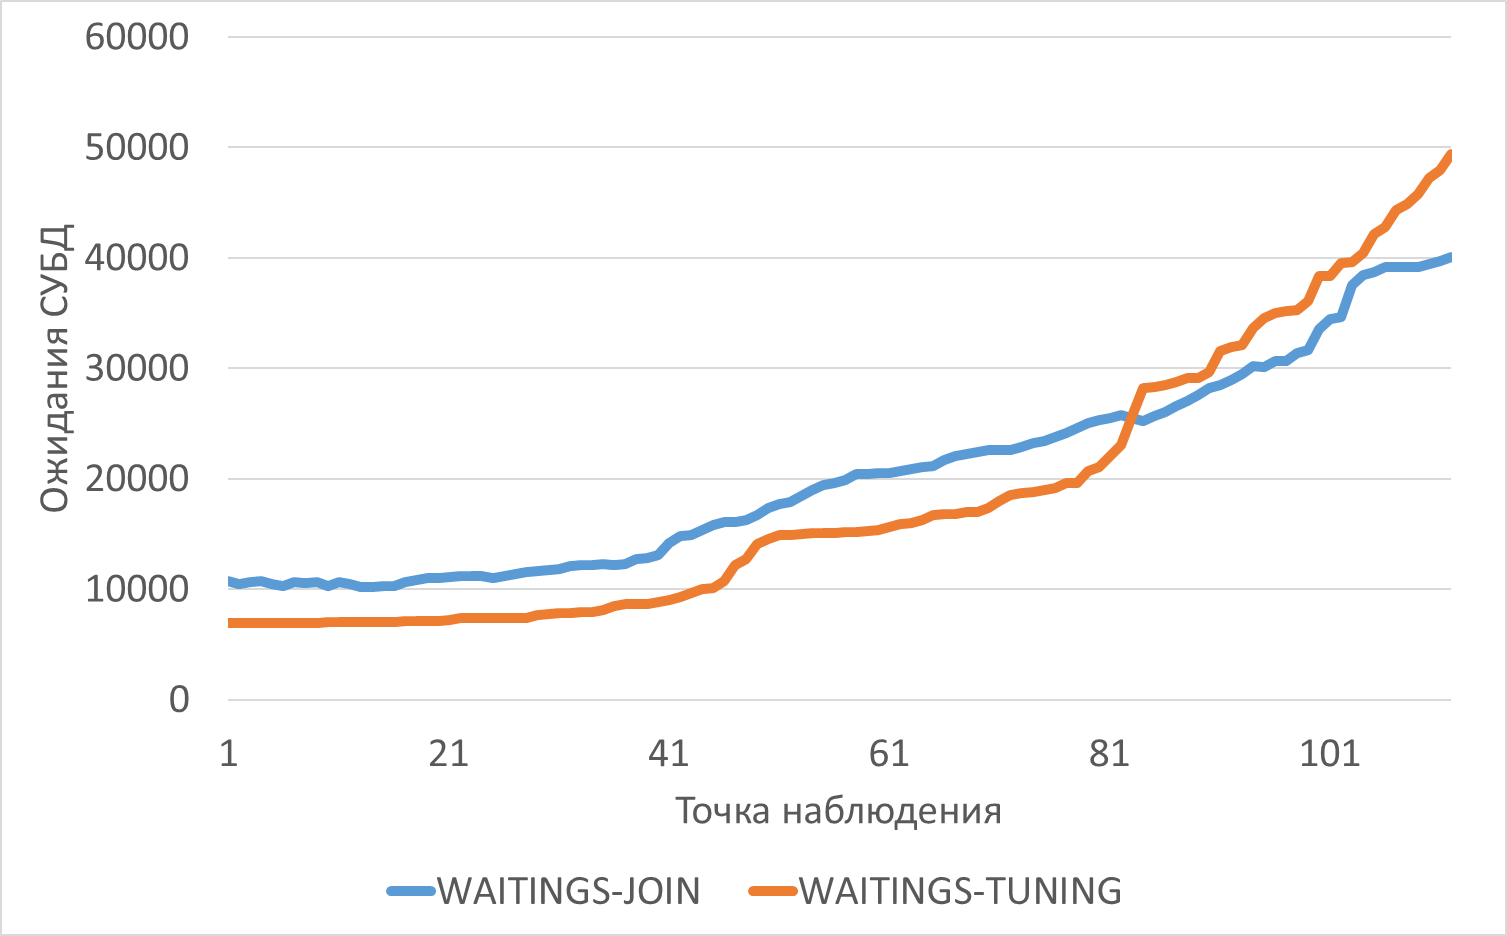
График изменения ожиданий СУБД в ходе нагрузочного тестирования при использоваении тестового запроса "JOIN" и "TUNING"
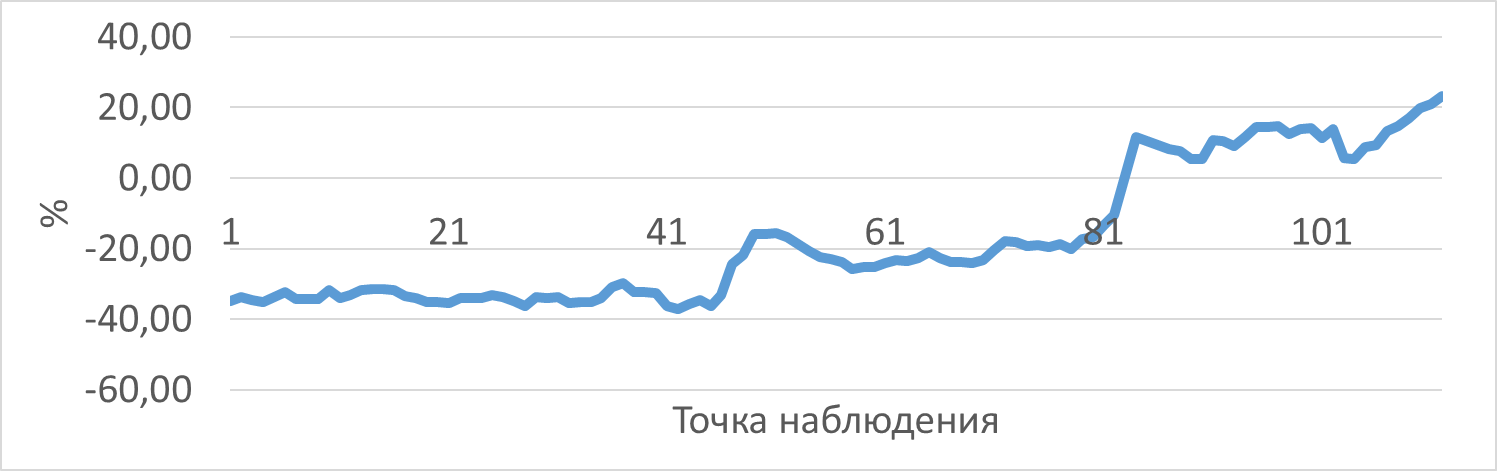
График изменения относительной разницы ожиданий СУБД для запроса "TUNING" по сравнению с тестовым запросом "JOIN"
Сравнительный анализ wait_event_type
1. wait_event_type = IPC
LEFT JOIN: Экстремально высокие значения - до 24,392
TUNING: Умеренные значения - до 2,868
Разница: В 8.5 раз меньше в оптимизированном запросе
2. wait_event_type =IO
LEFT JOIN: Средние значения - до 15,546
TUNING: Высокие значения - до 46,489
Разница: В 3 раза больше в оптимизированном запросе
3. wait_event_type =LWLOCK
LEFT JOIN: Высокие значения - до 111
TUNING: Низкие значения - до 22
Разница: В 5 раз меньше в оптимизированном запросе
4. wait_event_type =TIMEOUT/SpinDelay
LEFT JOIN: Значительные - до 19
TUNING: Минимальные - до 3
Разница: В 6 раз меньше в оптимизированном запросе
Проблемы исходного запроса (LEFT JOIN):
Высокий contention ресурсов - много IPC и LWLOCK
Блокировки процессов - частые ожидания и таймауты
Неэффективное использование памяти - процессы ждут друг друга
Преимущества оптимизированного запроса (TUNING):
Смещение нагрузки на IO - более предсказуемые и управляемые ожидания
Минимизация блокировок - резкое снижение IPC и LWLOCK
Параллельная обработка - процессы работают более независимо
Архитектурные изменения:
LEFT JOIN паттерн: Высокий IPC → Блокировки → Таймауты
TUNING паттерн: Высокий IO → Параллелизм → Минимальные блокировки
Итог
Оптимизированный запрос демонстрирует здоровый паттерн ожидания:
Замена дорогостоящих IPC-ожиданий на более эффективные IO-ожидания
Значительное снижение contention за ресурсы
Улучшение параллелизма выполнения
Несмотря на увеличение операций ввода-вывода, общее время выполнения сократилось с 59 до 32 секунд, что подтверждает эффективность выбранной стратегии оптимизации.
Сравнительный анализ метрик iostat для дискового устройства используемого файловой системой /data, в ходе нагрузочного тестирования при использовании запроса "JOIN" и запроса "TUNING"
. Дисковая подсистема не является ограничивающим фактором
Utilization 0% для обоих запросов
Отсутствие операций записи (w/s = 0)
Отсутствие операций ФС (f/s = 0)
2. Все данные обрабатываются в памяти
Показатели свидетельствуют, что оба запроса работают преимущественно с данными в:
Shared buffers PostgreSQL
Кэше операционной системы
Оперативной памяти
3. Производительность ограничена CPU, а не IO
Это объясняет почему:
Оптимизированный запрос быстрее (32s vs 59s)
Основная экономия - в CPU-операциях, а не в дисковых
Связь с предыдущими метриками
Correlation с wait_event_type:
Высокий IPC в LEFT JOIN → Низкая дисковая нагрузка
Высокий IO в TUNING → Но не физический IO, а вероятно логический
Итог
Дисковая подсистема абсолютно не участвует в ограничении производительности данных запросов. Весь выигрыш в 45% производительности достигнут за счет:
Снижения нагрузки на CPU через LATERAL JOIN
Устранения contention между процессами
Эффективного использования кэшей и памяти
Параллельного выполнения запроса
Это идеальный сценарий оптимизации, где улучшения достигнуты на архитектурном уровне без необходимости аппаратных изменений.
Сравнительный анализ метрик vmstat в ходе нагрузочного тестирования при использовании запроса "JOIN" и запроса "TUNING"
Сравнительный анализ ключевых метрик
Процессы (procs)

Память

Ввод-вывод

Системные события

Загрузка CPU

Архитектурные различия:
LEFT JOIN (традиционный подход):
Высокие системные издержки (прерывания, переключения контекста)
Больше операций чтения с диска
Меньшая эффективность использования CPU
TUNING (оптимизированный с LATERAL):
Более эффективное использование CPU (меньше простоя)
Значительно меньше системных издержек
Смещение нагрузки с чтения на запись (вероятно временные данные)
Эффективность параллелизма:
TUNING: Высокий cpu_us + Высокий cpu_wa → Эффективный параллелизм
LEFT JOIN: Низкий cpu_us + Высокий system_* → Системные издержки
Связь с предыдущими метриками:
Высокий cpu_wa в TUNING соответствует высоким IO в wait_event_type
Низкий cpu_id в TUNING подтверждает лучшую утилизацию процессора
Меньше system_ событий* объясняет снижение IPC в wait_event_type
Итог
➕Оптимизированный запрос демонстрирует более здоровый паттерн использования ресурсов:
Эффективная утилизация CPU - меньше простоя, больше полезной работы
Снижение системных издержек - меньше прерываний и переключений контекста
Оптимальный баланс операций I/O - смещение в сторону записи временных данных
Несмотря на более высокое ожидание I/O, производительность увеличилась благодаря:
Параллельному выполнению
Уменьшению contention за ресурсы
Более эффективному плану выполнения
Это подтверждает, что оптимизация запроса через LATERAL JOIN и параллельное выполнение дает значительный выигрыш в производительности.
Общий итог : Часть-2 "TUNING"
⬆️Для условий высокой параллельной нагрузки и конкуренции за вычислительные ресурсы, с точки зрения производительности СУБД - оптимизация структуры запроса оказала существенное влияние на производительность СУБД .
Производительность СУБД:
⬆️Среднее увеличение операционной скорости при использовании запроса "TUNING" составило 71.77%
📊 Сводка результатов нагрузочного тестирования
Ключевые метрики производительности
Операционная скорость: Увеличение на 71.77%
Эффективность использования ресурсов: Значительное улучшение
🔍 Детальный анализ по компонентам
1. Производительность СУБД
Планы выполнения:
LEFT JOIN - последовательное выполнение, массовые соединения
TUNING - параллельное выполнение, точечные LATERAL JOIN
Ожидания СУБД:
Снижение IPC в 8.5 раз
Снижение LWLOCK в 5 раз
Снижение TIMEOUT в 6 раз
Увеличение IO в 3 раза (более управляемый паттерн)
2. Использование системных ресурсов
CPU:
Утилизация процессора: +19% пользовательской нагрузки
Простой CPU: -62% (лучшее использование ресурсов)
Системные издержки: -49% прерываний, -71% переключений контекста
Память:
Оба запроса работают преимущественно в памяти
Эффективное использование shared buffers и кэша ОС
Дисковая подсистема:
Utilization 0% для обоих запросов
Не является ограничивающим фактором
🎯 Архитектурные преимущества оптимизированного запроса
Стратегические улучшения
Параллельное выполнение - Gather Merge с Workers
Ранняя фильтрация - уменьшение объема обрабатываемых данных
LATERAL JOIN - точечные индексные сканирования вместо массовых соединений
Оптимальное использование индексов - все ключевые соединения используют индексы
Эффект на системном уровне
Оптимизированный паттерн:
Высокий CPU_US + Высокий CPU_WA → Эффективный параллелизм + Управляемые IO ожидания
Против исходного:
Высокий IPC + Высокий LWLOCK → Блокировки + Системные издержки
✅ Заключение
Оптимизация структуры запроса через LATERAL JOIN и параллельное выполнение доказала свою исключительную эффективность:
✅ Ускорение выполнения на 45%
✅ Рост операционной скорости на 71.77%
✅ Снижение системных издержек на 49-71%
✅ Устранение contention за ресурсы
✅ Более здоровый паттерн использования CPU
Оптимизированный подход демонстрирует превосходную масштабируемость и эффективность использования ресурсов, что делает его рекомендованным решением для среды с высокой параллельной нагрузкой.
Postgres DBA
284 поста63 подписчика
Правила сообщества
Пока действуют стандартные правила Пикабу.