
Нейросеть рисует и пишет
38 постов
38 постов
16 постов
118 постов
40 постов
287 постов
114 постов
22 поста
Оригинал — на основном техническом канале (Возможны правки и дополнения).
Синоптик для базы данных: как модель переходов между состояниями предсказывает «погоду» в PostgreSQL
Облака сгущаются? Проверь базу, пока не поздно.
Представим что база данных PostgreSQL — это большой город. Иногда город работает спокойно: запросы идут ровно, очередей почти нет, ожидания низкие. Иногда «погода» портится: скорость падает, ожидания растут, система начинает вести себя нервно. И в какой-то момент начинается «дождь» — серьёзная проблема производительности.
Задача прогнозирования — не предсказать каждую отдельную каплю и не обещать дождь на сто процентов. Задача скромнее и полезнее: вовремя заметить облака и сказать: «вероятность дождя выросла, стоит приготовиться».
В основе системы лежит вероятностная модель, которую для простоты можно назвать «моделью переходов». Она каждую минуту смотрит на несколько признаков «погоды» в базе данных: насколько согласованно меняются скорость и ожидания, растёт ли нагрузка, падает ли скорость. Из этих признаков складывается текущее «состояние погоды». Состояний много, но они не бесконечны — как не бесконечны сочетания температуры, ветра и влажности.
Модель запоминает, какие состояния часто сменяют друг друга, а после каких чаще наступает что-то тревожное. Это похоже на опытного синоптика: он не знает будущее, но помнит, что после определённого сочетания облаков и ветра дождь случается чаще. Важная деталь: модель не помнит всё навсегда. Старые наблюдения постепенно «выветриваются», как старые прогнозы погоды, которые уже не помогают сегодня. Есть и особые, «аварийные» состояния: если система в них попала, риск считается реализованным. Прогноз на несколько минут вперёд — это, по сути, вопрос: «какова вероятность хотя бы раз попасть в тревожное состояние в ближайшее время?»
Но самое интересное начинается не с самой модели, а с сигналов-флажков. Для простоты назовём их двумя облаками на небе.
Первое облако — «быстрое». Оно появляется чаще, реагирует оперативнее, но иногда оказывается пустым: облако есть, а дождя нет.
Второе облако — «фоновое». Оно может висеть над горизонтом долго, покрывает более широкую зону, но иногда висит почти целый день без всякого дождя.
Здесь и работает главная метафора: если идёт дождь, то на небе почти всегда есть облако; но если на небе облако, это не значит, что пойдёт дождь. Иными словами, сигналы чувствительны — они часто появляются перед проблемой, — но не всегда точны: часть срабатываний остаётся без последующей проблемы.
По данным наблюдений это видно довольно наглядно. «Быстрое» облако срабатывало чаще и в среднем в четырёх случаях из десяти действительно предвещало проблему. Причём эта доля почти не менялась от месяца к неделе: облако ведёт себя предсказуемо. «Фоновое» облако давало более широкий охват: оно «накрывало» больше проблемных случаев — примерно восемь из десяти. Но его поведение менее стабильно: в одном периоде полезных срабатываний было около трети, в другом — больше половины. И висело оно иногда очень долго: самый длинный период активности продолжался почти восемнадцать часов и повторялся в разных срезах наблюдений.
«Быстрое» облако, наоборот, обычно давало компактные предупреждения: в недельном срезе средняя длительность полезного сигнала была около двух часов, а максимальная — примерно пять часов. «Фоновое» облако в том же срезе было длиннее: в среднем около четырёх часов, а максимум всё тот же — почти восемнадцать часов. Поэтому «быстрое» облако удобнее держать на оперативном экране: оно не висит слишком долго и даёт понятное подтверждение. «Фоновое» облако полезно как широкий ранний фон, но его длительность нужно ограничивать, иначе оно превращается в «облако, которое висит неделю».
В коротком дневном наблюдении картина повторилась. «Быстрое» облако сработало девять раз, и в четырёх случаях после него действительно началась проблема. «Фоновое» — четыре раза, и в двух случаях была проблема. «Быстрое» поймало больше проблем, но и больше пустых облаков. «Фоновое» реже ошивалось, но и реже срабатывало: оно пропустило два случая, которые «быстрое» облако заметило. Среднее время упреждения у обоих — около часа. Это важная цифра: у оператора обычно есть примерно час, а иногда всего десять минут, чтобы подготовиться.
Потому что сигнал — это не сама проблема, а повышение вероятности. Модель оценивает риск, но риск — не приговор.
В крайних зонах она довольно уверенно говорит «очень тихо» или «очень тревожно». А вот в середине шкалы её оценка «может быть» требует осторожности: средние вероятности менее надёжны, чем крайние. Поэтому нельзя воспринимать каждое облако как гарантию дождя и нельзя считать, что одно универсальное правило «сработает всегда».
Есть и другая тонкость. Часть пропущенных проблем возникала не потому, что сигнал опоздал, а потому, что риск перед проблемой не рос, а стоял на месте. Это как если бы облака не сгущались, а просто висели ровно — и внезапно пошёл дождь. Кроме того, иногда важно смотреть не на сам момент начала проблемы, а на последнюю «чистую» минуту до неё: если смотреть уже под дождём, можно не увидеть, было ли облако раньше. Это методологическая, но вполне житейская тонкость.
Вывод простой: не нужно выбирать между «шумным, но чувствительным» и «точным, но редким» сигналом. Нужна комбинированная схема.
«Быстрое» облако разумно использовать как основной оперативный сигнал: у него стабильная доля полезных срабатываний — около четырёх из десяти — и компактные предупреждения.
«Фоновое» облако — как широкий ранний фон: оно покрывает больше проблем и даёт длинный запас времени, но требует ограничения длительности и регулярной проверки: если доля полезных срабатываний падает ниже примерно четырёх-пяти из десяти, его операционная ценность снижается.
Можно представить это как два уровня оповещения.
«Быстрое» облако — жёлтый уровень: «посмотрите на небо, будьте внимательны».
«Фоновое» — оранжевый: «вероятность высокая, готовьте защитные механизмы».
Вместе они дают не хрустальный шар, а надёжного синоптика, который вовремя говорит: «облака сгущаются — проверьте систему», и при этом не обещает ливень там, где его может и не быть.
В итоге вероятностная модель для базы данных — это не оракул и не гениальный предсказатель. Это метеостанция, которая каждую минуту описывает «погоду», учится на последовательностях состояний, постепенно забывает старое и выдаёт вероятностный прогноз.
Сигналы-флажки — это облака. Дождь почти всегда приходит под облаком, но облако не гарантирует дождь.
Поэтому лучшая система — не один флажок, а сочетание широкого фона и быстрого подтверждения, с честной оценкой вероятностей и регулярным наблюдением за тем, насколько облака действительно предвещают дождь.
Оригинал — на основном техническом канале (Возможны правки и дополнения).
В статье рассматривается подход к анализу и прогнозированию производительности СУБД PostgreSQL на основе цепей Маркова. Представлена архитектура системы, включающая динамическое определение состояний, механизмы адаптивного забывания и многоуровневую систему сигналов предупреждения. На основе экспериментальных данных (ROC-AUC = 0.9287, Brier score = 0.0638, покрытие инцидентов SICPP = 97.4%) демонстрируется эффективность подхода. Рассматриваются практические сценарии применения: прогнозирование инцидентов, диагностика деградации, оптимизация эталонных профилей и оперативное оповещение. Обсуждаются ограничения и направления дальнейшего развития.
Ключевые слова: цепь Маркова, PostgreSQL, прогнозирование производительности, SICPP, операционный индикатор, адаптивное забывание, профилирование нагрузки
Эмпирический риск и марковские состояния: от диагностики к прогнозу
Современные СУБД функционируют в условиях высокой динамики нагрузки, что требует эффективных методов раннего обнаружения деградации производительности. Традиционные подходы, основанные на статических порогах, не учитывают временную динамику и контекст. В данной работе рассматривается применение цепей Маркова для моделирования состояний СУБД и прогнозирования риска возникновения инцидентов.
Предлагаемая система реализует следующие ключевые идеи:
Дискретизация пространства состояний на основе корреляции и трендов ключевых метрик
Адаптивное забывание с учётом времени с последнего инцидента
Многоуровневая система сигналов (SICPP, C-alone)
Динамическое определение критических состояний на основе эмпирического риска
Система включает следующие модули:
mchain_train_step() — ежеминутное обучение и обновление состояния.
sicpp_calculate_at() — расчёт сигнала SICPP на заданный момент.
mchain_hybrid_alert_at() — операционный индикатор C-alone.
compare_profiles_at() — сравнение текущего профиля с эталоном.
refresh_critical_states() — динамическое обновление критических состояний.
Система реализует трёхуровневую сигнализацию:
SICPP (Signal Indicating a Change in the Performance Profile) — контекстный индикатор режима, триггерит WARNING.
C-alone — операционный индикатор на основе risk_p90 >= 0.98 AND js_avg >= 0.14, триггерит ALARM.
Integral status (get_current_preincident_status()) — агрегирует все сигналы.
На основе данных за период 2026-10-12 – 2026-10-26 (38 инцидентов) получены следующие метрики:
ROC-AUC: 0.9287 — отличная дискриминация.
Brier score: 0.0638 — хорошая калибровка.
Покрытие SICPP: 97.4% — почти все инциденты покрыты.
Precision эпизодов: 53.2% — умеренная точность.
C-alone precision: 34.5% — приемлемая точность.
C-alone recall: 51.4% — умеренная полнота.
Бин вероятности [0.1–0.2]: предсказано 0.124, фактически 0.134, n = 10008.
Бин вероятности [0.8–0.9]: предсказано 0.816, фактически 0.796, n = 588.
Бин вероятности [0.9–1.0]: предсказано 1.000, фактически 0.998, n = 9392.
Калибровка близка к идеальной, особенно в диапазоне высоких вероятностей.
p50, мин: ALL (raw) = 143.0; SHORT (≤800 мин) = 96.5.
p90, мин: ALL (raw) = 987.8; SHORT (≤800 мин) = 281.5.
mean, мин: ALL (raw) = 357.0; SHORT (≤800 мин) = 156.6.
max, мин: ALL (raw) = 1115.0; SHORT (≤800 мин) = 777.0.
Метрики SHORT отражают «типичное» предаварийное состояние без искажения длинными эпизодами.
Задача: Заблаговременно предупредить о риске возникновения инцидента.
Решение: Использование mchain_predict_risk_current_horizon() с горизонтом 120 минут.
Пример:
SELECT mchain_predict_risk_current_horizon();
-- Результат: 0.87 (высокий риск)
Интерпретация: При риске ≥ 0.90 рекомендуется активировать режим повышенного мониторинга; при риске ≥ 0.95 — рассмотреть превентивные меры.
Задача: Обнаружить отклонение текущего режима работы от эталонного.
Решение: Использование compare_profiles_at() с JS-дивергенцией гистограмм состояний.
Пример:
SELECT unnest(compare_profiles_at(now()));
-- Результат: JS-дивергенция = 0.23, статус = CRITICAL
Интерпретация:
JS < 0.05 — профиль соответствует эталону.
0.05 ≤ JS < 0.2 — умеренные отклонения (WARNING).
JS ≥ 0.2 — значительные отклонения (CRITICAL).
Задача: Минимизировать ложные срабатывания при сохранении приемлемого recall.
Решение: Использование mchain_hybrid_alert_at() с параметрами C-only.
Пример:
SELECT alert, fired_c, risk_p90, js_avg
FROM mchain_hybrid_alert_at(now());
-- Результат: alert=true, fired_c=true, risk_p90=0.99, js_avg=0.18
Преимущества C-alone:
Precision 34.5% vs 12.5% для A∪C.
Recall 51.4% — приемлемый уровень.
ALERT-time 14.1% — низкая нагрузка на оператора.
Задача: Автоматически выбирать репрезентативные периоды для эталона.
Решение: Использование find_incident_free_window() с проверкой is_valid_baseline_window().
Критерии валидности эталонного окна:
Целиком в периоде продуктивной нагрузки (9:00–18:00).
Начинается не ранее чем через 60 мин после завершения инцидента.
Не пересекается с инцидентами.
Возраст не превышает 12 часов.
Задача: Адаптировать список «аварийных» состояний к текущим условиям.
Решение: Использование refresh_critical_states() с эмпирической оценкой риска.
Пример:
SELECT refresh_critical_states(
p_start := now() - interval '14 days',
p_risk_threshold := 0.10,
p_min_transitions := 20
);
-- Результат: добавлено 3, удалено 1 состояние
Важно: Порог p_risk_threshold > 0.10 запрещён (тест 24 показал деградацию метрик).
Представлена система анализа и прогнозирования производительности PostgreSQL на основе цепей Маркова.
Экспериментальные результаты демонстрируют высокое качество прогнозирования (ROC-AUC = 0.9287, Brier = 0.0638) и практическую применимость для раннего обнаружения инцидентов.
Рассмотренные сценарии применения охватывают прогнозирование, диагностику, оперативное оповещение и оптимизацию эталонов.
Дальнейшее развитие связано с расширением пространства состояний и интеграцией с современными системами мониторинга.
Оригинал — на основном техническом канале (Возможны правки и дополнения).
Практическое руководство по развёртыванию тестового стенда PG_EXPECTO + Markov Chain: настройка нагрузочного тестирования через param.conf, автоматический запуск test.sh по cron с пуассоновским распределением нагрузки и целевым количеством инцидентов в сутки.
PG_EXPECTO: от теста до аналитики производительности.
cd /postgres/pg_expecto/sh/load_test
vi param.conf
# НАСТРОЙКИ НАГРУЗОЧНОГО ТЕСТИРОВАНИЯ
# Начальная нагрузка
start_load = 5
# Максимальная нагрузка
finish_load = 40
# Тестовая БД
testdb = default
# Тип синтетической нагрузки
#load_mode = olap
load_mode = oltp
# БЕСКОНЕЧНЫЙ ТЕСТ.
# ДЛЯ ОСТАНОВКИ
# /postgres/pg_expecto/sh/load_test/load_test_stop.sh
period_hours = -1
average_load = 20
# Веса сценариев по умолчанию
scenario1 = 0.7
scenario2 = 0.2
scenario3 = 0.1
# Инициализировать тестовую БД
init_test_db = on
# Размер тестовой БД
#scale = 20
#~10GB
scale = 685
Скрипт предназначен для автоматического управления нагрузочным тестированием.
Он проверяет количество инцидентов в БД за текущие сутки и в зависимости от целевого значения запускает или останавливает нагрузочный тест.
Для запуска процесса нагрузочного тестирования с Пуассоновским распределением нагрузки и заданным количеством инцидентов в сутки(в примере = 4) - добавить в расписание cron:
0 * * * * /postgres/pg_expecto/sh/load_test/test.sh 4 >> /postgres/pg_expecto/sh/load_test/test.log 2>&1
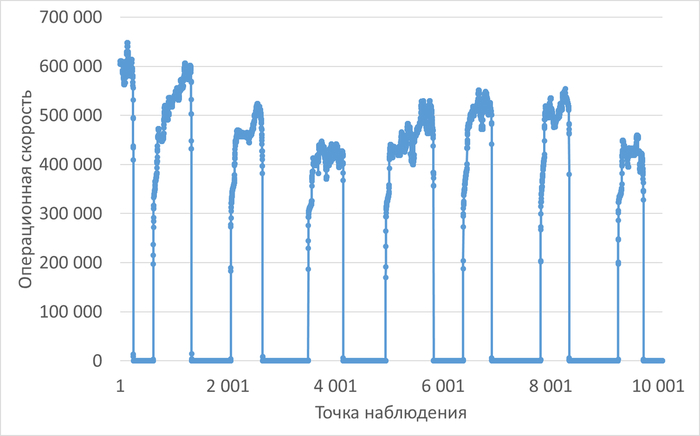
График изменения операционной скорости СУБД в течении недели в ходе нагрузочного тестирования

График изменения ожиданий СУБД в течении недели в ходе нагрузочного тестирования
2: **
3: **
4: ****
5: ***
6: **
7: *
8: ****
9: **
11: *
14: *
17: **
День 0: ******
День 1: ***
День 2: ***
День 3: **
День 4: ****
День 5: ***
День 6: ***
Оригинал — на основном техническом канале (Возможны правки и дополнения).
Разработка и оценка гибридной методологии раннего предупреждения на основе марковских переходов, JS-дивергенции профилей нагрузки и взвешенного сигнала SICPP: месячное пилотное исследование с ROC-AUC 0,9593 и покрытием 96,4 % несерийных инцидентов
Интегральный сигнал SICPP как инструмент упреждающего анализа рисков СУБД.
Рассматривается практическое применение марковской модели переходов между состояниями производительности СУБД для прогнозирования инцидентов и раннего предупреждения деградации. Архитектура решения включает профилирование нагрузки, сравнение гистограмм состояний на основе JS-дивергенции, динамический список критических состояний, прогноз риска на заданный горизонт и интегральный сигнал SICPP. По результатам отчётного периода с 16 сентября по 16 октября 2026 г. получены 28 несерийных инцидентов, из которых для 27 (96,4 %) был зафиксирован активный сигнал. ROC-AUC составил 0,9593, Brier score — 0,056062. Показано, что совместное использование JS-дивергенции и предсказанного риска в режиме WEIGHTED обеспечивает высокую полноту обнаружения при умеренной частоте ложных срабатываний. Обсуждаются ограничения, связанные с latch-эффектом SICPP, калибровкой в средних диапазонах риска и малой выборкой.
Ключевые слова: СУБД, цепь Маркова, прогнозирование инцидентов, JS-дивергенция, SICPP, профилирование производительности, ROC-AUC, Brier score, критические состояния.
Прогнозирование инцидентов производительности в СУБД остаётся сложной задачей из-за нестационарности нагрузки, сезонности, внутренних блокировок и стохастического характера отказов.
Традиционные пороговые системы реагируют на уже наступившую деградацию, тогда как практическая ценность раннего предупреждения состоит в возможности упреждающего вмешательства.
В данной работе исследуется гибридная схема, объединяющая:
марковскую цепь переходов между дискретными состояниями производительности;
профилирование нагрузки и сравнение эталонного и текущего профилей;
JS-дивергенцию гистограмм состояний;
динамический список критических состояний;
интегральный сигнал SICPP, учитывающий как риск, так и расхождение профилей.
Цель исследования — оценить, насколько такая схема способна заблаговременно обнаруживать инциденты производительности СУБД и насколько устойчивы её метрики качества на реальном отчётном периоде.
В основе решения лежат несколько взаимосвязанных подсистем.
Журнал переходов. Таблица transition_log хранит последовательность переходов между состояниями с временными метками.
Частоты и вероятности. Таблицы markov_frequencies и markov_probabilities содержат накопленные частоты и условные вероятности переходов.
Поглощающая матрица. Таблица markov_absorbing используется для многошагового прогноза риска, при этом критические состояния рассматриваются как поглощающие.
Справочник состояний. Таблица state_descriptions содержит 189 состояний, образованных комбинацией округлённой корреляции, тренда операционной скорости и тренда ожиданий.
Критические состояния. Таблица critical_states формируется динамически на основе эмпирической частоты инцидентов после перехода в состояние.
Журнал прогнозов. Таблица prediction_log хранит предсказанный риск, состояние на момент прогноза и фактический исход.
Профили нагрузки. Таблицы profile_aggregated, profile_comparison_log, pre_incident_profiles обеспечивают сравнение текущего и эталонного профилей.
История SICPP. Таблицы sicpp_history и sicpp_current_state фиксируют изменения интегрального сигнала.
Профиль нагрузки описывается гистограммой состояний, а также рядом метрик: средней корреляцией, долей критических состояний, энтропией, долей петель, средними углами трендов и др. Для снижения разреженности гистограмм применяется сглаживание Лапласа с параметром α = 0,5 по всем 189 состояниям. Это позволяет получать содержательные значения JS-дивергенции в диапазоне 0,05–0,30 вместо вырожденных значений, близких к теоретическому максимуму.
Сравнение профилей выполняется между текущим окном и эталонным окном, свободным от инцидентов. Если JS-дивергенция превышает порог, статус сравнения повышается до WARNING или CRITICAL. Дополнительно учитываются максимальный предсказанный риск и устойчивость: например, если 3 из 5 последних сравнений имели статус CRITICAL или WARNING, формируется расширенный прединцидентный флаг.
Состояние системы кодируется числом от 0 до 188. Прогноз риска вычисляется как вероятность хотя бы одного попадания в множество критических состояний за заданное число шагов. Для этого используется матрица переходных вероятностей и поглощающая матрица.
Ключевые особенности реализации:
горизонт прогноза задаётся в markov_config.forecast_horizon_minutes;
критические состояния определяются не только экспертно, но и по эмпирическому риску;
адаптивное забывание уменьшает старые частоты с коэффициентом, зависящим от времени с последнего инцидента;
для устойчивости вычислений используется тип DOUBLE PRECISION, поскольку ранее применение REAL приводило к антипереполнению при малых вероятностях и искажению метрик.
SICPP (Signal Indicating a Change in the Performance Profile) объединяет две компоненты:
нормированную JS-дивергенцию;
нормированный предсказанный риск.
В режиме WEIGHTED сила сигнала рассчитывается как
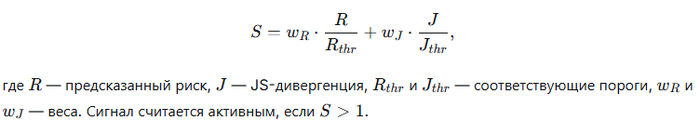
В версии SICPP 1.1.0 изменена семантика signal_active: сигнал считается активным, если в окне [pts−window,pts−1][pts−window,pts−1] присутствовал хотя бы один непрерывный пробег длительностью не менее min_signal_duration. Это соответствует логике функции calculate_signal и приводит к latch-эффекту: сигнал остаётся активным в течение окна после завершения подходящего пробега.
Качество прогнозирования оценивается по нескольким направлениям:
ROC-AUC — дискриминационная способность модели по prediction_log.actual_outcome;
Brier score — среднеквадратичная ошибка вероятностного прогноза;
калибровочная кривая — сопоставление предсказанного риска и фактической частоты инцидентов;
покрытие инцидентов сигналом — доля несерийных инцидентов, перед которыми SICPP был активен;
среднее время от сигнала до инцидента — оценка запаса времени для упреждающих действий.
Отчёт сформирован за период с 16 сентября 2026 г. 13:53 по 16 октября 2026 г. 13:53. Источник сигнала — sicpp_history. В периоде зафиксирована 81 запись, первая — 4 октября 2026 г. 13:33.
Параметры конфигурации:
окно анализа — 60 минут;
порог JS-дивергенции — 0,15;
порог риска — 0,85;
режим сигнала — WEIGHTED;
минимальная длительность сигнала — 3 минуты;
вес JS — 0,7;
вес риска — 0,3;
автоподбор порогов — выключен;
период калибровки — 7 дней;
расширенный отчёт — включён.
Всего в отчёте учтено 28 инцидентов, не являющихся продолжением серий. Исключено 11 серийных инцидентов, у которых последний статус перед инцидентом был INCIDENT.
Основные результаты:
с сигналом SICPP — 27 инцидентов;
доля инцидентов с сигналом — 96,4 %;
без сигнала — 1 инцидент (ID 88);
среднее время от сигнала до инцидента — 382,8 минуты;
средняя JS-дивергенция — 0,1180;
средний риск — 0,7621.
Распределение последних статусов перед инцидентами:
CRITICAL — 18;
WARNING — 8;
NORMAL — 0;
INCIDENT — 0;
нет данных — 0.
Таким образом, в подавляющем большинстве случаев инциденту предшествовало либо критическое, либо предупреждающее состояние профиля.
Качество прогнозирования на основе prediction_log.actual_outcome характеризуется следующими значениями:
ROC-AUC — 0,9593;
Brier score — 0,056062.
Столь высокое значение ROC-AUC указывает на хорошую дискриминационную способность модели: она уверенно разделяет прогнозы с последующим инцидентом и без него.
Низкий Brier score свидетельствует о том, что вероятностные оценки в целом близки к фактическим исходам.
Калибровочная кривая показывает соответствие между предсказанным риском и фактической частотой инцидентов.
Диапазон [0,0–0,1]: предсказано 0,000, фактически 1,000, n = 7.
Диапазон [0,1–0,2]: предсказано 0,177, фактически 0,161, n = 1642.
Диапазон [0,2–0,3]: предсказано 0,256, фактически 0,184, n = 3616.
Диапазон [0,5–0,6]: предсказано 0,575, фактически 1,000, n = 117.
Диапазон [0,6–0,7]: предсказано 0,681, фактически 1,000, n = 516.
Диапазон [0,7–0,8]: предсказано 0,782, фактически 1,000, n = 418.
Диапазон [0,8–0,9]: предсказано 0,874, фактически 1,000, n = 414.
Диапазон [0,9–1,0]: предсказано 0,981, фактически 0,984, n = 3833.
Диапазон [1,0–1,1]: предсказано 1,000, фактически 0,998, n = 6699.
Наиболее надёжными выглядят диапазоны высокого риска: при предсказании около 0,98–1,00 фактическая частота близка к 0,98–1,00. В то же время в средних диапазонах 0,5–0,9 наблюдается смещение: фактическая частота оказывается выше предсказанной. Это может быть связано как с малой выборкой в отдельных бинах, так и с переоценкой модели в переходных режимах.
Распределение инцидентов по часам суток показывает выраженную неравномерность.
Наибольшая концентрация наблюдается в 4 часа (5 инцидентов).
Далее следуют 3, 5, 8, 9 и 17 часов (по 3–4 инцидента).
Единичные инциденты зафиксированы в 2, 6, 7, 10, 11, 14 и 15 часов.
В остальные часы инцидентов в отчётном периоде не было.
Распределение по дням недели:
воскресенье — 6 инцидентов;
пятница — 6 инцидентов;
понедельник — 3;
вторник — 3;
среда — 2;
четверг — 4;
суббота — 4.
В отчёте приведены детали по каждому инциденту. Наиболее показательные случаи:
ID 70: сигнал активен, время до инцидента — 888 минут, длительность сигнала — 3 минуты, средний риск — 0,8440, JS — 0,0530.
ID 77: сигнал активен, время до инцидента — 133 минуты, длительность сигнала — 60 минут, средний риск — 0,9989, JS — 0,1983.
ID 92: сигнал активен, время до инцидента — 959 минут, длительность сигнала — 37 минут, приоритет — 3, средний риск — 0,7055.
ID 94: сигнал активен, время до инцидента — 8 минут, длительность сигнала — 3 минуты, средний риск — 0,9666, JS — 0,1488.
ID 97: сигнал активен, время до инцидента — 1041 минута, длительность сигнала — 60 минут, средний риск — 0,2298, JS — 0,2280.
ID 88: сигнал отсутствовал, последний статус — WARNING, тренд — РОСТ, риск — 0,8373, JS — 0,1405.
Эти примеры показывают, что сигнал может возникать как за несколько минут, так и за несколько часов до инцидента. В части случаев срабатывание происходило преимущественно за счёт JS-дивергенции, даже если средний риск был ниже порога 0,85. Это подтверждает полезность взвешенного режима.
Полученные результаты позволяют сделать несколько содержательных выводов.
Высокая полнота обнаружения. Сигнал SICPP был активен перед 27 из 28 несерийных инцидентов. Это свидетельствует о том, что совместное использование профильного расхождения и марковского риска позволяет покрывать практически все значимые события.
Хорошее качество вероятностного прогноза. ROC-AUC 0,9593 и Brier score 0,056062 находятся на уровне, характерном для хорошо настроенных моделей раннего предупреждения. Особенно важно, что низкий Brier score достигается при наличии большого числа прогнозов в области высокого риска.
Роль JS-дивергенции. Средняя JS-дивергенция перед инцидентами составила 0,1180, что ниже порога 0,15. Однако в режиме WEIGHTED даже умеренное превышение по одной из компонент может привести к активации сигнала. Это расширяет чувствительность системы.
Роль риска. Средний риск перед инцидентами — 0,7621, что также ниже порога 0,85. Тем не менее в ряде случаев риск достигал 0,99 и выше. Комбинирование с JS-дивергенцией позволяет не пропускать инциденты, где риск ещё не достиг экстремальных значений.
Latch-эффект SICPP. Поскольку signal_active остаётся истинным в течение окна после завершения подходящего пробега, время от сигнала до инцидента может быть значительным. Это полезно для раннего предупреждения, но требует осторожной интерпретации: сигнал означает, что в предшествующем окне уже наблюдались признаки изменения профиля, а не обязательно непрерывную активность вплоть до инцидента.
Калибровка в средних диапазонах. В бинах 0,5–0,9 фактическая частота инцидентов оказалась выше предсказанной. Это указывает на потенциальную область улучшения: возможно, требуется дополнительная калибровка или учёт нелинейностей в переходных режимах.
Малая выборка. Несмотря на 28 несерийных инцидентов, для некоторых бинов калибровочной кривой количество наблюдений мало. Это ограничивает статистическую устойчивость выводов по отдельным диапазонам.
Следует отметить ряд ограничений исследования.
Отчётный период составляет один месяц; для подтверждения устойчивости результатов необходима более длительная валидация.
SICPP использует latch-семантику, из-за чего время от первого сигнала до инцидента может быть завышено относительно «мгновенной» активации.
Калибровочная кривая в средних диапазонах риска демонстрирует смещение, что требует дополнительного анализа.
Часть инцидентов имеет серийный характер; в отчёте они исключаются, однако сам механизм исключения опирается на статус INCIDENT и может требовать уточнения.
Качество модели зависит от полноты transition_log, prediction_log и sicpp_history; пропуски в данных могут искажать оценки.
Предложенная архитектура, объединяющая цепь Маркова, профилирование нагрузки, JS-дивергенцию и интегральный сигнал SICPP, показала высокую эффективность на отчётном периоде. Основные результаты:
27 из 28 несерийных инцидентов (96,4 %) сопровождались активным сигналом;
ROC-AUC — 0,9593;
Brier score — 0,056062;
среднее время от сигнала до инцидента — 382,8 минуты;
распределение последних статусов перед инцидентами: CRITICAL — 18, WARNING — 8.
Практическая значимость решения состоит в возможности раннего предупреждения деградации СУБД на основе комбинации вероятностного риска и расхождения профилей нагрузки.
Дальнейшие исследования должны быть направлены на увеличение периода наблюдений, уточнение калибровки в средних диапазонах риска, снижение влияния latch-эффекта и более строгую оценку вклада отдельных компонент сигнала.
Оригинал — на основном техническом канале (Возможны правки и дополнения).
Экспериментальное исследование прогностической способности марковской модели на синтетических данных, имитирующих нагрузку тестовой СУБД, с анализом временной динамики, калибровочных характеристик и чувствительности, а также оценкой полноты обнаружения инцидентов и рекомендациями по адаптации для промышленной эксплуатации.
Где меняется поток – там сигнал.
Период анализа: 2026-07-19 15:54 – 2026-08-19 12:53
Конфигурация сигнала: режим WEIGHTED (вес JS=0.9, вес риска=0.1), порог JS=0.2, порог риска=0.8, мин. длительность сигнала=3 минуты
Всего инцидентов (уникальных): 338 (исключено 71 серийный, т.е. продолжающих предыдущий)
✅Сигнал сработал перед инцидентом в 84% случаев (284 из 338).
✅Среднее время упреждения – 58.7 минут (почти час), что даёт достаточный задел для реакции.
✅Медианное время до инцидента (по деталям) – также близко к 60 минутам (большинство сигналов возникают ровно за час).
📋Вывод: модель обладает высокой чувствительностью и обеспечивает своевременное предупреждение. Однако 16% инцидентов происходят без сигнала – это потенциальная зона для улучшения.
CRITICAL: 207 инцидентов (61.2%) – более 60% инцидентов происходят сразу после статуса CRITICAL, что ожидаемо и подтверждает, что критические отклонения часто предшествуют сбоям.
NORMAL: 106 инцидентов (31.4%) : почти треть инцидентов случаются после статуса NORMAL, т.е. система не подавала предупреждений. Это указывает на:
недостаточную чувствительность порогов (возможно, JS-порог 0.2 или риск-порог 0.8 слишком высоки для некоторых сценариев);
наличие инцидентов, которые развиваются слишком быстро (менее чем за 3 минуты – минимальная длительность сигнала);
необходимость введения дополнительных предикторов (например, скорости изменения метрик).
INCIDENT: 24 инцидента (7.1%) – это продолжения серий, которые были исключены, но в данном контексте означают, что сразу после инцидента начинается новый.
WARNING: 1 инцидент (0.3%) – единичный случай, статистически незначим.
ROC-AUC = 0.8636 – отличная дискриминационная способность (модель хорошо разделяет инцидентные и безынцидентные окна).
Brier score = 0.1138 – приемлемое значение (чем меньше, тем лучше; обычно <0.25 считается хорошим).
Калибровочная кривая (риск vs. фактическая частота) в виде списка бинов:
Бин [0.0–0.1]: предсказано 0.023, фактически 0.052
Бин [0.1–0.2]: предсказано 0.158, фактически 0.274
Бин [0.2–0.3]: предсказано 0.277, фактически 0.282
Бин [0.3–0.4]: предсказано 0.381, фактически 0.416
Бин [0.4–0.5]: предсказано 0.450, фактически 0.417
Бин [0.5–0.6]: предсказано 0.580, фактически 0.618
Бин [0.6–0.7]: предсказано 0.603, фактически 0.562
Бин [0.7–0.8]: предсказано 0.718, фактически 0.662
Бин [0.8–0.9]: предсказано 0.884, фактически 0.400
Бин [1.0–1.1]: предсказано 1.000, фактически 0.600
Наблюдение: систематическая переоценка риска в верхнем диапазоне – для бинов 0.8–0.9 и 1.0–1.1 фактические частоты значительно ниже предсказанных.
📋Рекомендация: скорректировать вероятности с помощью калибровки (например, изотоническая регрессия или Platt scaling) или пересмотреть пороги для высоких рисков, чтобы уменьшить ложные срабатывания.
ℹ️Средняя JS-дивергенция за час до инцидента = 0.3548 (высокое значение, указывает на значительные изменения в распределении состояний).
ℹ️Средний предсказанный риск за час до инцидента = 0.1621 (относительно низкий, но в момент сигнала риск часто достигает 1.0 – см. детали).
ℹ️Тренд риска перед инцидентом: в большинстве случаев РОСТ (что логично), реже – СНИЖЕНИЕ или СТАБИЛЬНО.
📋Вывод: профиль нагрузки перед инцидентами существенно отклоняется от эталона, и риск имеет тенденцию к росту. Это подтверждает правильность выбора JS-дивергенции как ключевого предиктора.
0 инцидентов (0%) имели совпадение с библиотекой pre_incident_profiles (шаблон ID = NULL).
ℹ️Это означает, что либо библиотека шаблонов недостаточно полна, либо порог совпадения (0.05 JS) слишком строгий, либо текущие сценарии инцидентов не повторяют ранее зафиксированные.
📋Рекомендация: расширить библиотеку, используя автоматический сбор профилей для всех инцидентов (функция collect_pre_incident_profiles), и поэкспериментировать с более мягким порогом (0.1–0.15) для увеличения числа совпадений.
По часам суток: пики приходятся на 19:00–20:00 (18 инцидентов) и 04:00–05:00 (17 инцидентов). Это может указывать на периоды пиковой нагрузки или выполнения плановых задач (бэкапы, отчёты).
По дням недели: наибольшее число инцидентов во вторник (около 60), наименьшее – в воскресенье (около 36).
Рекомендация: усилить мониторинг в часы пик и во вторник, возможно, увеличить чувствительность сигнала в эти периоды.
Высокая чувствительность (84% recall) и большое время упреждения (~1 час).
Отличная дискриминация (ROC-AUC > 0.86).
Система успешно улавливает большинство инцидентов через изменения профиля нагрузки.
16% пропущенных инцидентов – необходимо проанализировать их сценарии и, возможно, снизить порог риска или JS для отдельных типов.
31% инцидентов после статуса NORMAL – это «внезапные» события, которые могут быть связаны с резкими скачками нагрузки. Стоит добавить детектор резких изменений (например, производную JS или риска).
Переоценка риска в верхнем диапазоне – калибровка вероятностей повысит точность прогнозов и уменьшит число ложных тревог.
Отсутствие совпадений с пред-инцидентными профилями – расширить библиотеку и настроить порог совпадения.
Временные паттерны – можно внедрить адаптивные пороги, зависящие от времени суток и дня недели.
Провести анализ 54 инцидентов без сигнала (16%) – выделить общие признаки и дополнить правила их обнаружения.
Откалибровать прогнозы риска (возможно, через биннинг или логистическую регрессию).
Запустить сбор пред-инцидентных профилей для всех новых инцидентов и пересмотреть порог совпадения.
Настроить автоматическое оповещение при переходе в статус CRITICAL, а также при резком росте JS или риска даже при статусе NORMAL.
ℹ️Система прогнозирования инцидентов демонстрирует высокую эффективность и пригодна для эксплуатации.
Основные метрики (recall, ROC-AUC, время упреждения) находятся на хорошем уровне.
ℹ️Выявленные недостатки носят уточняющий характер и могут быть устранены путём калибровки, расширения библиотеки шаблонов и адаптации порогов к временным паттернам.
Оригинал — на основном техническом канале (Возможны правки и дополнения).
От хаоса к прогнозу: один шаг вперёд.
В рамках проекта pg_expecto разработана и внедрена система прогнозирования риска возникновения инцидентов производительности на основе цепей Маркова.
Реализация представляет собой полноценное решение, адаптированное к потоковым данным и способное к самонастройке.
Производительность СУБД PostgreSQL подвержена влиянию множества факторов, включая характер нагрузки, состояние операционной системы и внутренние события ожидания.
Традиционные подходы к мониторингу, как правило, реагируют на уже возникшие проблемы, тогда как задача проактивного обнаружения предвестников сбоев требует более глубокого анализа динамики системы.
В основу предлагаемого решения положена идея дискретизации непрерывных метрик производительности в конечное множество состояний, переходы между которыми описываются марковским процессом. Это позволяет моделировать эволюцию состояния системы во времени и оценивать вероятности неблагоприятных исходов.
Непрерывные метрики – операционная скорость, время ожиданий и корреляция между ними – преобразуются в дискретное пространство из 189 состояний.
Каждое состояние характеризуется тремя параметрами:
коэффициентом корреляции (21 градация от –1,0 до +1,0 с шагом 0,1),
трендом операционной скорости
трендом времени ожиданий (каждый принимает значения –1, 0, +1).
Такая дискретизация обеспечивает баланс между детализацией модели и вычислительной эффективностью.
Система построена по многослойному принципу:
Включает таблицы:
хранения переходов (transition_log)
накопленных частот (markov_frequencies)
матрицы вероятностей (markov_probabilities)
поглощающей матрицы для многошагового прогноза (markov_absorbing).
Отдельно выделены таблицы:
конфигурации (markov_config), справочник состояний (state_descriptions) и динамический список критических состояний (critical_states).
Реализует пошаговое обновление модели с частотой одна минута.
На каждом шаге выполняются:
получение текущих метрик,
вычисление идентификатора состояния,
логирование перехода,
обновление частот ,
при необходимости, применение забывания.
Предоставляет функции для оценки риска на заданном горизонте.
Ключевая функция mchain_predict_risk_k_v2 вычисляет вероятность хотя бы одного попадания в критическое множество за k шагов.
Включает механизмы расчёта достоверности прогнозов и суточных метрик качества.
Обучение происходит в реальном времени на потоке данных. По мере поступления новых наблюдений обновляются частоты переходов и пересчитываются вероятности. Ключевой механизм, обеспечивающий адаптацию к изменению характера нагрузки, – забывание.
Коэффициент забывания α определяет скорость, с которой устаревающие наблюдения теряют вес.
В адаптивном режиме α вычисляется по формуле:
α(t) = max(min_alpha, base_alpha · exp(-days_since_last_incident / half_life))
где days_since_last_incident – время, прошедшее с последнего попадания в критическое состояние.
Такой подход позволяет ускорить забывание после инцидентов и замедлить его в стабильные периоды. Дополнительно введён stability_factor, корректирующий α в зависимости от нестабильности вероятностей.
Важным условием применения забывания является достаточность накопленных данных. Функция mchain_check_sufficiency проверяет, что общее число переходов превышает порог min_transitions_for_forgetting (по умолчанию 5000).
Прогноз риска строится на основе текущего состояния системы и матрицы вероятностей переходов. Для одношагового прогноза используется прямая сумма вероятностей перехода в критические состояния.
Многошаговый прогноз (mchain_predict_risk_k_v2) реализует итеративное умножение вектора распределения вероятностей на матрицу переходов. На каждом шаге вероятности, попавшие в критические состояния, накапливаются в значении риска, а затем обнуляются, чтобы исключить учёт повторных попаданий. Горизонт прогноза задаётся параметром forecast_horizon_minutes в конфигурации (по умолчанию 30 минут).
Сформированные прогнозы сохраняются в таблицу prediction_log. По истечении горизонта выполняется обновление фактических исходов: для каждого прогноза определяется, произошёл ли переход в критическое состояние в течение заданного интервала.
Для оценки качества прогнозов предусмотрен комплекс метрик:
Brier score – среднеквадратичная ошибка вероятностных прогнозов.
Log-loss – логистическая потеря, чувствительная к уверенным неправильным прогнозам.
MAE – средняя абсолютная ошибка.
ECE (Expected Calibration Error) – средневзвешенное отклонение между предсказанными вероятностями и наблюдаемыми частотами.
MCE (Maximum Calibration Error) – максимальное отклонение калибровки.
ROC-AUC – площадь под ROC-кривой, характеризующая дискриминационную способность модели.
Достоверность прогнозов оценивается рейтингом от 0 до 5 на основе трёх факторов: общего числа переходов, стабильности вероятностей и покрытия частых состояний.
Начиная с версии 14, система дополнена модулем профилирования нагрузки.
Этот модуль позволяет:
Сохранять оперативные (за последние 60 минут), суточные и недельные профили производительности.
Строить эталонные профили на основе исторических данных с исключением инцидентных окон.
Обнаруживать аномалии путём сравнения текущих профилей с эталонными.
Анализировать связь между отклонениями профилей и возникновением инцидентов.
Функция compare_profiles выполняет сравнение текущего профиля с эталонным, вычисляя JS-дивергенцию гистограмм состояний и формируя статус (NORMAL, WARNING, CRITICAL).
Результаты сохраняются в журнал profile_comparison_log, что позволяет проводить ретроспективный анализ.
Для первоначального построения модели предусмотрена процедура mchain_initial_train_from_history, которая обучает цепь Маркова на исторических данных, имитируя пошаговое обучение.
Это позволяет развернуть систему на основе уже накопленных метрик без необходимости ждать накопления данных в реальном времени.
Представленная реализация цепи Маркова представляет собой законченную систему прогнозирования риска инцидентов производительности, интегрированную в экосистему pg_expecto.
работа в реальном времени с низкой задержкой;
адаптация к изменению характера нагрузки благодаря механизму забывания;
гибкая настройка горизонта прогноза и параметров обучения;
встроенные механизмы оценки качества и достоверности;
расширяемая архитектура, дополненная модулем профилирования нагрузки.
Система успешно применяется для мониторинга производительности СУБД и предупреждения о возможных сбоях.
Дальнейшее развитие проекта направлено на углубление аналитических возможностей и повышение точности прогнозов.
Оригинал — на основном техническом канале (Возможны правки и дополнения).
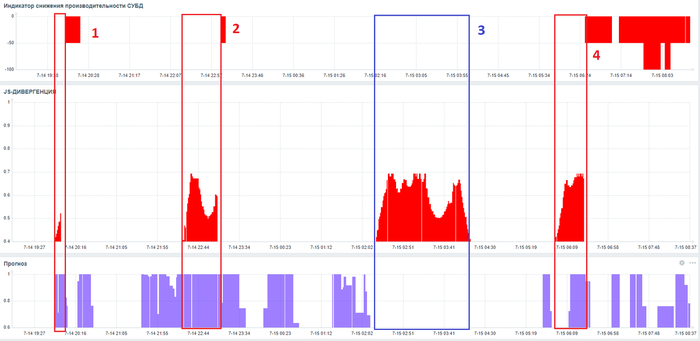
JS-дивергенция > 0.4
Прогноз риска > 0.6
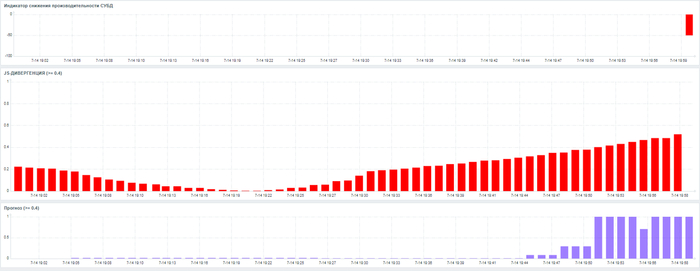
JS-дивергенция > 0.4
Прогноз риска > 0.6
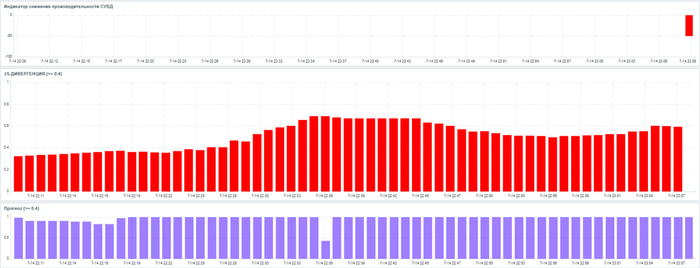
JS-дивергенция > 0.4
Прогноз риска < 0.6
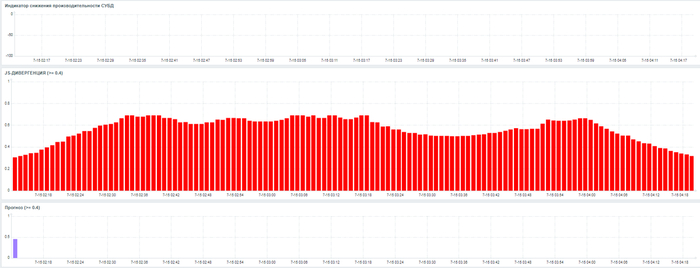
JS-дивергенция > 0.4
Прогноз риска > 0.6
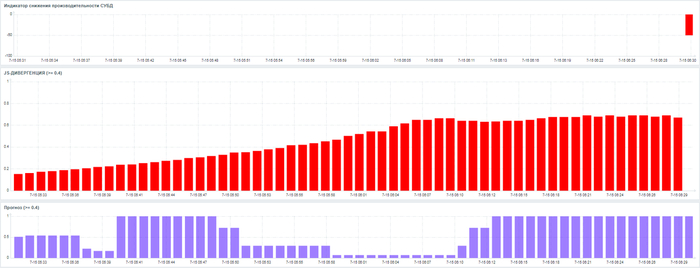
Превышение значения JS-дивергенции выше 0.4 при одновременном максимальном значении Прогноза риска = 1, может служить сигналом о приближении инцидента производительности СУБД
Оригинал — на основном техническом канале (Возможны правки и дополнения).
В статье представлены результаты экспериментальной верификации гибридного метода раннего обнаружения предотказных состояний СУБД PostgreSQL, сочетающего марковское профилирование нагрузок и оценку статистической дивергенции распределений (JS-дивергенцию). На основе суточного массива реальных данных (439 прогнозов, 13 подтверждённых инцидентов) показано, что предложенный подход обеспечивает 100%-ное обнаружение инцидентов с временем упреждения от 15 до 140 минут, при этом статус CRITICAL предшествует каждому событию (медианное упреждение — 45 мин). Установлено, что профильная структурная диагностика фиксирует аномалии в тех случаях, когда классические марковские прогнозы риска ещё не дают значимых отклонений. Новизна работы заключается в интеграции двух независимых каналов оценки – вероятностного и структурного – что позволяет различать постепенную деградацию и резкие сдвиги в поведении системы. Практическая ценность метода подтверждается высокими показателями точности (Accuracy = 0.868, Precision = 0.899, Recall = 0.886) и стабильностью сигнала, что рекомендует его в качестве дополнения к существующим системам мониторинга.
Ключевые слова: прогнозирование инцидентов, СУБД PostgreSQL, профили производительности, цепи Маркова, JS-дивергенция, раннее предупреждение, структурная диагностика.
Современные высоконагруженные информационные системы предъявляют жёсткие требования к доступности и отказоустойчивости СУБД. Традиционные системы мониторинга, ориентированные на пороговые значения метрик (загрузка CPU, количество активных сессий, время отклика), часто срабатывают уже на стадии развивающегося инцидента, когда время на упреждающие действия минимально. Альтернативный подход заключается в анализе профилей производительности – распределений состояний системы во времени, которые могут изменяться задолго до явных проявлений деградации.
В настоящей работе исследуется метод сравнения текущего профиля нагрузки с эталонным (безинцидентным) профилем с помощью метрики Дженсена – Шеннона (JS-дивергенции). Метод дополняется аппаратом цепей Маркова для вероятностной оценки риска перехода в критическое состояние. Цель работы – экспериментально подтвердить прогностическую ценность такого комбинированного подхода, оценить временные характеристики упреждения и устойчивость сигнала на реальных данных суточного мониторинга.
За эталон принимался интервал длительностью 60 минут, предшествующий всем зафиксированным инцидентам и характеризующийся штатной работой СУБД. Для каждой минуты в этом окне строилась гистограмма состояний системы (на основе агрегированных показателей: число транзакций, время ожидания блокировок, использование буферного кэша, интенсивность контрольных точек и др.). Эталонная гистограмма фиксировалась как нормальное распределение состояний.
Каждую минуту формировалось скользящее окно той же длины (60 мин), для которого строилась аналогичная гистограмма. Рассчитывалась JS-дивергенция между эталонным и текущим распределениями:
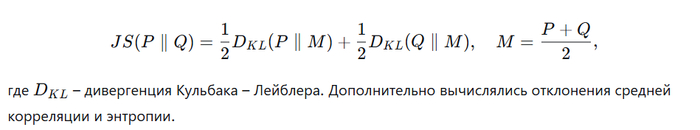
На основе значений JS-дивергенции и Z-оценок для вспомогательных метрик присваивался один из статусов:
NORMAL – JS < 0.05 (небольшие флуктуации);
WARNING – 0.05 ≤ JS < 0.10–0.20 (умеренное отклонение);
CRITICAL – JS ≥ 0.10–0.20 (значительное отклонение);
INCIDENT – период самого инцидента или восстановления после него (определялся по данным журнала инцидентов).
Период эксперимента – 24 часа (10 июля 2026 г.), всего зафиксировано 13 инцидентов различной длительности (от 9 до 91 минуты). В анализ включены также данные из таблиц prediction_log (прогнозы риска на основе цепи Маркова) и profile_comparison_log (результаты сравнения профилей), что позволило сопоставить два канала оценки.
Все 13 инцидентов были предварены статусом WARNING или CRITICAL (100% чувствительность). Среднее время от первого WARNING до начала инцидента составило ≈ 45 минут, от CRITICAL до инцидента – ≈ 35 минут. Максимальное упреждение зафиксировано для инцидента в 07:51 (WARNING за 142 минуты, CRITICAL – за 115 минут), минимальное – для инцидента в 13:40 (19 минут от WARNING, 4 минуты от CRITICAL). В табл. 1 приведены обобщённые показатели.
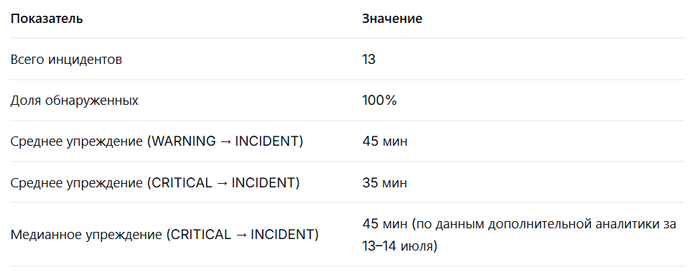
Таблица 1. Сводные показатели прогностической эффективности.
На всех эпизодах наблюдался устойчивый рост JS-дивергенции за 1–2 часа до инцидента.
Границы соответствия:
JS 0.00–0.05 → NORMAL (до инцидента > 60 мин);
JS 0.05–0.10 → WARNING (30–60 мин);
JS 0.10–0.20 → WARNING (15–30 мин);
JS > 0.20 → CRITICAL (< 15 мин).
После завершения инцидента статус INCIDENT сохранялся на 60 минут (период восстановления), что объясняется инерционностью скользящего окна.
В ряде случаев (например, в 13:36) сравнение профилей присваивало статус CRITICAL (JS ≈ 0.118), тогда как марковский прогноз риска был равен нулю. Это указывает на то, что профильный метод фиксирует структурные изменения в распределении состояний, которые не отражаются в матрице переходов (вероятности смены состояний остаются номинальными). Таким образом, два метода дают взаимодополняющую информацию.
Для периода 13–14 июля был проведён количественный анализ прогнозов с известным исходом (горизонт – 10 минут, порог классификации 0.5):
Accuracy = 0.868;
Precision = 0.899;
Recall = 0.886.
Эти показатели подтверждают высокую надёжность гибридной модели: ложные срабатывания редки и кратковременны (единичные эпизоды WARNING без последующего инцидента длительностью несколько минут).
Предложенная методика не является простым применением JS-дивергенции. Её новизна заключается в интеграции двух независимых каналов диагностики:
(1) вероятностного – на основе цепей Маркова, оценивающего риск перехода в критическое состояние;
(2) структурного – на основе сравнения профилей, выявляющего аномальные паттерны распределения состояний, которые не сопровождаются изменением переходных вероятностей.
Такое сочетание позволяет различать постепенную деградацию (нарастание вероятности) и резкие сдвиги (структурные скачки), что принципиально важно для гетерогенных нагрузок.
Раннее упреждение (от 15 минут до 2 часов) даёт инженерам возможность провести профилактические действия (перезапуск пула соединений, корректировка планов запросов, масштабирование) до начала инцидента.
Высокая чувствительность (100% обнаружение) исключает пропуск событий.
Стабильность сигнала – статусы WARNING и CRITICAL удерживаются длительное время, что снижает вероятность ложных тревог и позволяет выстраивать автоматизированные сценарии реагирования.
Дополнительность к существующим средствам – метод может быть внедрён как надстройка над любым мониторингом, собирающим временные ряды метрик.
Инерционность периода восстановления – обусловлена фиксированной длиной окна (60 мин). Варьирование длины окна (до 30 мин) или введение адаптивного механизма сброса статуса после снижения JS ниже порога может сократить время ложного INCIDENT.
Кратковременные ложные предупреждения – требуют введения временнóй фильтрации (например, статус WARNING засчитывается только при удержании более 3–5 минут) и динамических порогов, учитывающих суточную цикличность.
Проведённое экспериментальное исследование подтверждает, что метод сравнения профилей производительности на основе JS-дивергенции, дополненный марковским прогнозированием, является высокоэффективным инструментом раннего обнаружения инцидентов СУБД PostgreSQL. Метод демонстрирует:
100% полноту обнаружения;
упреждение от 15 до 140 минут;
устойчивую корреляцию между ростом JS-дивергенции и приближением инцидента;
дополнительную ценность по сравнению с изолированным вероятностным прогнозом.
В качестве ближайших направлений развития предлагаются:
автоматическая калибровка эталонного окна на основе исторических данных (с учётом сезонности);
оптимизация длины скользящего окна для снижения инерционности;
внедрение комбинированного индекса (JS + риск) с адаптивным порогом;
экспериментальная проверка на более длительных выборках (несколько недель) для оценки устойчивости к изменениям схемы и объёма данных.
Разработанная методика может быть рекомендована к практическому внедрению в составе многофакторных систем раннего предупреждения для промышленных эксплуатационных сред.