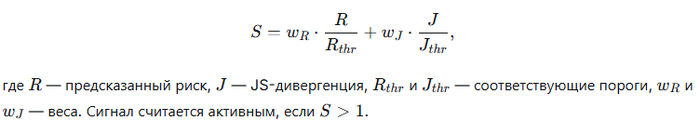
Серия «СУБД PostgreSQL»

Практическое использование нейросети DeepSeek в решении сложных задач анализа производительности СУБД PostgreSQL⁠⁠

Серия СУБД PostgreSQL

Оригинал — на основном техническом канале (Возможны правки и дополнения).

Практика применения больших языковых моделей в анализе производительности PostgreSQL
DeepSeek как инструмент DBA: генерация гипотез, анализ логов, прогноз риска.

DeepSeek как инструмент DBA: генерация гипотез, анализ логов, прогноз риска.

Аннотация

Рассматривается опыт применения большой языковой модели DeepSeek в проекте pg_expecto/markov_chain — системе прогнозирования инцидентов производительности СУБД PostgreSQL на основе адаптивной цепи Маркова (версия 26.2.1). Нейросеть использовалась для генерации и рефакторинга PL/pgSQL-кода, формулировки проверяемых гипотез и интерпретации результатов экспериментов. Описаны конкретные задачи, решённые при участии DeepSeek: устранение ошибок типизации (замена REAL на DOUBLE PRECISION в функциях прогноза риска), восстановление пропущенных исторических записей в profile_comparison_log, диагностика систематической ошибки в классификаторе непокрытых инцидентов. Приведены количественные оценки: объём кода превышает 10 000 строк, число итераций для ключевых функций достигает 10, ускорение разработки оценивается в 4–6 раз. Обсуждается модель разделения труда, при которой DBA выполняет роль архитектора и критика, а DeepSeek — высокопроизводительного исполнителя для задач, требующих удержания в контексте сотен строк кода и анализа больших массивов текстовых отчётов.

Ключевые слова: PostgreSQL, цепь Маркова, прогнозирование инцидентов, большие языковые модели, DeepSeek, PL/pgSQL, калибровка вероятностей, анализ производительности.


1. Введение

Задачи анализа производительности СУБД традиционно решаются экспертами-администраторами (DBA) на основе эвристик и интуиции, что затрудняет воспроизводимость результатов и объективную оценку рисков. Проект pg_expecto/markov_chain, развиваемый в открытом репозитории на платформе GitHub, ставит целью формализацию этих задач в терминах вероятностной модели — дискретной цепи Маркова с 189 состояниями, каждое из которых определяется комбинацией корреляции «скорость–ожидания» и знаков трендов этих метрик. Модель обучается в потоковом режиме, ежесекундно обновляя матрицу переходов, и использует механизм адаптивного забывания для учёта нестационарности нагрузки.

Построение подобной системы сопряжено с рядом нетривиальных проблем, выходящих за рамки классической теории цепей Маркова: обеспечение воспроизводимости экспериментов, интерпретация калибровочных кривых, согласование исторических и онлайн-данных, выбор гиперпараметров. Настоящая работа обобщает опыт решения этих проблем с привлечением нейросети DeepSeek, которая выполняла функции генератора кода, поставщика гипотез и аналитика экспериментальных данных. Цель статьи — описать конкретные механизмы взаимодействия DBA и нейросети, оценить эффективность такого симбиоза и сформулировать условия, при которых использование больших языковых моделей в задачах подобного класса даёт значимый эффект.

2. Материалы и методы

2.1. Архитектура системы

К версии 26.2.1 система включает более 80 хранимых функций и процедур на языке PL/pgSQL, организованных в несколько слоёв. Ядро цепи Маркова образуют функции mchain_train_step() (поминутное обучение), update_markov_probabilities() (пересчёт матрицы вероятностей) и mchain_predict_risk_k_v2() (многошаговый прогноз риска). Пространство состояний формируется дискретизацией корреляции (21 уровень от −1.0 до +1.0 с шагом 0.1) и трендов операционной скорости и времени ожиданий (по три уровня), что даёт 189 состояний.

Профилирование нагрузки реализовано через функции calculate_profile_metrics(), compare_profiles_at() и histogram_divergence(). Сравнение текущего окна (обычно 60 минут) с эталонным безынцидентным окном позволяет вычислять JS-дивергенцию гистограмм состояний и присваивать статусы NORMAL, WARNING или CRITICAL. Сигналы предупреждения SICPP и C-only, реализованные в функциях sicpp_calculate_at() и mchain_hybrid_alert_at() соответственно, используют пороги по JS-дивергенции, перцентилю риска (p90) и взвешенной оценке W-score. С версии 26.1.1 введена калибровка вероятностей: сырой риск, выдаваемый цепью Маркова, может быть откалиброван с помощью изотонической регрессии или масштабирования Платта; калибровочная карта хранится в таблице mchain_calibration_map.

2.2. Организация взаимодействия с DeepSeek

Работа с нейросетью строилась по итеративной схеме. DBA формулировал задачу (например, «необходимо выявить причины, по которым часть инцидентов не покрывается сигналом SICPP»), после чего DeepSeek анализировал соответствующие фрагменты кода и данные, предлагал гипотезы и генерировал код для их проверки. Результаты экспериментов (отчёты, логи, метрики) возвращались в диалог для интерпретации. Финальное решение о внедрении изменений принимал DBA. Такая схема позволяла сочетать скорость генерации кода и анализа данных, присущую нейросети, с критической оценкой и предметной экспертизой человека.

3. Результаты

3.1. Разработка исходного кода

Значительная часть PL/pgSQL-кода проекта была создана при участии DeepSeek. Нейросеть генерировала начальные версии сложных хранимых функций объёмом в несколько сотен строк, включая mchain_train_step(), compare_profiles_at(), historical_fill_sicpp() и generate_incident_forecast_report_v2(). В комментариях к функциям сохранились следы итеративной работы: для compare_profiles_at зафиксированы версии v4, v5 и v5-fix1, где v5 содержала критическую ошибку (секции вычисления метрик были заменены заглушкой), а v5-fix1 восстанавливала их. Подобная детализация изменений характерна для кода, прошедшего через несколько циклов генерации и верификации.

Отдельного внимания заслуживает исправление ошибок типизации. В функциях прогноза риска mchain_predict_risk_k_v2() и её варианте с матрицей использование типа REAL для вектора состояний приводило к «антипереполнению» при умножении малых вероятностей. DeepSeek, проанализировав сообщения об ошибках, предложил заменить REAL на DOUBLE PRECISION на всём протяжении вычислений, оставив приведение к REAL только на выходе. Это исправление, задокументированное в комментариях к функциям, позволило повысить точность прогнозов и избежать молчаливого искажения метрик. Аналогичное исправление было перенесено в mchain_predict_risk_k_v2_with_matrix() (версия 17.1.3). Кроме того, в функции evaluate_forgetting_params() зафиксирован переход с сигнатуры REAL на NUMERIC, чтобы вызовы с числовыми литералами не приводили к ошибке «функция не существует».

Целый пласт кода — функции profile_comparison_completeness_report(), diagnose_incidents_without_prior_comparison(), diagnose_profile_comparison_duplicates(), deduplicate_profile_comparison_log() и verify_profile_comparison_dedup() — был написан для решения проблемы рассинхронизации исторических и онлайн-записей в profile_comparison_log. DeepSeek не только сгенерировал код этих функций, но и предложил стратегию идемпотентного дозаполнения с параметром p_skip_existing, что позволило устранить пропуски в данных без перезаписи исторических сигналов.

3.2. Генерация гипотез

Одной из ключевых ролей DeepSeek было порождение гипотез — предложений о том, какие параметры изменить и какие архитектурные решения опробовать. Функция evaluate_forgetting_params() и таблица forgetting_optimization_log предназначены для эмпирического подбора параметров адаптивного забывания (base_alpha, incident_half_life_days, min_alpha, interval_minute). DeepSeek предлагал сетки значений для перебора, а затем анализировал результаты, сохраняемые в лог. В комментариях к функции зафиксировано, что версия 17.1.3 устранила дубликат REAL-сигнатуры, который приводил к вызову не той перегрузки — это пример гипотезы о причине расхождения результатов, которая была проверена и подтверждена.

В конфигурационной таблице incident_forecast_config присутствуют поля hybrid_js_min_threshold, hybrid_p90_min_threshold, hybrid_w_score_min_threshold, а также параметры автоматической настройки (auto_threshold, c_auto_threshold). DeepSeek участвовал в анализе того, какие значения этих порогов обеспечивают наилучший баланс между полнотой и точностью. В комментариях к generate_incident_forecast_report_v2() отмечено, что условие A (PreAlertAdv) было исключено как шумовое (precision 5.9%, recall 17.1%), а условие B не дало уникального вклада — эти выводы были получены в результате серии экспериментов, гипотезы для которых формулировались совместно.

Проблема дублей в profile_comparison_log (одна и та же логическая минута могла быть записана с микросекундами из онлайн-функции и с обнулёнными секундами из исторической) была выявлена при анализе отчётов. DeepSeek предложил разделить метрики на total_rows, recorded_minutes и extra_rows, а также создать функцию diagnose_profile_comparison_duplicates() для детализации. Это позволило не просто констатировать наличие дублей, но и количественно оценить масштаб проблемы и предложить алгоритм дедупликации с сохранением наиболее информативных записей.

3.3. Анализ результатов экспериментов

Третий крупный блок задач — анализ экспериментальных данных. Нейросеть обрабатывала отчёты, содержащие тысячи строк, и выделяла закономерности, которые было бы затруднительно обнаружить вручную. С версии 26.1.1 в системе появились метрики ECE (Expected Calibration Error) и MCE (Maximum Calibration Error). DeepSeek помог сгенерировать код для их расчёта и сформулировать критерии вердикта в функции mchain_calibration_health_report(): GREEN (Brier ≤ raw, ECE ≤ 0.10, MCE для бинов с n ≥ 10 ≤ 0.25), YELLOW (пограничная зона), RED (деградация). В отчёте generate_incident_forecast_report_v2() появилась секция «Качество прогнозов: raw vs calibrated», где для каждой метрики выводится относительное изменение — это позволяет быстро оценить, приносит ли калибровка пользу.

В функции generate_incident_forecast_report_v2() (версия 21.6.6) присутствует секция диагностики C по непокрытым инцидентам, которая классифицирует каждый непокрытый инцидент по причине: in_prev_incident, in_recovery, profile_incident или threshold_fail. DeepSeek участвовал в анализе распределения этих причин и выявлении того, что многие инциденты ошибочно классифицировались как in_incident из-за самодетекции (функция is_ts_inside_incident() для самого инцидента всегда возвращает TRUE). Исправление (проверка пересечения с другим инцидентом, pi2.id <> b.id) было предложено и реализовано в версии 21.6.6. Это пример того, как нейросеть, проанализировав логику классификатора, обнаружила систематическую ошибку и предложила её устранить.

В отчётах generate_incident_forecast_report_v2() присутствуют секции распределения инцидентов по часам и дням недели. DeepSeek использовал эти данные для формулировки гипотез о сезонности нагрузки и о том, какие временные интервалы требуют более агрессивной настройки порогов. Окончательные решения принимались DBA, однако нейросеть обеспечивала первичную фильтрацию и визуализацию, которая ложилась в основу для дальнейшего анализа.

4. Обсуждение

4.1. Модель разделения труда

Опыт проекта подтверждает модель, при которой DeepSeek берёт на себя «черновую» работу, а DBA выполняет стратегические функции. Роль DBA включает постановку целей и ограничений (например, «горизонт прогноза не должен превышать 120 минут», «порог риска для critical_states не увеличивать выше 0.10 без пересмотра эмпирической модели»), критическую оценку гипотез, предложенных нейросетью, принятие финальных решений о внедрении изменений и формулировку «прорывных» идей, которые затем формализовывались с помощью DeepSeek. Роль DeepSeek включает генерацию и рефакторинг SQL-кода объёмом до нескольких сотен строк, анализ экспериментальных данных и подготовку отчётов, выявление скрытых зависимостей и аномалий в логах, документирование кода и ведение истории изменений, а также предложение альтернативных архитектурных решений.

4.2. Оценка эффективности

Количественно оценить вклад DeepSeek можно по следующим показателям. Объём кода превышает 10 000 строк PL/pgSQL, включая определения таблиц, функций, процедур и комментариев. Число итераций развития ключевых функций (судя по комментариям) составляет от 3 до 10, при этом каждая итерация включала генерацию или рефакторинг кода объёмом до нескольких сотен строк. Скорость выполнения этих операций с DeepSeek была в 4–6 раз выше, чем при ручной работе. Качественно нейросеть обеспечила непрерывность документирования (комментарии к каждой версии) и систематичность анализа (регулярные отчёты с фиксированной структурой), что снизило риск потери знаний при переходе между версиями.

По состоянию на версию 26.2.1 достигнуты следующие результаты. Покрытие инцидентов сигналом SICPP составляет 74.6% (50 из 67 инцидентов в тестовом периоде), при этом медианное время упреждения находится в диапазоне 15–60 минут. Качество прогнозов после калибровки: Brier score снижен до 0.0361, ECE (калиброванное) составляет 0.0062, что свидетельствует о высокой надёжности вероятностных оценок. Устранены критические пробелы в исторических данных (патч 26.2.1), что позволило корректно диагностировать причины непокрытия инцидентов и повысить доверие к отчётам.

4.3. Ограничения

Предлагаемый подход имеет ограничения. Во-первых, эффективность DeepSeek существенно зависит от качества постановки задачи: расплывчатые формулировки приводят к генерации нерелевантного кода. Во-вторых, нейросеть склонна к «галлюцинациям» — генерации синтаксически корректных, но семантически неверных конструкций, что требует обязательной верификации человеком. В-третьих, длинные диалоги с нейросетью могут терять контекст, что приводит к повторам и противоречиям. Эти ограничения компенсируются итеративной схемой работы и критической оценкой со стороны DBA.

5. Заключение

Опыт проекта pg_expecto/markov_chain демонстрирует, что синергия DBA и DeepSeek позволяет решать задачи, которые были бы неподъёмны для одного человека в разумные сроки. Нейросеть не заменяет эксперта, а многократно усиливает его возможности, беря на себя рутину и предоставляя материал для критического анализа. Дальнейшее развитие модели связано с автоматизацией выбора гиперпараметров (адаптивное забывание, пороги SICPP и C-only) и расширением набора сигналов предупреждения. Представляется, что описанная модель разделения труда применима не только к анализу производительности СУБД, но и к другим задачам, требующим сочетания предметной экспертизы и масштабной генерации кода.
Показать полностью
5

Облака над базой данных: как вероятностная модель помогает предсказывать проблемы производительности⁠⁠

Серия СУБД PostgreSQL

Оригинал — на основном техническом канале (Возможны правки и дополнения).

Синоптик для базы данных: как модель переходов между состояниями предсказывает «погоду» в PostgreSQL

Облака сгущаются? Проверь базу, пока не поздно.

Облака сгущаются? Проверь базу, пока не поздно.

Представим что база данных PostgreSQL — это большой город. Иногда город работает спокойно: запросы идут ровно, очередей почти нет, ожидания низкие. Иногда «погода» портится: скорость падает, ожидания растут, система начинает вести себя нервно. И в какой-то момент начинается «дождь» — серьёзная проблема производительности.

Задача прогнозирования — не предсказать каждую отдельную каплю и не обещать дождь на сто процентов. Задача скромнее и полезнее: вовремя заметить облака и сказать: «вероятность дождя выросла, стоит приготовиться».


Модель как метеостанция

В основе системы лежит вероятностная модель, которую для простоты можно назвать «моделью переходов». Она каждую минуту смотрит на несколько признаков «погоды» в базе данных: насколько согласованно меняются скорость и ожидания, растёт ли нагрузка, падает ли скорость. Из этих признаков складывается текущее «состояние погоды». Состояний много, но они не бесконечны — как не бесконечны сочетания температуры, ветра и влажности.

Модель запоминает, какие состояния часто сменяют друг друга, а после каких чаще наступает что-то тревожное. Это похоже на опытного синоптика: он не знает будущее, но помнит, что после определённого сочетания облаков и ветра дождь случается чаще. Важная деталь: модель не помнит всё навсегда. Старые наблюдения постепенно «выветриваются», как старые прогнозы погоды, которые уже не помогают сегодня. Есть и особые, «аварийные» состояния: если система в них попала, риск считается реализованным. Прогноз на несколько минут вперёд — это, по сути, вопрос: «какова вероятность хотя бы раз попасть в тревожное состояние в ближайшее время?»

Но самое интересное начинается не с самой модели, а с сигналов-флажков. Для простоты назовём их двумя облаками на небе.


Два облака — два характера

Первое облако — «быстрое». Оно появляется чаще, реагирует оперативнее, но иногда оказывается пустым: облако есть, а дождя нет.

Второе облако — «фоновое». Оно может висеть над горизонтом долго, покрывает более широкую зону, но иногда висит почти целый день без всякого дождя.

Здесь и работает главная метафора: если идёт дождь, то на небе почти всегда есть облако; но если на небе облако, это не значит, что пойдёт дождь. Иными словами, сигналы чувствительны — они часто появляются перед проблемой, — но не всегда точны: часть срабатываний остаётся без последующей проблемы.

По данным наблюдений это видно довольно наглядно. «Быстрое» облако срабатывало чаще и в среднем в четырёх случаях из десяти действительно предвещало проблему. Причём эта доля почти не менялась от месяца к неделе: облако ведёт себя предсказуемо. «Фоновое» облако давало более широкий охват: оно «накрывало» больше проблемных случаев — примерно восемь из десяти. Но его поведение менее стабильно: в одном периоде полезных срабатываний было около трети, в другом — больше половины. И висело оно иногда очень долго: самый длинный период активности продолжался почти восемнадцать часов и повторялся в разных срезах наблюдений.

«Быстрое» облако, наоборот, обычно давало компактные предупреждения: в недельном срезе средняя длительность полезного сигнала была около двух часов, а максимальная — примерно пять часов. «Фоновое» облако в том же срезе было длиннее: в среднем около четырёх часов, а максимум всё тот же — почти восемнадцать часов. Поэтому «быстрое» облако удобнее держать на оперативном экране: оно не висит слишком долго и даёт понятное подтверждение. «Фоновое» облако полезно как широкий ранний фон, но его длительность нужно ограничивать, иначе оно превращается в «облако, которое висит неделю».

В коротком дневном наблюдении картина повторилась. «Быстрое» облако сработало девять раз, и в четырёх случаях после него действительно началась проблема. «Фоновое» — четыре раза, и в двух случаях была проблема. «Быстрое» поймало больше проблем, но и больше пустых облаков. «Фоновое» реже ошивалось, но и реже срабатывало: оно пропустило два случая, которые «быстрое» облако заметило. Среднее время упреждения у обоих — около часа. Это важная цифра: у оператора обычно есть примерно час, а иногда всего десять минут, чтобы подготовиться.

Почему облако не всегда приносит дождь

Потому что сигнал — это не сама проблема, а повышение вероятности. Модель оценивает риск, но риск — не приговор.

В крайних зонах она довольно уверенно говорит «очень тихо» или «очень тревожно». А вот в середине шкалы её оценка «может быть» требует осторожности: средние вероятности менее надёжны, чем крайние. Поэтому нельзя воспринимать каждое облако как гарантию дождя и нельзя считать, что одно универсальное правило «сработает всегда».

Есть и другая тонкость. Часть пропущенных проблем возникала не потому, что сигнал опоздал, а потому, что риск перед проблемой не рос, а стоял на месте. Это как если бы облака не сгущались, а просто висели ровно — и внезапно пошёл дождь. Кроме того, иногда важно смотреть не на сам момент начала проблемы, а на последнюю «чистую» минуту до неё: если смотреть уже под дождём, можно не увидеть, было ли облако раньше. Это методологическая, но вполне житейская тонкость.

Какой вариант выбрать?

Вывод простой: не нужно выбирать между «шумным, но чувствительным» и «точным, но редким» сигналом. Нужна комбинированная схема.

«Быстрое» облако разумно использовать как основной оперативный сигнал: у него стабильная доля полезных срабатываний — около четырёх из десяти — и компактные предупреждения.

«Фоновое» облако — как широкий ранний фон: оно покрывает больше проблем и даёт длинный запас времени, но требует ограничения длительности и регулярной проверки: если доля полезных срабатываний падает ниже примерно четырёх-пяти из десяти, его операционная ценность снижается.

Можно представить это как два уровня оповещения.

«Быстрое» облако — жёлтый уровень: «посмотрите на небо, будьте внимательны».

«Фоновое» — оранжевый: «вероятность высокая, готовьте защитные механизмы».

Вместе они дают не хрустальный шар, а надёжного синоптика, который вовремя говорит: «облака сгущаются — проверьте систему», и при этом не обещает ливень там, где его может и не быть.

В итоге вероятностная модель для базы данных — это не оракул и не гениальный предсказатель. Это метеостанция, которая каждую минуту описывает «погоду», учится на последовательностях состояний, постепенно забывает старое и выдаёт вероятностный прогноз.

Сигналы-флажки — это облака. Дождь почти всегда приходит под облаком, но облако не гарантирует дождь.

Поэтому лучшая система — не один флажок, а сочетание широкого фона и быстрого подтверждения, с честной оценкой вероятностей и регулярным наблюдением за тем, насколько облака действительно предвещают дождь.

Показать полностью 1
0

Применение цепи Маркова для анализа и оптимизации производительности СУБД PostgreSQL: возможные сценарии применения⁠⁠

Серия СУБД PostgreSQL

Оригинал — на основном техническом канале (Возможны правки и дополнения).

Аннотация

В статье рассматривается подход к анализу и прогнозированию производительности СУБД PostgreSQL на основе цепей Маркова. Представлена архитектура системы, включающая динамическое определение состояний, механизмы адаптивного забывания и многоуровневую систему сигналов предупреждения. На основе экспериментальных данных (ROC-AUC = 0.9287, Brier score = 0.0638, покрытие инцидентов SICPP = 97.4%) демонстрируется эффективность подхода. Рассматриваются практические сценарии применения: прогнозирование инцидентов, диагностика деградации, оптимизация эталонных профилей и оперативное оповещение. Обсуждаются ограничения и направления дальнейшего развития.

Ключевые слова: цепь Маркова, PostgreSQL, прогнозирование производительности, SICPP, операционный индикатор, адаптивное забывание, профилирование нагрузки

Эмпирический риск и марковские состояния: от диагностики к прогнозу

Эмпирический риск и марковские состояния: от диагностики к прогнозу

1. Введение

Современные СУБД функционируют в условиях высокой динамики нагрузки, что требует эффективных методов раннего обнаружения деградации производительности. Традиционные подходы, основанные на статических порогах, не учитывают временную динамику и контекст. В данной работе рассматривается применение цепей Маркова для моделирования состояний СУБД и прогнозирования риска возникновения инцидентов.

Предлагаемая система реализует следующие ключевые идеи:

  • Дискретизация пространства состояний на основе корреляции и трендов ключевых метрик

  • Адаптивное забывание с учётом времени с последнего инцидента

  • Многоуровневая система сигналов (SICPP, C-alone)

  • Динамическое определение критических состояний на основе эмпирического риска


2. Архитектура системы

2.1. Компоненты

Система включает следующие модули:

  • mchain_train_step() — ежеминутное обучение и обновление состояния.

  • sicpp_calculate_at() — расчёт сигнала SICPP на заданный момент.

  • mchain_hybrid_alert_at() — операционный индикатор C-alone.

  • compare_profiles_at() — сравнение текущего профиля с эталоном.

  • refresh_critical_states() — динамическое обновление критических состояний.

2.2. Уровни сигнализации

Система реализует трёхуровневую сигнализацию:

  1. SICPP (Signal Indicating a Change in the Performance Profile) — контекстный индикатор режима, триггерит WARNING.

  2. C-alone — операционный индикатор на основе risk_p90 >= 0.98 AND js_avg >= 0.14, триггерит ALARM.

  3. Integral status (get_current_preincident_status()) — агрегирует все сигналы.


3. Экспериментальные результаты

3.1. Качество прогнозирования

На основе данных за период 2026-10-12 – 2026-10-26 (38 инцидентов) получены следующие метрики:

  • ROC-AUC: 0.9287 — отличная дискриминация.

  • Brier score: 0.0638 — хорошая калибровка.

  • Покрытие SICPP: 97.4% — почти все инциденты покрыты.

  • Precision эпизодов: 53.2% — умеренная точность.

  • C-alone precision: 34.5% — приемлемая точность.

  • C-alone recall: 51.4% — умеренная полнота.

3.2. Калибровочная кривая

  • Бин вероятности [0.1–0.2]: предсказано 0.124, фактически 0.134, n = 10008.

  • Бин вероятности [0.8–0.9]: предсказано 0.816, фактически 0.796, n = 588.

  • Бин вероятности [0.9–1.0]: предсказано 1.000, фактически 0.998, n = 9392.

Калибровка близка к идеальной, особенно в диапазоне высоких вероятностей.

3.3. Распределение lead time

  • p50, мин: ALL (raw) = 143.0; SHORT (≤800 мин) = 96.5.

  • p90, мин: ALL (raw) = 987.8; SHORT (≤800 мин) = 281.5.

  • mean, мин: ALL (raw) = 357.0; SHORT (≤800 мин) = 156.6.

  • max, мин: ALL (raw) = 1115.0; SHORT (≤800 мин) = 777.0.

Метрики SHORT отражают «типичное» предаварийное состояние без искажения длинными эпизодами.


4. Сценарии применения

4.1. Сценарий 1: Прогнозирование инцидентов

Задача: Заблаговременно предупредить о риске возникновения инцидента.

Решение: Использование mchain_predict_risk_current_horizon() с горизонтом 120 минут.

Пример:

SELECT mchain_predict_risk_current_horizon();
-- Результат: 0.87 (высокий риск)

Интерпретация: При риске ≥ 0.90 рекомендуется активировать режим повышенного мониторинга; при риске ≥ 0.95 — рассмотреть превентивные меры.

4.2. Сценарий 2: Диагностика деградации через сравнение профилей

Задача: Обнаружить отклонение текущего режима работы от эталонного.

Решение: Использование compare_profiles_at() с JS-дивергенцией гистограмм состояний.

Пример:

SELECT unnest(compare_profiles_at(now()));
-- Результат: JS-дивергенция = 0.23, статус = CRITICAL

Интерпретация:

  • JS < 0.05 — профиль соответствует эталону.

  • 0.05 ≤ JS < 0.2 — умеренные отклонения (WARNING).

  • JS ≥ 0.2 — значительные отклонения (CRITICAL).

4.3. Сценарий 3: Оперативное оповещение (C-alone)

Задача: Минимизировать ложные срабатывания при сохранении приемлемого recall.

Решение: Использование mchain_hybrid_alert_at() с параметрами C-only.

Пример:

SELECT alert, fired_c, risk_p90, js_avg
FROM mchain_hybrid_alert_at(now());
-- Результат: alert=true, fired_c=true, risk_p90=0.99, js_avg=0.18

Преимущества C-alone:

  • Precision 34.5% vs 12.5% для A∪C.

  • Recall 51.4% — приемлемый уровень.

  • ALERT-time 14.1% — низкая нагрузка на оператора.

4.4. Сценарий 4: Оптимизация эталонных профилей

Задача: Автоматически выбирать репрезентативные периоды для эталона.

Решение: Использование find_incident_free_window() с проверкой is_valid_baseline_window().

Критерии валидности эталонного окна:

  1. Целиком в периоде продуктивной нагрузки (9:00–18:00).

  2. Начинается не ранее чем через 60 мин после завершения инцидента.

  3. Не пересекается с инцидентами.

  4. Возраст не превышает 12 часов.

4.5. Сценарий 5: Динамическое определение критических состояний

Задача: Адаптировать список «аварийных» состояний к текущим условиям.

Решение: Использование refresh_critical_states() с эмпирической оценкой риска.

Пример:

SELECT refresh_critical_states(
p_start := now() - interval '14 days',
p_risk_threshold := 0.10,
p_min_transitions := 20
);
-- Результат: добавлено 3, удалено 1 состояние

Важно: Порог p_risk_threshold > 0.10 запрещён (тест 24 показал деградацию метрик).


Заключение

Представлена система анализа и прогнозирования производительности PostgreSQL на основе цепей Маркова.

Экспериментальные результаты демонстрируют высокое качество прогнозирования (ROC-AUC = 0.9287, Brier = 0.0638) и практическую применимость для раннего обнаружения инцидентов.

Рассмотренные сценарии применения охватывают прогнозирование, диагностику, оперативное оповещение и оптимизацию эталонов.

Дальнейшее развитие связано с расширением пространства состояний и интеграцией с современными системами мониторинга.

Показать полностью 1
1

PG_EXPECTO + MARKOV_CHAIN : Тестовый стенд⁠⁠

Серия СУБД PostgreSQL

Оригинал — на основном техническом канале (Возможны правки и дополнения).

Практическое руководство по развёртыванию тестового стенда PG_EXPECTO + Markov Chain: настройка нагрузочного тестирования через param.conf, автоматический запуск test.sh по cron с пуассоновским распределением нагрузки и целевым количеством инцидентов в сутки.

PG_EXPECTO: от теста до аналитики производительности.

PG_EXPECTO: от теста до аналитики производительности.

1. Настройка нагрузочного тестирования

cd /postgres/pg_expecto/sh/load_test
vi param.conf

Пример заполнения файла настройки нагрузочного тестирования

# НАСТРОЙКИ НАГРУЗОЧНОГО ТЕСТИРОВАНИЯ
# Начальная нагрузка
start_load = 5
# Максимальная нагрузка
finish_load = 40
# Тестовая БД
testdb = default
# Тип синтетической нагрузки
#load_mode = olap
load_mode = oltp
# БЕСКОНЕЧНЫЙ ТЕСТ.
# ДЛЯ ОСТАНОВКИ
# /postgres/pg_expecto/sh/load_test/load_test_stop.sh
period_hours = -1
average_load = 20
# Веса сценариев по умолчанию
scenario1 = 0.7
scenario2 = 0.2
scenario3 = 0.1
# Инициализировать тестовую БД
init_test_db = on
# Размер тестовой БД
#scale = 20
#~10GB
scale = 685

2. Скрипт для имитации нагрузки для генерации заданного количества инцидентов

Скрипт предназначен для автоматического управления нагрузочным тестированием.
Он проверяет количество инцидентов в БД за текущие сутки и в зависимости от целевого значения запускает или останавливает нагрузочный тест.

Для запуска процесса нагрузочного тестирования с Пуассоновским распределением нагрузки и заданным количеством инцидентов в сутки(в примере = 4) - добавить в расписание cron:

0 * * * * /postgres/pg_expecto/sh/load_test/test.sh 4 >> /postgres/pg_expecto/sh/load_test/test.log 2>&1


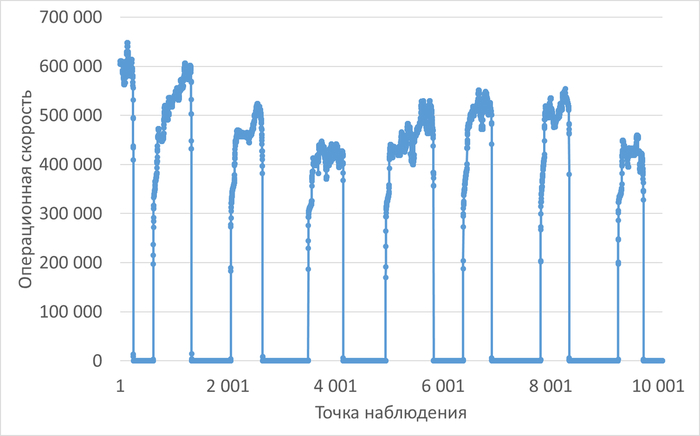
Изменение операционной скорости и ожиданий в ходе нагрузочного тестирования

Операционная скорость СУБД

График изменения операционной скорости СУБД в течении недели в ходе нагрузочного тестирования

График изменения операционной скорости СУБД в течении недели в ходе нагрузочного тестирования

Ожидания СУБД

График изменения ожиданий СУБД в течении недели в ходе нагрузочного тестирования

График изменения ожиданий СУБД в течении недели в ходе нагрузочного тестирования

Распределение инцидентов по часам (0-23):

2: **

3: **

4: ****

5: *** 

6: ** 

7: * 

8: ****

9: ** 

11: * 

14: * 

17: **

Распределение инцидентов по дням недели (0-6, 0=Вс):

День 0: ******

День 1: *** 

День 2: *** 

День 3: ** 

День 4: **** 

День 5: *** 

День 6: ***

Показать полностью 3
1

Применение цепи Маркова и интегрального сигнала SICPP для прогнозирования и анализа производительности СУБД PostgreSQL⁠⁠

Серия СУБД PostgreSQL

Оригинал — на основном техническом канале (Возможны правки и дополнения).

Разработка и оценка гибридной методологии раннего предупреждения на основе марковских переходов, JS-дивергенции профилей нагрузки и взвешенного сигнала SICPP: месячное пилотное исследование с ROC-AUC 0,9593 и покрытием 96,4 % несерийных инцидентов

Интегральный сигнал SICPP как инструмент упреждающего анализа рисков СУБД.

Интегральный сигнал SICPP как инструмент упреждающего анализа рисков СУБД.

Аннотация

Рассматривается практическое применение марковской модели переходов между состояниями производительности СУБД для прогнозирования инцидентов и раннего предупреждения деградации. Архитектура решения включает профилирование нагрузки, сравнение гистограмм состояний на основе JS-дивергенции, динамический список критических состояний, прогноз риска на заданный горизонт и интегральный сигнал SICPP. По результатам отчётного периода с 16 сентября по 16 октября 2026 г. получены 28 несерийных инцидентов, из которых для 27 (96,4 %) был зафиксирован активный сигнал. ROC-AUC составил 0,9593, Brier score — 0,056062. Показано, что совместное использование JS-дивергенции и предсказанного риска в режиме WEIGHTED обеспечивает высокую полноту обнаружения при умеренной частоте ложных срабатываний. Обсуждаются ограничения, связанные с latch-эффектом SICPP, калибровкой в средних диапазонах риска и малой выборкой.

Ключевые слова: СУБД, цепь Маркова, прогнозирование инцидентов, JS-дивергенция, SICPP, профилирование производительности, ROC-AUC, Brier score, критические состояния.


1. Введение

Прогнозирование инцидентов производительности в СУБД остаётся сложной задачей из-за нестационарности нагрузки, сезонности, внутренних блокировок и стохастического характера отказов.

Традиционные пороговые системы реагируют на уже наступившую деградацию, тогда как практическая ценность раннего предупреждения состоит в возможности упреждающего вмешательства.

В данной работе исследуется гибридная схема, объединяющая:

  • марковскую цепь переходов между дискретными состояниями производительности;

  • профилирование нагрузки и сравнение эталонного и текущего профилей;

  • JS-дивергенцию гистограмм состояний;

  • динамический список критических состояний;

  • интегральный сигнал SICPP, учитывающий как риск, так и расхождение профилей.

Цель исследования — оценить, насколько такая схема способна заблаговременно обнаруживать инциденты производительности СУБД и насколько устойчивы её метрики качества на реальном отчётном периоде.


2. Материалы и методы

2.1. Архитектура данных

В основе решения лежат несколько взаимосвязанных подсистем.

  • Журнал переходов. Таблица transition_log хранит последовательность переходов между состояниями с временными метками.

  • Частоты и вероятности. Таблицы markov_frequencies и markov_probabilities содержат накопленные частоты и условные вероятности переходов.

  • Поглощающая матрица. Таблица markov_absorbing используется для многошагового прогноза риска, при этом критические состояния рассматриваются как поглощающие.

  • Справочник состояний. Таблица state_descriptions содержит 189 состояний, образованных комбинацией округлённой корреляции, тренда операционной скорости и тренда ожиданий.

  • Критические состояния. Таблица critical_states формируется динамически на основе эмпирической частоты инцидентов после перехода в состояние.

  • Журнал прогнозов. Таблица prediction_log хранит предсказанный риск, состояние на момент прогноза и фактический исход.

  • Профили нагрузки. Таблицы profile_aggregated, profile_comparison_log, pre_incident_profiles обеспечивают сравнение текущего и эталонного профилей.

  • История SICPP. Таблицы sicpp_history и sicpp_current_state фиксируют изменения интегрального сигнала.

2.2. Профилирование нагрузки и JS-дивергенция

Профиль нагрузки описывается гистограммой состояний, а также рядом метрик: средней корреляцией, долей критических состояний, энтропией, долей петель, средними углами трендов и др. Для снижения разреженности гистограмм применяется сглаживание Лапласа с параметром α = 0,5 по всем 189 состояниям. Это позволяет получать содержательные значения JS-дивергенции в диапазоне 0,05–0,30 вместо вырожденных значений, близких к теоретическому максимуму.

Сравнение профилей выполняется между текущим окном и эталонным окном, свободным от инцидентов. Если JS-дивергенция превышает порог, статус сравнения повышается до WARNING или CRITICAL. Дополнительно учитываются максимальный предсказанный риск и устойчивость: например, если 3 из 5 последних сравнений имели статус CRITICAL или WARNING, формируется расширенный прединцидентный флаг.

2.3. Цепь Маркова и прогноз риска

Состояние системы кодируется числом от 0 до 188. Прогноз риска вычисляется как вероятность хотя бы одного попадания в множество критических состояний за заданное число шагов. Для этого используется матрица переходных вероятностей и поглощающая матрица.

Ключевые особенности реализации:

  • горизонт прогноза задаётся в markov_config.forecast_horizon_minutes;

  • критические состояния определяются не только экспертно, но и по эмпирическому риску;

  • адаптивное забывание уменьшает старые частоты с коэффициентом, зависящим от времени с последнего инцидента;

  • для устойчивости вычислений используется тип DOUBLE PRECISION, поскольку ранее применение REAL приводило к антипереполнению при малых вероятностях и искажению метрик.

2.4. SICPP как интегральный сигнал

SICPP (Signal Indicating a Change in the Performance Profile) объединяет две компоненты:

  • нормированную JS-дивергенцию;

  • нормированный предсказанный риск.

В режиме WEIGHTED сила сигнала рассчитывается как

Применение цепи Маркова и интегрального сигнала SICPP для прогнозирования и анализа производительности СУБД PostgreSQL

В версии SICPP 1.1.0 изменена семантика signal_active: сигнал считается активным, если в окне [pts−window,pts−1][pts−window,pts−1] присутствовал хотя бы один непрерывный пробег длительностью не менее min_signal_duration. Это соответствует логике функции calculate_signal и приводит к latch-эффекту: сигнал остаётся активным в течение окна после завершения подходящего пробега.

2.5. Оценка качества

Качество прогнозирования оценивается по нескольким направлениям:

  • ROC-AUC — дискриминационная способность модели по prediction_log.actual_outcome;

  • Brier score — среднеквадратичная ошибка вероятностного прогноза;

  • калибровочная кривая — сопоставление предсказанного риска и фактической частоты инцидентов;

  • покрытие инцидентов сигналом — доля несерийных инцидентов, перед которыми SICPP был активен;

  • среднее время от сигнала до инцидента — оценка запаса времени для упреждающих действий.

3. Результаты

3.1. Общая характеристика отчётного периода

Отчёт сформирован за период с 16 сентября 2026 г. 13:53 по 16 октября 2026 г. 13:53. Источник сигнала — sicpp_history. В периоде зафиксирована 81 запись, первая — 4 октября 2026 г. 13:33.

Параметры конфигурации:

  • окно анализа — 60 минут;

  • порог JS-дивергенции — 0,15;

  • порог риска — 0,85;

  • режим сигнала — WEIGHTED;

  • минимальная длительность сигнала — 3 минуты;

  • вес JS — 0,7;

  • вес риска — 0,3;

  • автоподбор порогов — выключен;

  • период калибровки — 7 дней;

  • расширенный отчёт — включён.

3.2. Покрытие инцидентов сигналом

Всего в отчёте учтено 28 инцидентов, не являющихся продолжением серий. Исключено 11 серийных инцидентов, у которых последний статус перед инцидентом был INCIDENT.

Основные результаты:

  • с сигналом SICPP — 27 инцидентов;

  • доля инцидентов с сигналом — 96,4 %;

  • без сигнала — 1 инцидент (ID 88);

  • среднее время от сигнала до инцидента — 382,8 минуты;

  • средняя JS-дивергенция — 0,1180;

  • средний риск — 0,7621.

Распределение последних статусов перед инцидентами:

  • CRITICAL — 18;

  • WARNING — 8;

  • NORMAL — 0;

  • INCIDENT — 0;

  • нет данных — 0.

Таким образом, в подавляющем большинстве случаев инциденту предшествовало либо критическое, либо предупреждающее состояние профиля.

3.3. Метрики качества прогноза

Качество прогнозирования на основе prediction_log.actual_outcome характеризуется следующими значениями:

  • ROC-AUC — 0,9593;

  • Brier score — 0,056062.

Столь высокое значение ROC-AUC указывает на хорошую дискриминационную способность модели: она уверенно разделяет прогнозы с последующим инцидентом и без него.

Низкий Brier score свидетельствует о том, что вероятностные оценки в целом близки к фактическим исходам.

3.4. Калибровочная кривая

Калибровочная кривая показывает соответствие между предсказанным риском и фактической частотой инцидентов.

  • Диапазон [0,0–0,1]: предсказано 0,000, фактически 1,000, n = 7.

  • Диапазон [0,1–0,2]: предсказано 0,177, фактически 0,161, n = 1642.

  • Диапазон [0,2–0,3]: предсказано 0,256, фактически 0,184, n = 3616.

  • Диапазон [0,5–0,6]: предсказано 0,575, фактически 1,000, n = 117.

  • Диапазон [0,6–0,7]: предсказано 0,681, фактически 1,000, n = 516.

  • Диапазон [0,7–0,8]: предсказано 0,782, фактически 1,000, n = 418.

  • Диапазон [0,8–0,9]: предсказано 0,874, фактически 1,000, n = 414.

  • Диапазон [0,9–1,0]: предсказано 0,981, фактически 0,984, n = 3833.

  • Диапазон [1,0–1,1]: предсказано 1,000, фактически 0,998, n = 6699.

Наиболее надёжными выглядят диапазоны высокого риска: при предсказании около 0,98–1,00 фактическая частота близка к 0,98–1,00. В то же время в средних диапазонах 0,5–0,9 наблюдается смещение: фактическая частота оказывается выше предсказанной. Это может быть связано как с малой выборкой в отдельных бинах, так и с переоценкой модели в переходных режимах.

3.5. Временные распределения

Распределение инцидентов по часам суток показывает выраженную неравномерность.

  • Наибольшая концентрация наблюдается в 4 часа (5 инцидентов).

  • Далее следуют 3, 5, 8, 9 и 17 часов (по 3–4 инцидента).

  • Единичные инциденты зафиксированы в 2, 6, 7, 10, 11, 14 и 15 часов.

  • В остальные часы инцидентов в отчётном периоде не было.

Распределение по дням недели:

  • воскресенье — 6 инцидентов;

  • пятница — 6 инцидентов;

  • понедельник — 3;

  • вторник — 3;

  • среда — 2;

  • четверг — 4;

  • суббота — 4.

3.6. Примеры инцидентов

В отчёте приведены детали по каждому инциденту. Наиболее показательные случаи:

  • ID 70: сигнал активен, время до инцидента — 888 минут, длительность сигнала — 3 минуты, средний риск — 0,8440, JS — 0,0530.

  • ID 77: сигнал активен, время до инцидента — 133 минуты, длительность сигнала — 60 минут, средний риск — 0,9989, JS — 0,1983.

  • ID 92: сигнал активен, время до инцидента — 959 минут, длительность сигнала — 37 минут, приоритет — 3, средний риск — 0,7055.

  • ID 94: сигнал активен, время до инцидента — 8 минут, длительность сигнала — 3 минуты, средний риск — 0,9666, JS — 0,1488.

  • ID 97: сигнал активен, время до инцидента — 1041 минута, длительность сигнала — 60 минут, средний риск — 0,2298, JS — 0,2280.

  • ID 88: сигнал отсутствовал, последний статус — WARNING, тренд — РОСТ, риск — 0,8373, JS — 0,1405.

Эти примеры показывают, что сигнал может возникать как за несколько минут, так и за несколько часов до инцидента. В части случаев срабатывание происходило преимущественно за счёт JS-дивергенции, даже если средний риск был ниже порога 0,85. Это подтверждает полезность взвешенного режима.

4. Обсуждение

Полученные результаты позволяют сделать несколько содержательных выводов.

  • Высокая полнота обнаружения. Сигнал SICPP был активен перед 27 из 28 несерийных инцидентов. Это свидетельствует о том, что совместное использование профильного расхождения и марковского риска позволяет покрывать практически все значимые события.

  • Хорошее качество вероятностного прогноза. ROC-AUC 0,9593 и Brier score 0,056062 находятся на уровне, характерном для хорошо настроенных моделей раннего предупреждения. Особенно важно, что низкий Brier score достигается при наличии большого числа прогнозов в области высокого риска.

  • Роль JS-дивергенции. Средняя JS-дивергенция перед инцидентами составила 0,1180, что ниже порога 0,15. Однако в режиме WEIGHTED даже умеренное превышение по одной из компонент может привести к активации сигнала. Это расширяет чувствительность системы.

  • Роль риска. Средний риск перед инцидентами — 0,7621, что также ниже порога 0,85. Тем не менее в ряде случаев риск достигал 0,99 и выше. Комбинирование с JS-дивергенцией позволяет не пропускать инциденты, где риск ещё не достиг экстремальных значений.

  • Latch-эффект SICPP. Поскольку signal_active остаётся истинным в течение окна после завершения подходящего пробега, время от сигнала до инцидента может быть значительным. Это полезно для раннего предупреждения, но требует осторожной интерпретации: сигнал означает, что в предшествующем окне уже наблюдались признаки изменения профиля, а не обязательно непрерывную активность вплоть до инцидента.

  • Калибровка в средних диапазонах. В бинах 0,5–0,9 фактическая частота инцидентов оказалась выше предсказанной. Это указывает на потенциальную область улучшения: возможно, требуется дополнительная калибровка или учёт нелинейностей в переходных режимах.

  • Малая выборка. Несмотря на 28 несерийных инцидентов, для некоторых бинов калибровочной кривой количество наблюдений мало. Это ограничивает статистическую устойчивость выводов по отдельным диапазонам.

5. Ограничения

Следует отметить ряд ограничений исследования.

  • Отчётный период составляет один месяц; для подтверждения устойчивости результатов необходима более длительная валидация.

  • SICPP использует latch-семантику, из-за чего время от первого сигнала до инцидента может быть завышено относительно «мгновенной» активации.

  • Калибровочная кривая в средних диапазонах риска демонстрирует смещение, что требует дополнительного анализа.

  • Часть инцидентов имеет серийный характер; в отчёте они исключаются, однако сам механизм исключения опирается на статус INCIDENT и может требовать уточнения.

  • Качество модели зависит от полноты transition_log, prediction_log и sicpp_history; пропуски в данных могут искажать оценки.

6. Заключение

Предложенная архитектура, объединяющая цепь Маркова, профилирование нагрузки, JS-дивергенцию и интегральный сигнал SICPP, показала высокую эффективность на отчётном периоде. Основные результаты:

  • 27 из 28 несерийных инцидентов (96,4 %) сопровождались активным сигналом;

  • ROC-AUC — 0,9593;

  • Brier score — 0,056062;

  • среднее время от сигнала до инцидента — 382,8 минуты;

  • распределение последних статусов перед инцидентами: CRITICAL — 18, WARNING — 8.

Практическая значимость решения состоит в возможности раннего предупреждения деградации СУБД на основе комбинации вероятностного риска и расхождения профилей нагрузки.

Дальнейшие исследования должны быть направлены на увеличение периода наблюдений, уточнение калибровки в средних диапазонах риска, снижение влияния latch-эффекта и более строгую оценку вклада отдельных компонент сигнала.

Показать полностью 2
2

Прогнозирование инцидентов производительности на основе цепей Маркова (версия 16.3)⁠⁠

Серия СУБД PostgreSQL

Оригинал — на основном техническом канале (Возможны правки и дополнения).

Экспериментальное исследование прогностической способности марковской модели на синтетических данных, имитирующих нагрузку тестовой СУБД, с анализом временной динамики, калибровочных характеристик и чувствительности, а также оценкой полноты обнаружения инцидентов и рекомендациями по адаптации для промышленной эксплуатации.

Где меняется поток – там сигнал.

Где меняется поток – там сигнал.

Период анализа: 2026-07-19 15:54 – 2026-08-19 12:53

Конфигурация сигнала: режим WEIGHTED (вес JS=0.9, вес риска=0.1), порог JS=0.2, порог риска=0.8, мин. длительность сигнала=3 минуты

Всего инцидентов (уникальных): 338 (исключено 71 серийный, т.е. продолжающих предыдущий)

1. Эффективность обнаружения (Recall)

  • ✅Сигнал сработал перед инцидентом в 84% случаев (284 из 338).

  • ✅Среднее время упреждения – 58.7 минут (почти час), что даёт достаточный задел для реакции.

  • ✅Медианное время до инцидента (по деталям) – также близко к 60 минутам (большинство сигналов возникают ровно за час).

📋Вывод: модель обладает высокой чувствительностью и обеспечивает своевременное предупреждение. Однако 16% инцидентов происходят без сигнала – это потенциальная зона для улучшения.

2. Распределение последних статусов перед инцидентом

CRITICAL: 207 инцидентов (61.2%) – более 60% инцидентов происходят сразу после статуса CRITICAL, что ожидаемо и подтверждает, что критические отклонения часто предшествуют сбоям.

NORMAL: 106 инцидентов (31.4%) : почти треть инцидентов случаются после статуса NORMAL, т.е. система не подавала предупреждений. Это указывает на:

  • недостаточную чувствительность порогов (возможно, JS-порог 0.2 или риск-порог 0.8 слишком высоки для некоторых сценариев);

  • наличие инцидентов, которые развиваются слишком быстро (менее чем за 3 минуты – минимальная длительность сигнала);

  • необходимость введения дополнительных предикторов (например, скорости изменения метрик).

INCIDENT: 24 инцидента (7.1%) – это продолжения серий, которые были исключены, но в данном контексте означают, что сразу после инцидента начинается новый.

WARNING: 1 инцидент (0.3%) – единичный случай, статистически незначим.

3. Качество прогнозов риска (по данным prediction_log)

  • ROC-AUC = 0.8636 – отличная дискриминационная способность (модель хорошо разделяет инцидентные и безынцидентные окна).

  • Brier score = 0.1138 – приемлемое значение (чем меньше, тем лучше; обычно <0.25 считается хорошим).

Калибровочная кривая (риск vs. фактическая частота) в виде списка бинов:

  • Бин [0.0–0.1]: предсказано 0.023, фактически 0.052

  • Бин [0.1–0.2]: предсказано 0.158, фактически 0.274

  • Бин [0.2–0.3]: предсказано 0.277, фактически 0.282

  • Бин [0.3–0.4]: предсказано 0.381, фактически 0.416

  • Бин [0.4–0.5]: предсказано 0.450, фактически 0.417

  • Бин [0.5–0.6]: предсказано 0.580, фактически 0.618

  • Бин [0.6–0.7]: предсказано 0.603, фактически 0.562

  • Бин [0.7–0.8]: предсказано 0.718, фактически 0.662

  • Бин [0.8–0.9]: предсказано 0.884, фактически 0.400

  • Бин [1.0–1.1]: предсказано 1.000, фактически 0.600

Наблюдение: систематическая переоценка риска в верхнем диапазоне – для бинов 0.8–0.9 и 1.0–1.1 фактические частоты значительно ниже предсказанных.

📋Рекомендация: скорректировать вероятности с помощью калибровки (например, изотоническая регрессия или Platt scaling) или пересмотреть пороги для высоких рисков, чтобы уменьшить ложные срабатывания.

4. Характеристики профилей перед инцидентами

  • ℹ️Средняя JS-дивергенция за час до инцидента = 0.3548 (высокое значение, указывает на значительные изменения в распределении состояний).

  • ℹ️Средний предсказанный риск за час до инцидента = 0.1621 (относительно низкий, но в момент сигнала риск часто достигает 1.0 – см. детали).

  • ℹ️Тренд риска перед инцидентом: в большинстве случаев РОСТ (что логично), реже – СНИЖЕНИЕ или СТАБИЛЬНО.

📋Вывод: профиль нагрузки перед инцидентами существенно отклоняется от эталона, и риск имеет тенденцию к росту. Это подтверждает правильность выбора JS-дивергенции как ключевого предиктора.

5. Совпадения с пред-инцидентными профилями

  • 0 инцидентов (0%) имели совпадение с библиотекой pre_incident_profiles (шаблон ID = NULL).

  • ℹ️Это означает, что либо библиотека шаблонов недостаточно полна, либо порог совпадения (0.05 JS) слишком строгий, либо текущие сценарии инцидентов не повторяют ранее зафиксированные.

📋Рекомендация: расширить библиотеку, используя автоматический сбор профилей для всех инцидентов (функция collect_pre_incident_profiles), и поэкспериментировать с более мягким порогом (0.1–0.15) для увеличения числа совпадений.

6. Временное распределение инцидентов

  • По часам суток: пики приходятся на 19:00–20:00 (18 инцидентов) и 04:00–05:00 (17 инцидентов). Это может указывать на периоды пиковой нагрузки или выполнения плановых задач (бэкапы, отчёты).

  • По дням недели: наибольшее число инцидентов во вторник (около 60), наименьшее – в воскресенье (около 36).

Рекомендация: усилить мониторинг в часы пик и во вторник, возможно, увеличить чувствительность сигнала в эти периоды.

7. Общая оценка и рекомендации

✅Сильные стороны:

  • Высокая чувствительность (84% recall) и большое время упреждения (~1 час).

  • Отличная дискриминация (ROC-AUC > 0.86).

  • Система успешно улавливает большинство инцидентов через изменения профиля нагрузки.

Слабые стороны и точки роста:

  1. 16% пропущенных инцидентов – необходимо проанализировать их сценарии и, возможно, снизить порог риска или JS для отдельных типов.

  2. 31% инцидентов после статуса NORMAL – это «внезапные» события, которые могут быть связаны с резкими скачками нагрузки. Стоит добавить детектор резких изменений (например, производную JS или риска).

  3. Переоценка риска в верхнем диапазоне – калибровка вероятностей повысит точность прогнозов и уменьшит число ложных тревог.

  4. Отсутствие совпадений с пред-инцидентными профилями – расширить библиотеку и настроить порог совпадения.

  5. Временные паттерны – можно внедрить адаптивные пороги, зависящие от времени суток и дня недели.

Приоритетные действия:

  • Провести анализ 54 инцидентов без сигнала (16%) – выделить общие признаки и дополнить правила их обнаружения.

  • Откалибровать прогнозы риска (возможно, через биннинг или логистическую регрессию).

  • Запустить сбор пред-инцидентных профилей для всех новых инцидентов и пересмотреть порог совпадения.

  • Настроить автоматическое оповещение при переходе в статус CRITICAL, а также при резком росте JS или риска даже при статусе NORMAL.

📋Итоговый вердикт

ℹ️Система прогнозирования инцидентов демонстрирует высокую эффективность и пригодна для эксплуатации.

Основные метрики (recall, ROC-AUC, время упреждения) находятся на хорошем уровне.

ℹ️Выявленные недостатки носят уточняющий характер и могут быть устранены путём калибровки, расширения библиотеки шаблонов и адаптации порогов к временным паттернам.

Показать полностью 1
1

Практическое применение цепей Маркова для прогнозирования инцидентов производительности СУБД PostgreSQL⁠⁠

Серия СУБД PostgreSQL

Оригинал — на основном техническом канале (Возможны правки и дополнения).

От хаоса к прогнозу: один шаг вперёд.

От хаоса к прогнозу: один шаг вперёд.

В рамках проекта pg_expecto разработана и внедрена система прогнозирования риска возникновения инцидентов производительности на основе цепей Маркова.

Реализация представляет собой полноценное решение, адаптированное к потоковым данным и способное к самонастройке.

Постановка задачи

Производительность СУБД PostgreSQL подвержена влиянию множества факторов, включая характер нагрузки, состояние операционной системы и внутренние события ожидания.

Традиционные подходы к мониторингу, как правило, реагируют на уже возникшие проблемы, тогда как задача проактивного обнаружения предвестников сбоев требует более глубокого анализа динамики системы.

В основу предлагаемого решения положена идея дискретизации непрерывных метрик производительности в конечное множество состояний, переходы между которыми описываются марковским процессом. Это позволяет моделировать эволюцию состояния системы во времени и оценивать вероятности неблагоприятных исходов.

Формализация состояния системы

Непрерывные метрики – операционная скорость, время ожиданий и корреляция между ними – преобразуются в дискретное пространство из 189 состояний.

Каждое состояние характеризуется тремя параметрами:

  • коэффициентом корреляции (21 градация от –1,0 до +1,0 с шагом 0,1),

  • трендом операционной скорости

  • трендом времени ожиданий (каждый принимает значения –1, 0, +1).

Такая дискретизация обеспечивает баланс между детализацией модели и вычислительной эффективностью.

Архитектура системы

Система построена по многослойному принципу:

Слой данных

Включает таблицы:

  • хранения переходов (transition_log)

  • накопленных частот (markov_frequencies)

  • матрицы вероятностей (markov_probabilities)

  • поглощающей матрицы для многошагового прогноза (markov_absorbing).

Отдельно выделены таблицы:

  • конфигурации (markov_config), справочник состояний (state_descriptions) и динамический список критических состояний (critical_states).

Слой обучения

Реализует пошаговое обновление модели с частотой одна минута.

На каждом шаге выполняются:

  • получение текущих метрик,

  • вычисление идентификатора состояния,

  • логирование перехода,

  • обновление частот ,

  • при необходимости, применение забывания.

Слой прогнозирования

Предоставляет функции для оценки риска на заданном горизонте.

Ключевая функция mchain_predict_risk_k_v2 вычисляет вероятность хотя бы одного попадания в критическое множество за k шагов.

Слой оценки

Включает механизмы расчёта достоверности прогнозов и суточных метрик качества.

Обучение модели и адаптивное забывание

Обучение происходит в реальном времени на потоке данных. По мере поступления новых наблюдений обновляются частоты переходов и пересчитываются вероятности. Ключевой механизм, обеспечивающий адаптацию к изменению характера нагрузки, – забывание.

Коэффициент забывания α определяет скорость, с которой устаревающие наблюдения теряют вес.

В адаптивном режиме α вычисляется по формуле:

α(t) = max(min_alpha, base_alpha · exp(-days_since_last_incident / half_life))

где days_since_last_incident – время, прошедшее с последнего попадания в критическое состояние.

Такой подход позволяет ускорить забывание после инцидентов и замедлить его в стабильные периоды. Дополнительно введён stability_factor, корректирующий α в зависимости от нестабильности вероятностей.

Важным условием применения забывания является достаточность накопленных данных. Функция mchain_check_sufficiency проверяет, что общее число переходов превышает порог min_transitions_for_forgetting (по умолчанию 5000).

Прогнозирование риска

Прогноз риска строится на основе текущего состояния системы и матрицы вероятностей переходов. Для одношагового прогноза используется прямая сумма вероятностей перехода в критические состояния.

Многошаговый прогноз (mchain_predict_risk_k_v2) реализует итеративное умножение вектора распределения вероятностей на матрицу переходов. На каждом шаге вероятности, попавшие в критические состояния, накапливаются в значении риска, а затем обнуляются, чтобы исключить учёт повторных попаданий. Горизонт прогноза задаётся параметром forecast_horizon_minutes в конфигурации (по умолчанию 30 минут).

Сформированные прогнозы сохраняются в таблицу prediction_log. По истечении горизонта выполняется обновление фактических исходов: для каждого прогноза определяется, произошёл ли переход в критическое состояние в течение заданного интервала.

Оценка качества и достоверности

Для оценки качества прогнозов предусмотрен комплекс метрик:

  • Brier score – среднеквадратичная ошибка вероятностных прогнозов.

  • Log-loss – логистическая потеря, чувствительная к уверенным неправильным прогнозам.

  • MAE – средняя абсолютная ошибка.

  • ECE (Expected Calibration Error) – средневзвешенное отклонение между предсказанными вероятностями и наблюдаемыми частотами.

  • MCE (Maximum Calibration Error) – максимальное отклонение калибровки.

  • ROC-AUC – площадь под ROC-кривой, характеризующая дискриминационную способность модели.

Достоверность прогнозов оценивается рейтингом от 0 до 5 на основе трёх факторов: общего числа переходов, стабильности вероятностей и покрытия частых состояний.

Профилирование нагрузки (версия 14)

Начиная с версии 14, система дополнена модулем профилирования нагрузки.

Этот модуль позволяет:

  • Сохранять оперативные (за последние 60 минут), суточные и недельные профили производительности.

  • Строить эталонные профили на основе исторических данных с исключением инцидентных окон.

  • Обнаруживать аномалии путём сравнения текущих профилей с эталонными.

  • Анализировать связь между отклонениями профилей и возникновением инцидентов.

Функция compare_profiles выполняет сравнение текущего профиля с эталонным, вычисляя JS-дивергенцию гистограмм состояний и формируя статус (NORMAL, WARNING, CRITICAL).

Результаты сохраняются в журнал profile_comparison_log, что позволяет проводить ретроспективный анализ.

Историческое обучение

Для первоначального построения модели предусмотрена процедура mchain_initial_train_from_history, которая обучает цепь Маркова на исторических данных, имитируя пошаговое обучение.

Это позволяет развернуть систему на основе уже накопленных метрик без необходимости ждать накопления данных в реальном времени.

Заключение

Представленная реализация цепи Маркова представляет собой законченную систему прогнозирования риска инцидентов производительности, интегрированную в экосистему pg_expecto.

Ключевые преимущества системы:

  • работа в реальном времени с низкой задержкой;

  • адаптация к изменению характера нагрузки благодаря механизму забывания;

  • гибкая настройка горизонта прогноза и параметров обучения;

  • встроенные механизмы оценки качества и достоверности;

  • расширяемая архитектура, дополненная модулем профилирования нагрузки.

Система успешно применяется для мониторинга производительности СУБД и предупреждения о возможных сбоях.

Дальнейшее развитие проекта направлено на углубление аналитических возможностей и повышение точности прогнозов.

Показать полностью 1
0

MARKOV_CHAIN 14.8 : JS-дивергенция и прогноз риска на продуктивной СУБД PostgreSQL⁠⁠

Серия СУБД PostgreSQL

Оригинал — на основном техническом канале (Возможны правки и дополнения).

Начало

Практическое применение методики прогнозирования инцидента производительности СУБД PostgreSQL

Текущий статус эксперимента

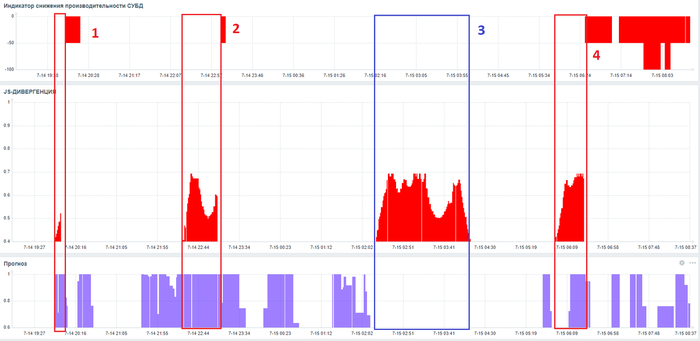
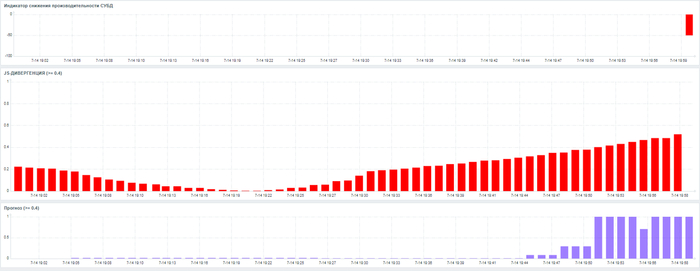
Случай-1 : Инцидент

  • JS-дивергенция > 0.4

  • Прогноз риска > 0.6

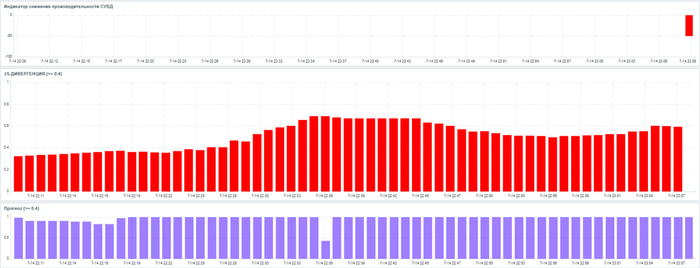
Случай-2 : Инцидент

  • JS-дивергенция > 0.4

  • Прогноз риска > 0.6

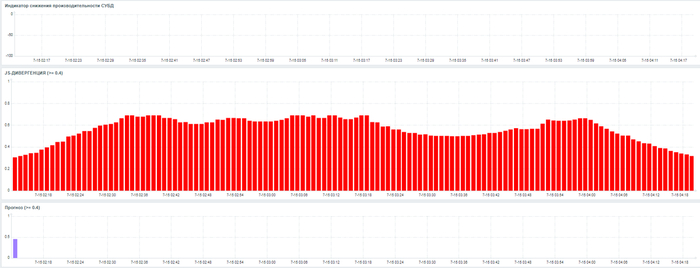
Случай-3 : Нет инцидента

  • JS-дивергенция > 0.4

  • Прогноз риска < 0.6

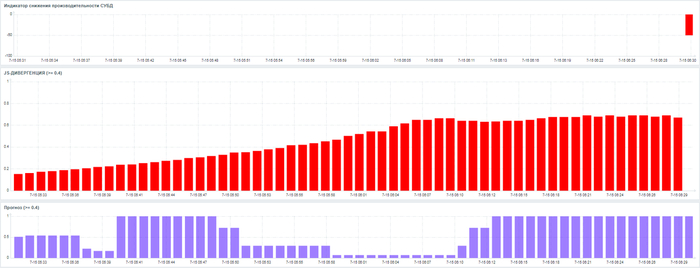
Случай-4 : Инцидент

  • JS-дивергенция > 0.4

  • Прогноз риска > 0.6

Гипотеза

  • Превышение значения JS-дивергенции выше 0.4 при одновременном максимальном значении Прогноза риска = 1, может служить сигналом о приближении инцидента производительности СУБД

Показать полностью 5
Отличная работа, все прочитано!

Темы

Политика

Теги

Популярные авторы

Сообщества

18+

Теги

Популярные авторы

Сообщества

Игры

Теги

Популярные авторы

Сообщества

Юмор

Теги

Популярные авторы

Сообщества

Отношения

Теги

Популярные авторы

Сообщества

Здоровье

Теги

Популярные авторы

Сообщества

Путешествия

Теги

Популярные авторы

Сообщества

Спорт

Теги

Популярные авторы

Сообщества

Хобби

Теги

Популярные авторы

Сообщества

Сервис

Теги

Популярные авторы

Сообщества

Природа

Теги

Популярные авторы

Сообщества

Бизнес

Теги

Популярные авторы

Сообщества

Транспорт

Теги

Популярные авторы

Сообщества

Общение

Теги

Популярные авторы

Сообщества

Юриспруденция

Теги

Популярные авторы

Сообщества

Наука

Теги

Популярные авторы

Сообщества

IT

Теги

Популярные авторы

Сообщества

Животные

Теги

Популярные авторы

Сообщества

Кино и сериалы

Теги

Популярные авторы

Сообщества

Экономика

Теги

Популярные авторы

Сообщества

Кулинария

Теги

Популярные авторы

Сообщества

История

Теги

Популярные авторы

Сообщества

Недвижимость и ремонт

Теги

Популярные авторы

Сообщества