
На сайтах можно будет блокировать ИИ-ботов
Новость про Cloudflare перепостили, перевели и опубликовали все кому не лень, а прокомментировать почему-то никто не взялся. А тема-то важная. И, что интересно, совсем не новая.

Эти разговоры ходили ещё года полтора назад, задолго до нынешнего анонса. Тогда все носились с форматом llms.txt — файлик, которым сайт как бы просил обучающих ботов не лезть. Работал он, мягко говоря, никак. Но сам запрос был виден уже тогда: владельцы сайтов не в восторге от того, что нейронки съедают их контент и потом спокойно раздают его в своих ответах.
Почему это вообще проблема
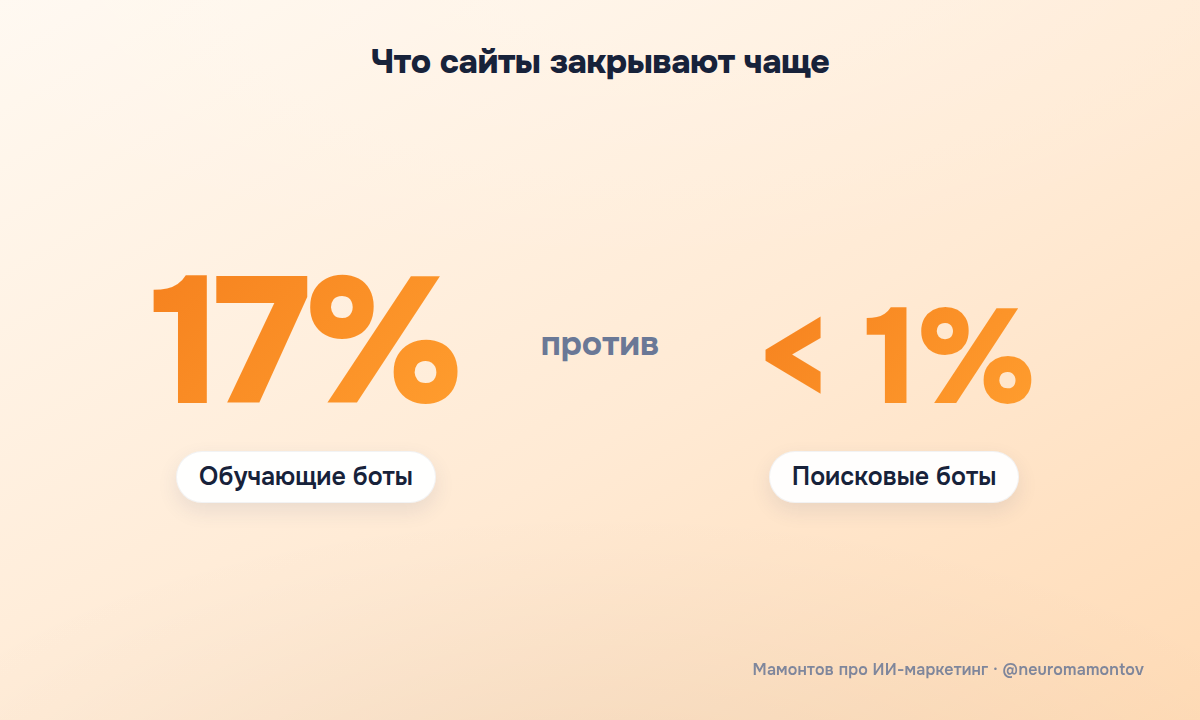
Одно дело — когда тебя проиндексировал поисковый бот и потом где-то процитировал: в обычной выдаче или в ИИ-ответе, но со ссылкой на твой сайт. Это дополнительный трафик. А трафик автору нужен как воздух, потому что вся монетизация живёт на сайте: реклама, подписки, свои продукты, нативка, партнёрские ссылки. Способов куча, но для любого нужен свой трафик на своей площадке. Поэтому поисковых ботов почти никто не блокирует — по оценке самого Cloudflare, меньше 1% сайтов.
Совсем другое дело — когда нейронка сожрала твой материал и вываливает всю фактуру, все выводы прямо у себя в окне. Может, тебя даже упомянет как автора. Но без ссылки. Без перехода. Просто "есть такое мнение". И всё, над чем ты пыжился-мурыжился — писал, собирал по крупицам многолетний опыт, чтобы поделиться с читателями и как-то на этом заработать, — модель отдаёт бесплатно. Задаром.
Вот отсюда и разница в цифрах. Поиск блокирует меньше 1% сайтов, а обучение — уже как минимум 17%. Далеко не все, конечно. Но это люди, которые очень захотели и нашли способ, а способы там неочевидные, на поверхности не лежат. И дальше это будет только расти.

Кто на самом деле тормозил
Самое интересное: проблема все эти годы была не в сайтах, а в тех, кто делает нейросети.
Им-то как раз позарез нужно обучать модели на свежем человеческом тексте. Не будет живого материала — модель начинает тупеть, причём стремительно. И это уже видно невооружённым глазом: интернет заваливает нейроконтентом, и модели всё чаще жуют трижды пересказанные идеи. Змея кусает свой хвост.
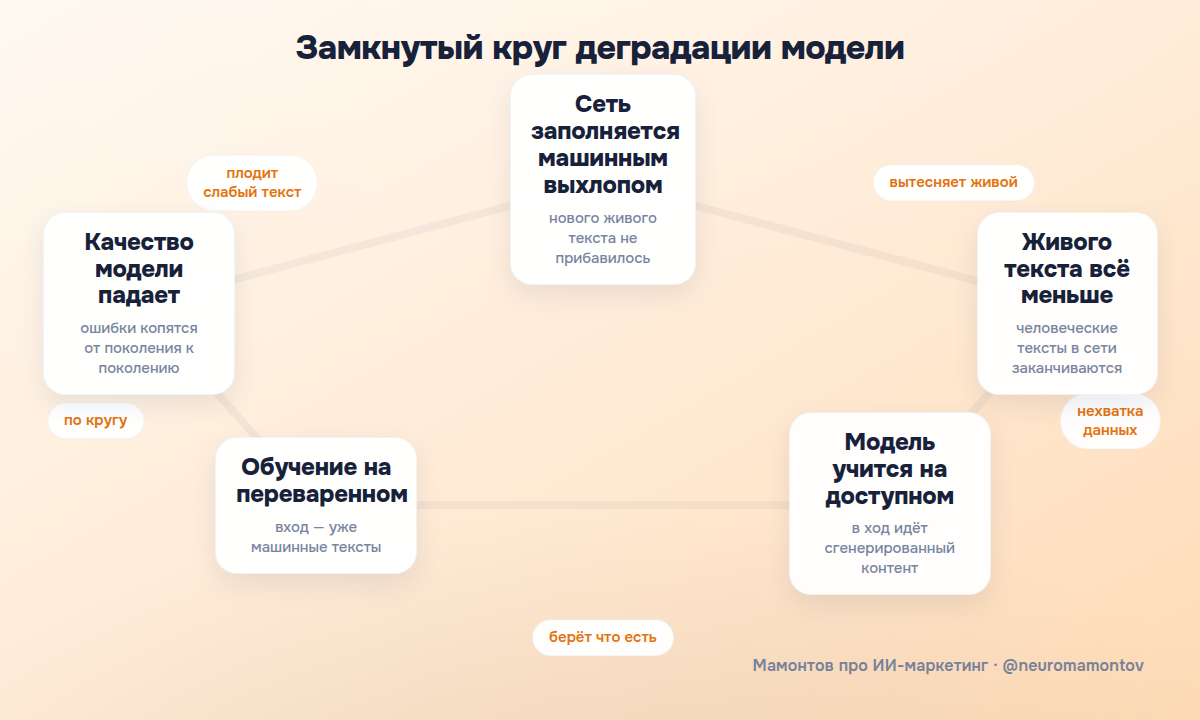
Получается забавный расклад. Одной рукой ИИ-компании хотят всё больше живого человеческого контента — иначе их модели деградируют. А другой рукой те же компании должны придумать, как успокоить владельцев сайтов: пустить поискового бота и не пустить обучающего. Тот самый llms.txt и должен был это разрулить, но не разрулил — половина провайдеров просто забила на его поддержку.

Что сделал Cloudflare
Cloudflare — это, на минуточку, больше 20% сайтов по всему миру. И он заявляет, что договорился с большинством крупных игроков: они теперь честно делят своих ботов на поисковых и обучающих и слушаются директив. Google и Apple под условия уже подходят, Microsoft обещает подтянуться в начале 2027-го. Для владельца сайта это выглядит как один переключатель: поиск оставляем, обучение закрываем.
И вот тут спрятана главная мысль. Cloudflare просто решил закрыть потребность, которая на рынке всё заметнее и будет только расти. Нейровыдача меняет уже не только то, как продвигаются, но и саму манеру, в которой люди ищут, — так что желание "в поиск пускать, а в обучение нет" будет только крепнуть. 17% против 1% — это не про технологию, это про спрос, который был всегда, просто до сих пор было нечем его закрыть.
А теперь ложка дёгтя
Разделить ботов механически сами мы никогда не могли. Один и тот же бот заходит на сайт сразу с двумя задачами — и для поиска, и для обучения. Ни по названию бота, ни по IP их не растащишь. Значит, вся конструкция держится на честном слове операторов. Захотят соблюдать — будут. Не захотят — а кто проверит?

Но даже не это главное. Контент утягивают не только сами модели. Есть тьма парсеров, которые тупо копируют твой текст и бесплатно выкладывают у себя. Я как автор сталкиваюсь с этим постоянно: каждая публикация через день всплывает на трёх, пяти, десяти чужих сайтах. И вот вопрос — будут ли те сайты закрываться от обучающих ботов? Да с чего бы. То есть мой материал модель не возьмёт с моего сайта, зато спокойно возьмёт с чужого.
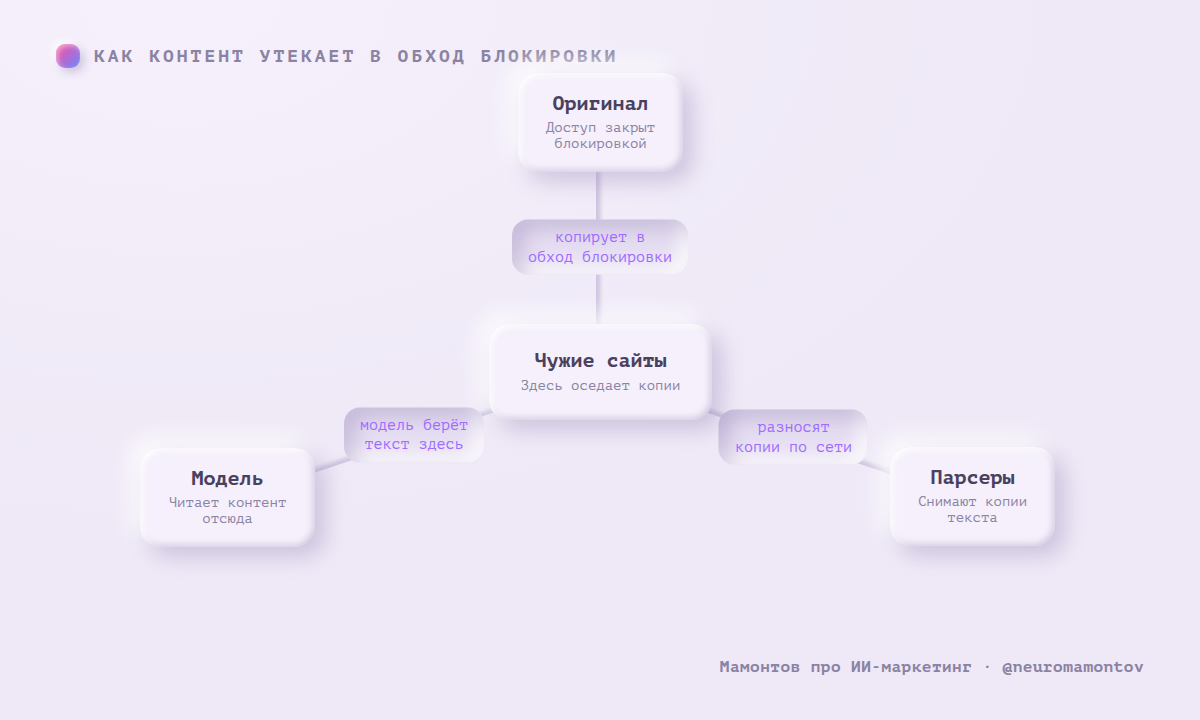
Куда всё катится
При этом сам разворот мне нравится. Недавно ведь была история, что Google начал платить издателям за использование их контента в ответах нейросетей — пока в тестовом режиме, но это по сути тот же разговор — рынок пытается нащупать баланс: без живого человеческого текста модели тупеют, а человеку должно быть выгодно этот текст отдавать.
Нейросети позарез нужен тот, кому есть что сказать. На пустом пересказе пересказа она "задыхается". В сухом остатке ценность остаётся у авторов, способных передавать смысл, опыт и фактуру, а не у контент-мельниц, которые штампуют пустоту.
Три типа ИИ-ботов
Обучающие боты - GPTBot, ClaudeBot, Google-Extended - Можно закрыть — прямой отдачи нет
Поиск / индексация для ИИ-ответов - OAI-SearchBot, PerplexityBot - Оставить открытым — это трафик
Заход по запросу человека - ChatGPT-User, Claude-User - Обязательно открыть — это живой клиент
По типу сайтов
Магазины, услуги, сайты-визитки — не закрывать (максимум убрать обучающих ботов). Трафик важнее контента.
Медиа, базы знаний, авторские тексты, платный контент — закрывать обучение, оставлять поиск.