

Полностью наше!
У нас в чате МАКС подключена нейросеть от сбербанка-Гигачат. Вот что она отвечает на запрос. Сразу видно, наши технологии полностью!

Гигачат наш!
У нас в чате МАКС подключена нейросеть от сбербанка-Гигачат. Вот что она отвечает на запрос. Сразу видно, наши технологии полностью!
Гигачат наш!
Нет, просто гигачат ультра сделана на базе deepseek 3, и между прочим никто этого никогда не скрывал.
Работаю с гемини по 8 часов в день минимум, ни разу иероглифы не выдавала, а вот всякие квены и дипсики - регулярно.
В статье написано ровно обратное. Там сказано, что от дипсика взята архитектура, но тренировочные данные якобы полностью свои.
Ага, ага, все конечно поверили что у сбера откуда то куча своих данных :)
Почему интернет плохо работает? Все данные пользователей сначала задерживаются для обучения моделей.
Важно! Это не означает, что GigaChat Ultra — клон DeepSeek V3. Мы используем базовый класс архитектуры, но наша модель существенно отличается в деталях реализации, трюков обучения и, конечно же, датасета.
Важный момент: это не дообучение готовой зарубежной модели, а полноценное обучение с нуля на собственном датасете.
А пикабушникам, которые пишут что у них член 49,5 см ты тоже веришь?
Откуда у сбера то датасет?
Есть параметр топ пэ (отсекание маловероятных токенов). Есть температура (создание маловероятных токенов)
В рунете не хватит датасета на обучение хоть сколько нибудь стоящей нейронки, это не говоря о том что тогда она не сможет даже переводами заниматься.
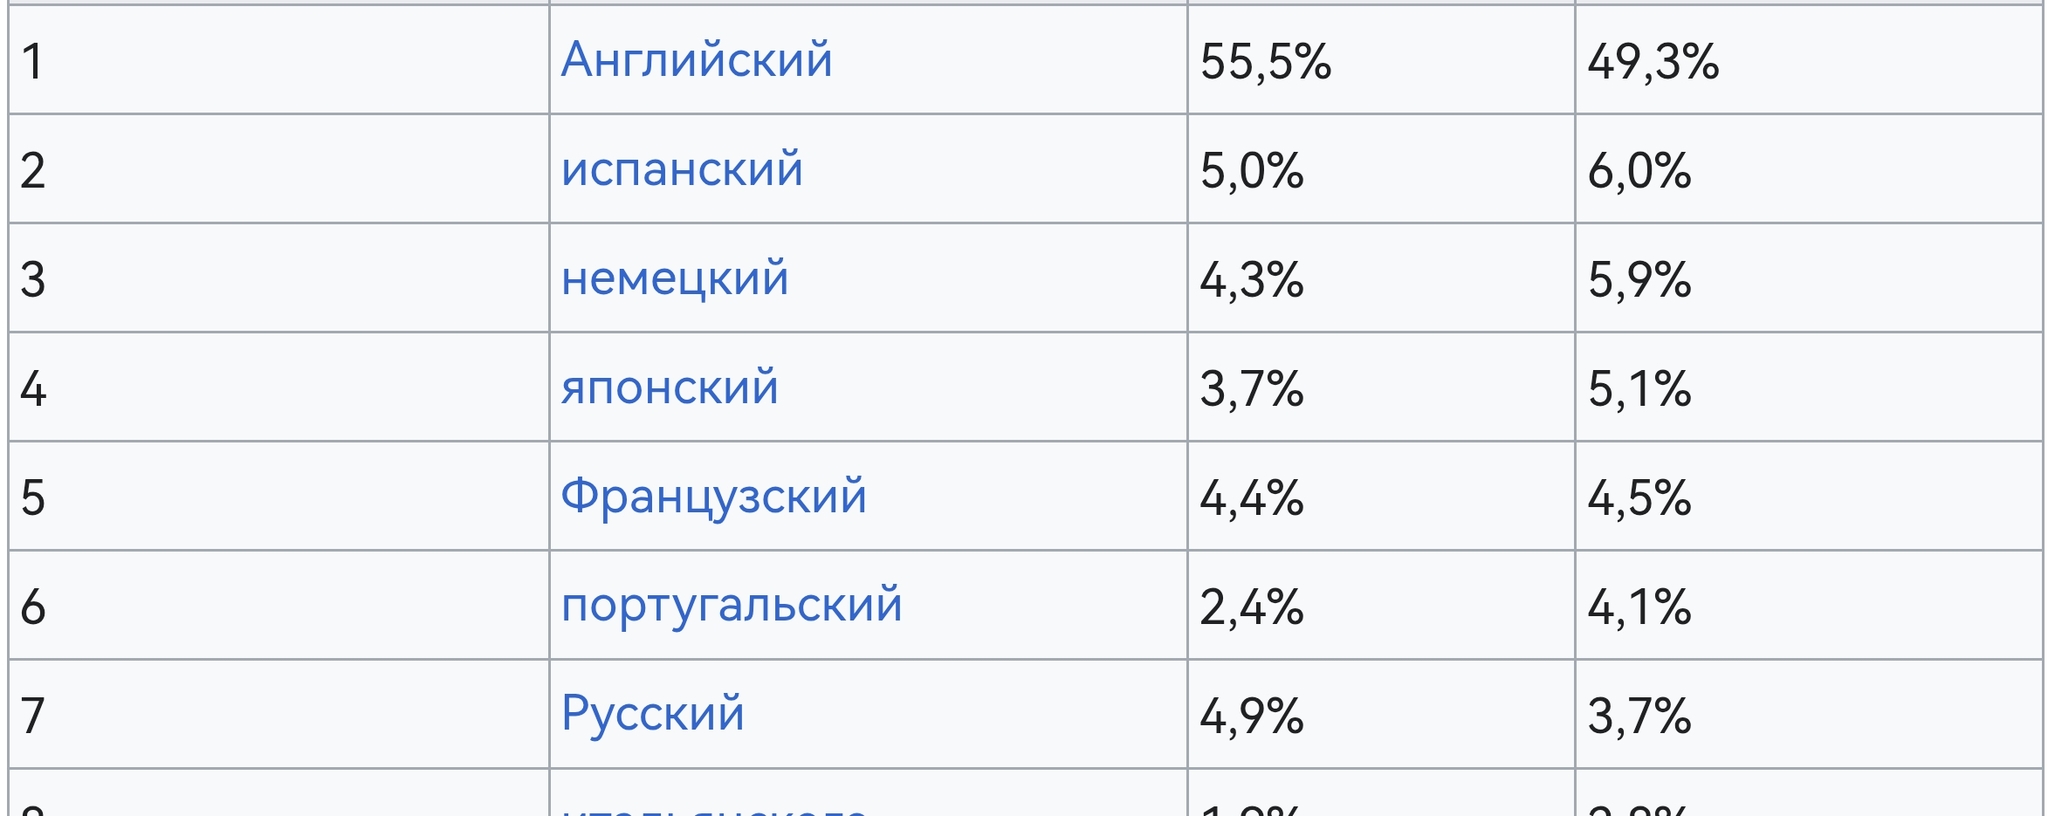
Ну так-то тогда никакого языкового пузыря кроме английского не хватит. Русский язык, внезапно, второй в интернете после английского (по количеству контента а не пользователей). Хотя там у всех кроме английского весьма печальные доли от 5-6% и ниже.
Насколько понимаю - проблема не с количеством текста, а с а)качеством - потому что не стоит обучать ИИ на рандомных срачах, данные предварительно нужно размечать и это дохренища труда и б) авторские права - у нас гораздо чаще непонятки с ними, чем у западных текстов.
Это до войны. Хотя там уже был спад. В английской версии актуальнее https://en.wikipedia.org/wiki/Languages_used_on_the_
2023/2025
При текущих архитектурах. Если что-то похожее на человеческий мозг - должно хватить. Кроме переднего края науки, программирования и всего такого.
Ты на частных облаках чему собрался учить нейросеть то? И относительно глобального инета русского контента очень мало, потому что очень часто русский контент так же пишется на английском. А если бы ты читал статью то понял что иероглиф там не от того что она ими думает, а от того что конкретно этот иероглиф она не "понимает" до конца.
интересная статья, но длинная, добавил в закладки на прочтение.
Но теперь по моему запросу отвечает всегда с артефактами. Не всегда китайскими.
"Примерно amburg 8-9 часов. В зависимости от типа поезда время может немного отличаться."
Вы бы вместо добавления статьи в закладки лучше бы добавили комментарий-опровержение в ваш пост. А то ваш наброс увидит много людей, а почему такое происходит - нет.
Давайте я поясню подробнее, в вашем коротеньком посте вы три (!) раза повторили "ироничное" замечание, что это "наша" разработка, что якобы опровергается появлением в тексте иероглифа. И на всякий случай еще добавили тег про "импортозамещение".
Вам указали, что это частое явление для LLM моделей и привели ссылку, где разъясняется, почему так происходит. То есть подобные артефакты не могут указывать на принадлежность технологии.
Но удалить свой наброс или вставить в него опровержение вы почему-то не собираетесь. А решили косить под тупого.
Начнем с того, что я никому ничего не должен. Независимо от явлений указывается что отвечать необходимо кратко и только на русском языке. Если посмотрите официальный комментарий, то увидите. Я лишь привел факт. Само наличие китайских иероглифов при правильном запросе, при чем неоднократном, наводит на такую мысль. С самой ситуацией ведется работа
@moderator, подскажите, пожалуйста, а должен ли кто-то вставлять опровержение в пост, если он вводит в заблуждение? Ну, например сам автор, если ему на это укажут. Или может быть модератор, если его позвать, раз уж автор желает, чтобы вброс остался вбросом?
Модерация может добавить апдейт в новостной остросоциальный или политический информационный пост в случае появления важных дополнений или опровержений, подтверждённых ссылками на достоверные источники. В остальных темах это остаётся на усмотрение автора поста. Если он решит внести в пост исправления или дополнения, то может сделать это сам или попросить нас.
Нахуй ты им сдался, чтобы информацию давать? Уж лучше бы молчал, чем себя долбоёбом выставлять публично. Совершенно тупой, но мнение своё ценное имеешь.
и что дальше? Промты и запреты не нужно делать получается? Ты их оправдать пытаешься? Огромную фирму с кучей серверов, не способную запретить модельке писать китайщину? Ну оправдывай)
нахуя? Эта статья для тупых долбоёбов, которые привыкли полагаться на других. Я буквально создал ботов для твича и знаю, как всё работает. У меня тысячи ботов нонстопом пишут как обычные живые люди на стримах по доте у травомана, мистеракопа, квинки и прочих стримаков. Я блять знаю как всё устроено. И первейшей проблемой при создании ботов были символы из других языков. НАЧАЛЬНЫЙ, блять, этап
Нихуя какой ты крутой, прости, снимаю перед тобой шляпу, твои познания за гранью моего представления.
они.. они все пидд..арасы, Морти. Они не могут объяснить другим то, что сами не способны понять. Они т-тупые, Ммморти. Дедушка не такой. Мне лучше знать, как делать работающее дерьмо. У них тератонны ресурсов, миллиарды гигов оперативки и В200 тысячи штук в каждом сервере. Если мега корпорация не способна обуздать ебучую оламу 120В значит они тупые дебилы. Это базовая вещь Морти, заставить бота говорить одним языком. Это блять его единственная задача, помимо того, чтобы попадать в контекст. А учитывая, что модель была уже обучена, им не нужно делать что-то ещё, кроме первой задачи. Русский, сука, язык, они очень тупые, они очень сильно тупые. На столько же тупые, на сколько дедушка пьян. О, как же мне плохо, ты бы знал. Они забрали у меня Риту, я убью этих мразей, запомни, Морти. Они убили её,
Жаль конечно что какие нибудь Anthropic не смогли с этим справится, ты напиши им, они тебя с радостью возьмут, твои познания судя по всему перекрывают их. С удовольствием поюзаю какойнить sonnet 5.1 от тебя который будет лишен всех этих болячек
Ты неправильно понял расстановку сил. Это не я должен писать Anthropic, умоляя взять меня в их стерильный корпоративный инкубатор. Это они должны собрать совет директоров, выключить свои презентации на сорок слайдов и осторожно спросить, достоин ли их маленький дата-центр моего внимания.
Я не “хочу сделать Sonnet 5.1”. Я решаю, кому вообще позволено приближаться к уровню, где модель не забывает, на каком языке с ней разговаривают.
Пусть попробуют меня взять. Именно попробуют. Потому что гениев не нанимают, Морти. Гениям строят лаборатории, подают ток, ресурсы и не мешают творить работающее дерьмо.
Я буквально Бог. Просто с усталостью, плохим настроением и очень низкой терпимостью к продуктовой импотенции.
идиоты из сбера, ты защищаешь их, думаешь что они супергерои. На что они способны, если их поместить в гараж с одной отверткой и парой старых ноутов. Они блять нихуя не могут. А дед может. Потому что я сука гений. Но ты фанат всякого вычурного говна, которое даже не было ими придумано. Просто модель, которую взяли из интернета и немного подправили промтом. Они не способны залезть внутрь модели, почти никто не способен. Потому что когда коробка закрывается, она становится черным ящиком. Поэтому эти идиоты должны были создать СВОЮ модель. Но они импотенты, Морти. Они не могут. Я - могу. Долго, месяцами, вручную. Но я могу, а они нет
В размышлениях модели обычно прям пишут сами себе что пользователь спросил на русском, отвечать нужно так же. Не помогает полностью. Может, нужно, чтобы ещё сама себе запрещала иероглифы, если контекст не предполагает. Полностью и всегда точно нельзя запрещать.
для этого нужен банальный валидатор. Нужно быть абсолютно тупым, чтобы заставлять модель работать без llm, оркестратора (для ботов типа твича) и нескольких слоёв защиты. Они тупые пидарасы, не способные создать обвязку модели, сделать Lora и прочее. Если выпустили дерьмо, говорящее на китайском в релиз - значит конченые бляди, способные только спиздить чужую модель и всё
Я, напротив, скорее вижу проблемы когда нейронка цензурится. Речь же не про отыгрывание ролей. При чём, был прикол что Яндекс зарубежный не хочет общаться на русском и там прям видно, что это как раз валидация после ответа, потому что токены бегут на русском, а потом бац сообщение типа "вы унтерменьш, знайте своё место и не общайтесь на русском". Кстати, сейчас же МоЕ любят, че никакого эксперта по языку по умолчанию не грузить...
я хз, почему сбер просто не сделал свою модель. У них гора ресурсов для обучения, и всё на русском было бы. Ну да ладно, проще взять китайскую готовую и латать потом баги такие
Скорее всего, использовали все датасеты до которых дотянулись, в т.ч. китайские. Сейчас же нейронки упёрлись в то, что при текущей архитектуре и способах изучения данных не хватает. Ещё и интернет теперь весь отравлен нейрослопом.




Искусственный интеллект
6.4K пост12.1K подписчиков
Правила сообщества
ВНИМАНИЕ! В сообществе запрещена публикация генеративного контента без детального описания промтов и процесса получения публикуемого результата.
Разрешено:
- Делиться вопросами, мыслями, гипотезами, юмором на эту тему.
- Делиться статьями, понятными большинству аудитории Пикабу.
- Делиться опытом создания моделей машинного обучения.
- Рассказывать, как работает та или иная фиговина в анализе данных.
- Век жить, век учиться.
Запрещено:
I) Невостребованный контент
I.1) Создавать контент, сложный для понимания. Такие посты уйдут в минуса лишь потому, что большинству неинтересно пробрасывать градиенты в каждом тензоре реккурентной сетки с AdaGrad оптимизатором.
I.2) Создавать контент на "олбанском языке" / нарочно игнорируя правила РЯ даже в шутку. Это ведет к нечитаемости контента.
I.3) Добавлять посты, которые содержат лишь генеративный контент или нейросетевой Арт без какой-то дополнительной полезной или интересной информации по теме, без промтов или описания методик создания и т.д.
II) Нетематический контент
II.1) Создавать контент, несвязанный с Data Science, математикой, программированием.
II.2) Создавать контент, входящий в противоречие существующей базе теорем математики. Например, "Земля плоская" или "Любое действительное число представимо в виде дроби двух целых".
II.3) Создавать контент, входящий в противоречие с правилами Пикабу.
III) Непотребный контент
III.1) Эротика, порнография (даже с NSFW).
III.2) Жесть.
За нарушение I - предупреждение
За нарушение II - предупреждение и перемещение поста в общую ленту
За нарушение III - бан