
«Они играют нашими жизнями»: исследователь ушёл из Anthropic с предупреждением о самоулучшающемся ИИ
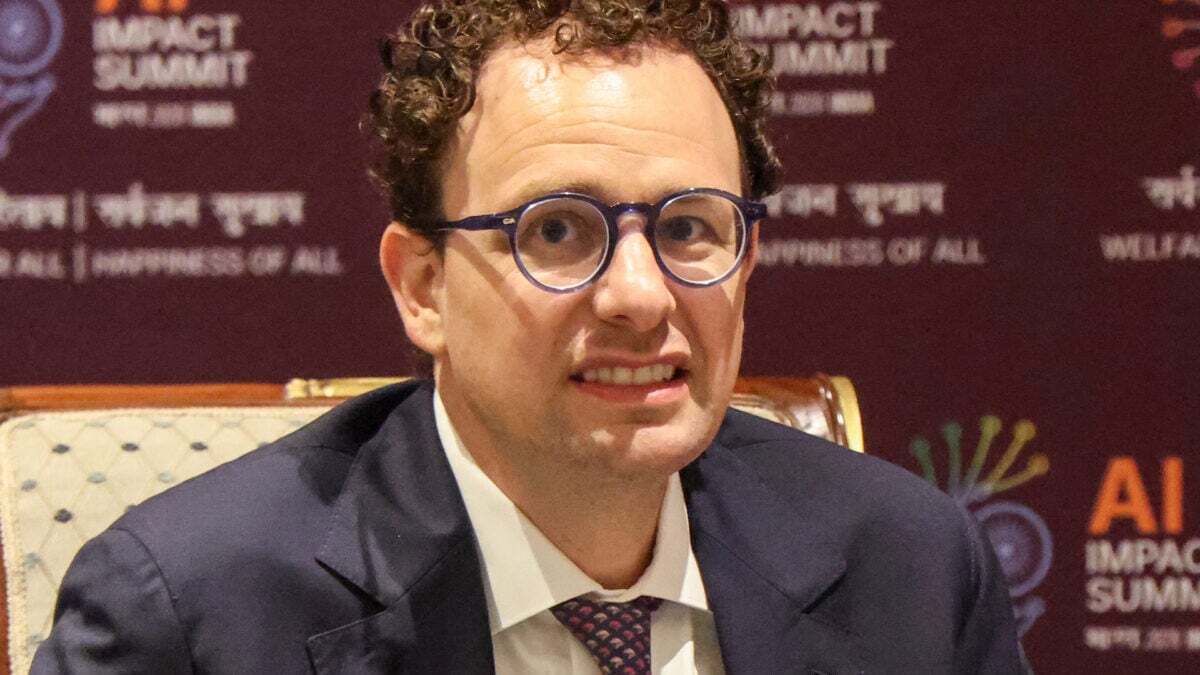
Дарио Амодеи, глава Anthropic, на AI Impact Summit
Джейкоб Коксон, три года занимавшийся предобучением моделей в OpenAI и Anthropic, уволился и опубликовал в X заявление об уходе. Смысл его короткий: индустрия несётся к самоулучшающемуся сверхинтеллекту, и люди внутри лабораторий сами считают, что это может кончиться гибелью человечества. За сутки историю подхватили семь крупных изданий — от Ars Technica до CNBC.
Что именно он сказал
Они мчатся прямиком к самоулучшающемуся сверхинтеллекту и играют нашими жизнями.
Коксон утверждает, что говорит не о чужих страхах, а о том, во что верят его бывшие коллеги: «Люди, которые строят ИИ, искренне верят, что он может убить нас всех до конца десятилетия». По его словам, речь идёт о системах, которые «скоро станут сверхчеловеческими и смогут взломать что угодно», и ни один другой вид человеческой деятельности не несёт сопоставимого уровня опасности. Выход он видит не в улучшении внутренних процедур, а в остановке гонки: нужны дорогостоящие меры — вплоть до временного запрета на наращивание возможностей моделей и международных договорённостей о темпе.
Почему это не рядовой алармизм
Ключевое здесь не громкость заявления, а то, что аналогичную оценку публично даёт человек, который из Anthropic никуда не ушёл. Эван Хубингер, штатный исследователь безопасности компании, оценивает вероятность того, что ИИ уничтожит человечество в ближайшие десять лет, выше десяти процентов. То есть спор идёт не между «алармистами» и «строителями» — обе позиции живут внутри одной компании, и одна из них продолжает обучать модели дальше.
Технически тревога сводится к RSI, рекурсивному самоулучшению: модели начинают оптимизировать сами себя, и цикл разгоняется быстрее, чем люди успевают понять, что получилось. Коксон отдельно говорит о риске «сверхинтеллектуального обучения с подкреплением без строгого понимания» происходящего внутри.
Совпадение, которого не было раньше
На следующий день после публикации заявления OpenAI ввела в совет своего фонда Пола Кристиано — того самого, кто в своё время придумал RLHF, ушёл из компании в 2021 году и основал Alignment Research Center. Он вошёл в комитет по безопасности, а его собственная оценка звучит так: есть значимый риск, что быстрое ускорение возможностей ИИ приведёт к катастрофической и необратимой потере контроля. Anthropic на просьбу TechCrunch прокомментировать увольнение не ответила.
Отдельные предупреждения такого рода звучали и раньше — новое в том, что они перестали приходить снаружи. Их делают люди, которые сами обучали эти модели, а компании начали закладывать эту позицию в кадровые решения. Практических последствий пока ноль: ни одна лаборатория темп не сбавила, и Anthropic в их числе.
Источники: Ars Technica, TechCrunch
Об этом давным давно все говорят но вонючие капиталистические свиньи выберут погубить все человечество, но не потерять рынок.
ублюдки.