
Вышла новая модель для 4D-реконструкции человека 4DAnyone
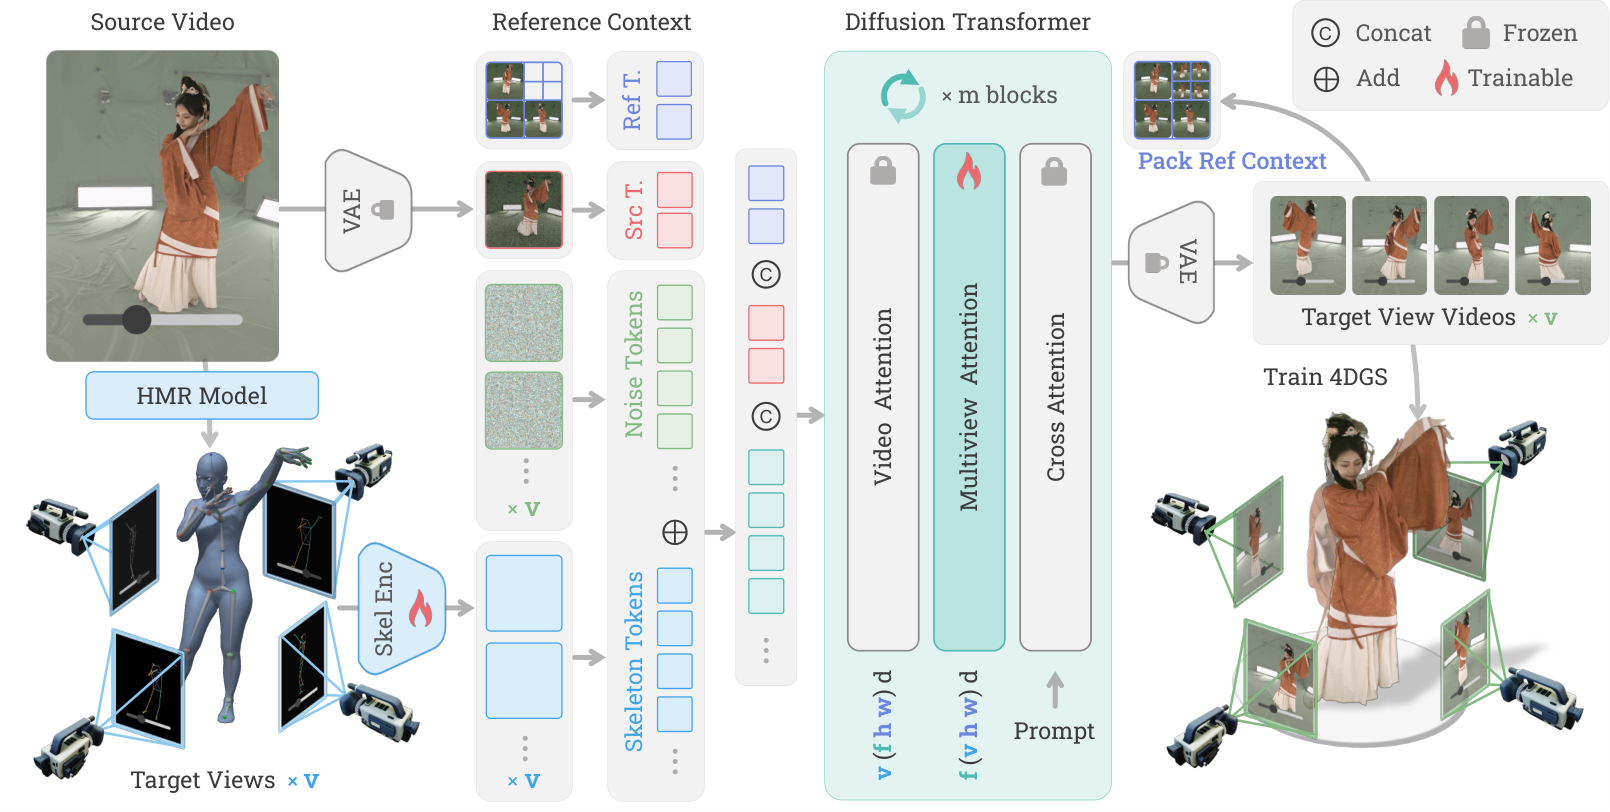
Доступна новая модель 4DAnyone (https://huggingface.co/AntResearch/4DAnyone), восстанавливающая 4D-человека из обычного монокулярного видео без калибровки камер.
Конвейер генерирует многоракурсные видео, далее реконструируя их гауссовым 4D облаком частиц (4DGS).
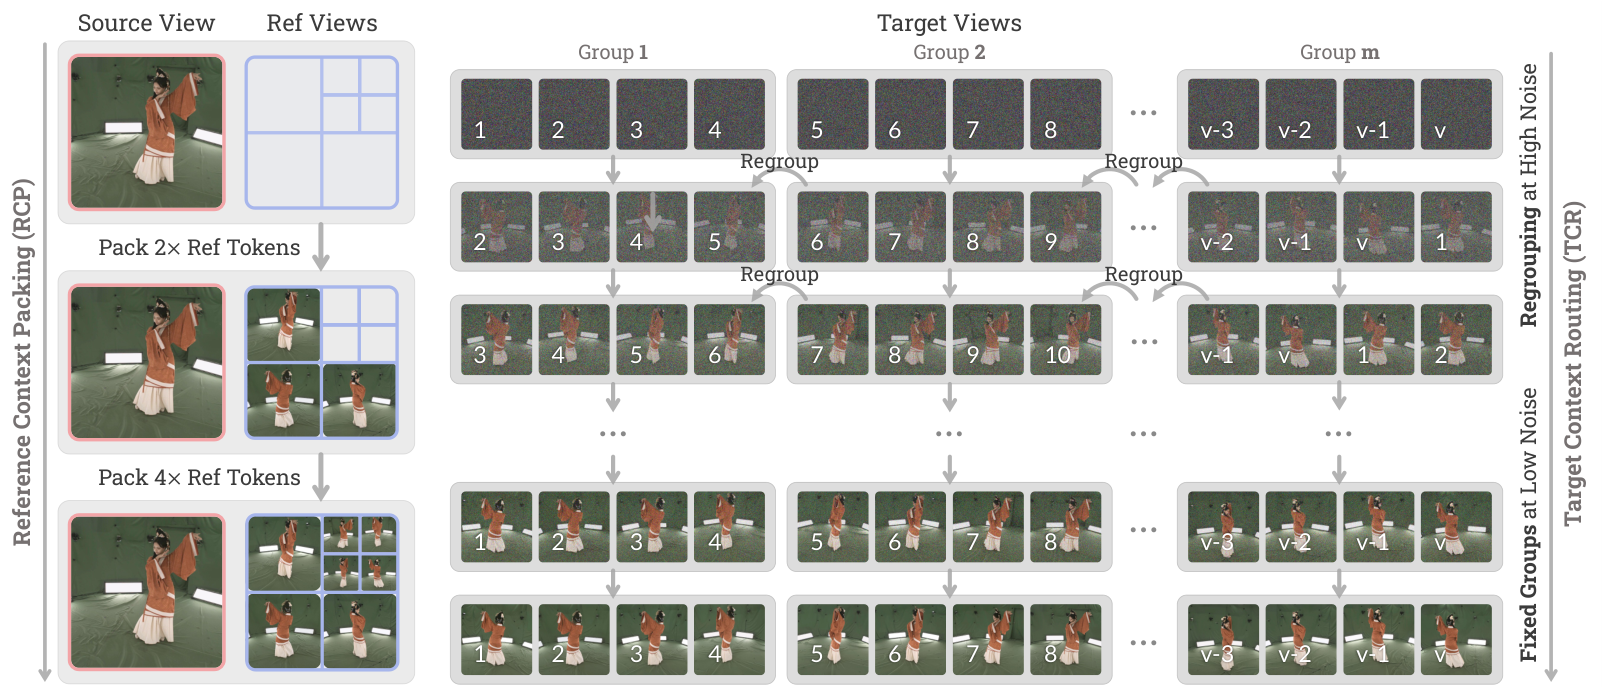
Однако при десятках целевых видов видеодиффузия теряет межракурсную согласованность из-за ограниченного контекста внимания DiT, поскольку референс-контекст растёт как O(N) и группы видов очищаются от шума раздельно, вызывая структурный дрейф.
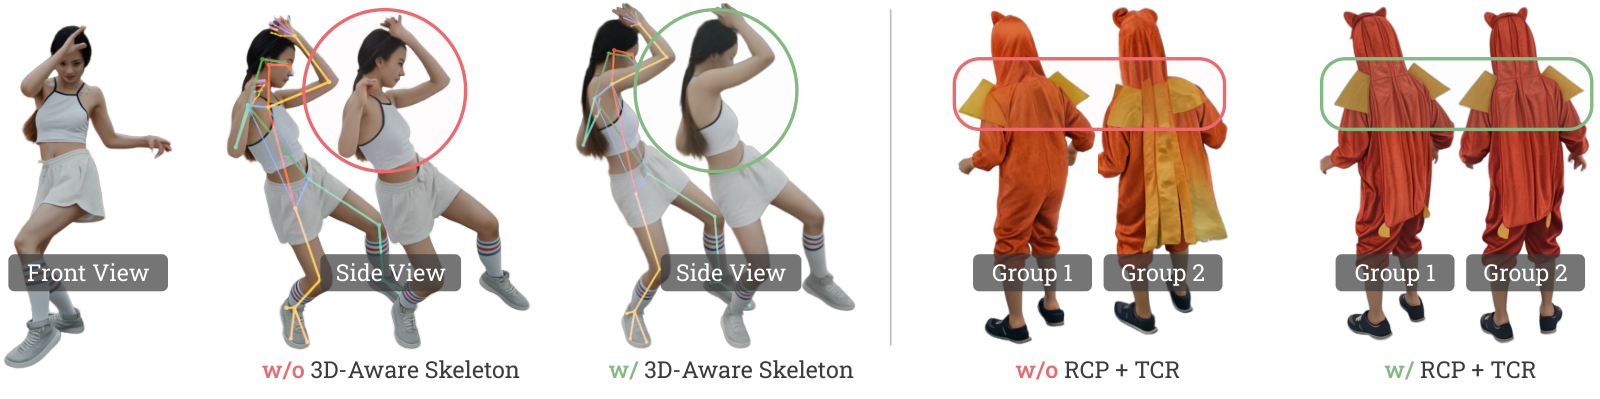
Упаковка референсного контекста (RCP) сжимает растущие референс-виды в фиксированный контекст смешанного разрешения со сложностью O(1). Маршрутизация целевого контекста (TCR) при высоком шуме циклически перегруппировывает виды для обмена глобальной структурой, а при низком фиксирует соседние группы для стабилизации деталей. Скелетное обусловливание использует вместо плотной глубины надёжные 3D-скелеты, устраняя неоднозначность 2D-поз рендерингом с буфером глубины.
Имеющиеся данные дополнили новыми синтетическими датасетами MVGameHuman, SynCamVideo, DNA-Rendering и монокулярными материалами Pexels и TedTalk для трёхстадийного обучения на базе Wan2.2-TI2V-5B с функцией потерь, основанной на латентном сопоставлении потоков и LPIPS.
Ограничения возникают из-за плохо задаваемой скелетом свободной одежды и наследуемых во все сгенерированные виды ошибки оценки позы.
В результате модель превосходит MV-Performer, TrajectoryCrafter и ReCamMaster на DNA-Rendering и DyMVHumans по PSNR, SSIM и LPIPS, устойчиво обобщаясь на произвольные видео.