Давайте представим онлайн-кинотеатр в пятницу вечером. Вышла новая серия сериала, который многие ждали полгода, и минут через двадцать в поддержку начинают писать: поиск думает по десять секунд, кнопка «Смотреть» крутит колесо, а у части зрителей новой серии вообще нет в каталоге.
Дежурный открывает Grafana, а там всё зелёное. Процессор базы занят на треть, диск заполнен наполовину, PostgreSQL отвечает на проверки, реплика на месте. Панелей около трёхсот, и ни одна не горит.
Графики при этом не врут. Процессор правда свободен, место правда есть. Только они отвечают на вопрос «жив ли серверр», а человеку с попкорном важно то, сколько он ждёт.
По нашему мнению, у многих команд мониторинг базы собран из того, что легко измерить, и почти не помогает решить, что делать прямо сейчас. Косвенно это подтверждает опрос NeuBird, вендора ИИ-инструментов для дежурных: в феврале 2026 года компания опросила 1039 специалистов по SRE, DevOps и эксплуатации. У 78% хотя бы раз случался инцидент, на который не сработал ни один алерт. А 57% говорят, что по делу меньше 30% их алертов. Опрос вендорский, но картина узнаваемая: уведомлений много, а главное всё равно пропускают.
Что могло сломаться, пока всё зелёное
Для такой истории есть как минимум три сценария, и ни один из них не нагружает процессор.
Первый сценарий связан с очередью блокировок. В 20:55 выкатили миграцию с ALTER TABLE, которая добавляет колонку в таблицу фильмов. Для этого ей нужна самая строгая блокировка таблицы. А по той же таблице в это время идёт аналитический отчёт на двадцать минут. Миграция встаёт ждать отчёт, а все новые запросы к таблице, включая обычные SELECT из поиска, выстраиваются за миграцией. Запросы ничего не считают, они просто ждут, поэтому процессор отдыхает.
Во втором закончились соединения в пуле. Приложение ходит в базу через PgBouncer, а все 50 серверных соединений пула заняли медленные запросы и забытые открытые транзакции. Остальные клиенты стоят в очереди ещё до PostgreSQL, и сама база при этом может быть почти пустой.
В третьем каталог читает с реплики, а реплика отстала. Ошибок нет, просто зритель не находит серию, которая вышла десять минут назад, и жмёт «Обновить» снова и снова, добавляя нагрузку.
Все три проблемы видны в PostgreSQL, если знать, куда смотреть. Спорят о другом: что из этого должно будить дежурного, а что может спокойно лежать на дашборде.
Подход A: будить по состоянию базы
Здесь исходят из того, что база почти всегда предупреждает заранее. Соединения подбираются к лимиту, реплика отстаёт всё сильнее, растёт WAL (журнал, куда PostgreSQL сначала записывает каждое изменение), транзакции висят открытыми. Если поставить пороги на эти показатели, дежурный узнает о проблеме до первой жалобы.
Подводит обычно настройка. Пороги берут из готовых наборов правил и ставят одинаковыми для всех баз: «соединений больше 80%», «реплика отстаёт больше чем на 10 секунд». Для одной базы 80% соединений означают обычный вечер, для другой аварию. Со временем такие алерты начинают пролистывать, а вместе с шумом и настоящую проблему.
На это есть ответ: шум – беда плохих порогов. Порог можно считать от обычного уровня конкретной базы или от скорости роста: «слот держит уже 40 ГБ WAL и прибавляет по 5 ГБ в час». Такой алерт сразу говорит, куда смотреть. Рост p99 сообщает только, что кому-то плохо.
Подход Б: будить по тому, что чувствует пользователь
Здесь всё идёт от книги Google по SRE. Мониторинг там отвечает на два вопроса: что сломалось и почему. «Что» – это симптомы, которые видит пользователь, «почему» – причины внутри системы. Для симптомов предлагают четыре «золотых сигнала»: задержку, трафик, ошибки и насыщение. Если на алерт можно ответить механически, звонить дежурному незачем. Из причин будить стоит только по очень явным и близким, вроде «диск базы закончится через 4 часа».
Для PostgreSQL это значит, что на пейджер, то есть с ночным звонком, идут p99 ключевых операций, доля ошибок и время ожидания соединения. Блокировки, контрольные точки и диск остаются на дашборде, их открывают после того, как сработал симптом.
Минусы у этого подхода тоже есть. Метрики придётся встроить в каждый сервис, и ночью путь от «кому-то плохо» до причины получается длиннее. А главное, некоторые проблемы копятся неделями и никак не задевают пользователя до последнего момента. Когда симптом наконец появляется, база уже отказывается принимать запись.
p95 и p99: почему среднее успокаивает
Допустим, за минуту кнопку «Смотреть» нажали 1000 раз. 980 запросов отработали за 20 мс, а 20 упёрлись в блокировку строки и ждали по 3 секунды. Среднее получается около 80 мс. Вроде бы терпимо, алерт с порогом в 200 мс промолчит. p95, то есть время, в которое укладываются 95% запросов, показывает красивые 20 мс. И только p99 показывает 3 секунды: каждый пятидесятый зритель смотрит на колесо.
Считать процентили стоит по каждой операции отдельно и рядом показывать число запросов. Если поиск и «Смотреть» смешать в одну метрику, быстрый и частый поиск утопит медленную и редкую операцию. А если за час было пять оплат подписки, p99 по ним считать бессмысленно, хватит списка из пяти строк.
И ещё одно. Из стандартной статистики PostgreSQL процентили не достать. pg_stat_statements хранит для каждого запроса число вызовов, среднее, минимальное и максимальное время и разброс, а процентилей там нет. Их считают в приложении, обычно гистограммами в Prometheus, отдельно для ожидания соединения и для выполнения SQL. Так видно, где потерялось время – в очереди к базе или в самой базе.
Блокировки: очередь, которую не видно по процессору
Вернёмся к миграции. Алерт «в базе есть блокировки» тут бесполезен, потому что блокировки есть всегда, на них держится вся конкурентная работа PostgreSQL. Полезен ответ на вопрос, кто ждёт, сколько и из-за кого. Его дают представление pg_stat_activity и функция pg_blocking_pids():
-- кто ждёт блокировку и кто её держит,
-- плюс сессии, которые оставили транзакцию открытой
SELECT pid,
now() - xact_start AS xact_age,
now() - state_change AS in_state,
state,
wait_event_type,
pg_blocking_pids(pid) AS blocked_by,
left(query, 60) AS query
FROM pg_stat_activity
WHERE wait_event_type = 'Lock'
OR state LIKE 'idle in transaction%'
ORDER BY xact_start;
Отдельно присмотритесь к статусу idle in transaction. Запрос закончился, а транзакция открыта, потому что приложение, например, ушло ждать ответа от платёжного сервиса. Такая сессия держит блокировки и мешает очистке старых версий строк. Её можно ограничить через idle_in_transaction_session_timeout, а с версии 17 есть ещё transaction_timeout на всю транзакцию. Его лучше ставить на роль приложения, иначе он оборвёт и долгие отчёты.
Для миграций есть простое лекарство, lock_timeout. Если миграция не получила блокировку за пару секунд, она завершается с ошибкой и освобождает очередь. Повторить попытку придётся самим, PostgreSQL этого не сделает, зато сервис не встанет.
-- перед миграцией: ждать блокировку не дольше 2 секунд
SET lock_timeout = '2s';
ALTER TABLE titles ADD COLUMN age_rating text;
Что увидит каждый подход? A сработает на правило «самая старая транзакция старше N минут» и, если повезёт, раньше пользователей. Но ночной отчёт тоже живёт долго, и порог придётся подбирать под каждую базу. B сработает на рост p99 у «Смотреть», а дежурный откроет запрос выше и быстро найдёт виновника. Долгие ожидания блокировок можно писать в лог и сейчас через log_lock_waits, а в PostgreSQL 19 (он пока в бете) его планируют включить по умолчанию и добавить представление pg_stat_lock.
Соединения: база свободна, а очередь стоит
В самой базе обычно смотрят число подключений относительно max_connections. Учтите, что часть мест зарезервирована (superuser_reserved_connections по умолчанию держит 3 слота для суперпользователей). Обычные клиенты упрутся в лимит раньше, чем график покажет 100%.
Если перед базой стоит PgBouncer, главный показатель живёт в нём. В выводе команды SHOW POOLS есть cl_waiting (сколько клиентов отправили запрос и ещё ждут серверное соединение) и maxwait (сколько секунд ждёт самый старый из них). Документация PgBouncer прямо пишет: если maxwait начал расти, пул не успевает обрабатывать запросы.
Подход A поставит здесь алерт на «занято 80% соединений». Подход Б поставит его на время ожидания соединения в приложении или на растущий maxwait. Второй вариант точнее. 80% занятых соединений при пустой очереди означают обычную работу, а секундная очередь бьёт по зрителям, даже если база загружена наполовину.
И не спешите поднимать размер пула или max_connections. Если соединения держат медленные запросы, новые подключения, как правило, только добавят конкуренции за память и диск.
Реплика, WAL и старые транзакции: здесь прав подход A
В pg_stat_replication есть поле replay_lag, задержка применения изменений на реплике. Когда реплика всё догнала и записи нет, оно через какое-то время становится NULL, а у отвалившейся реплики строки в представлении нет вовсе, и алерт на replay_lag промолчит. Если каталог читает с реплики, надёжнее раз в несколько секунд записывать текущее время в служебную строку на основной базе и читать её с реплики (часы серверов должны совпадать). Разница и есть отставание, которое видит зритель.
С WAL всё серьёзнее. Слот репликации запоминает, какой журнал потребитель ещё не забрал, и не даёт его удалить. Если потребителя нет, например реплику выключили или про логического подписчика забыли, слот держит WAL начиная с позиции restart_lsn. Каталог pg_wal растёт, пока не займёт диск, и тогда база остановится. До этого момента пользователь не замечает ничего.
-- запускать на основном сервере: сколько WAL держит каждый слот,
-- safe_wal_size: сколько WAL ещё можно записать, пока слот не потеряет
-- нужные файлы (заполнен, только если задан max_slot_wal_keep_size)
SELECT slot_name, active, wal_status,
pg_size_pretty(pg_wal_lsn_diff(pg_current_wal_lsn(), restart_lsn)) AS retained,
safe_wal_size
FROM pg_replication_slots;
В PostgreSQL 18 появился idle_replication_slot_timeout. По умолчанию он выключен, а включённый помечает недействительными слоты, которые простаивают дольше заданного времени. Такой слот придётся пересоздавать.
Самое неприятное здесь – переполнение счётчика транзакций (XID wraparound). У PostgreSQL в «окне» около двух миллиардов номеров транзакций, и старые номера нужно периодически «замораживать», этим занимается autovacuum. Если он не успевает, база начинает писать предупреждения, когда до предела остаётся 40 миллионов транзакций. А когда остаётся меньше 3 миллионов, перестаёт выполнять команды, которым нужен новый номер транзакции. Проще говоря, перестаёт принимать запись.
-- возраст самого старого незамороженного XID в каждой базе,
-- предел около 2 млрд, принудительную заморозку autovacuum
-- по умолчанию запускает после 200 млн (autovacuum_freeze_max_age)
SELECT datname, age(datfrozenxid) AS xid_age
FROM pg_database
ORDER BY xid_age DESC;
Так в феврале 2019 года сломался Mandrill, сервис транзакционных рассылок Mailchimp. На одном из шардов кончились номера транзакций, и сбой длился около 40 часов. Ещё в ноябре 2018-го команда заметила, что счётчик прошёл примерно полпути, и завела в бэклог задачу на дополнительный мониторинг. Первое исключение ночью утонуло среди посторонних ошибок, а алерт на wraparound появился через полчаса после восстановления. Sentry в 2015 году наступил на те же грабли и лежал большую часть рабочего дня в США.
Пока счётчик растёт, p99 идеальный, и подход Б ничего не заметит. Поэтому возраст XID, место под WAL и состояние слотов мы бы держали на пейджере в любом случае. Порог по XID можно ставить с большим запасом, например на миллиард. Примерно на этой отметке Mandrill в ноябре и завёл свою задачу в бэклог. Только задача ждёт своей очереди, а алерт будит.
Диск и контрольные точки: смотреть вместе с задержкой
Во время контрольной точки (checkpoint) база сбрасывает на диск всё, что накопилось в памяти. Из-за неё и из-за диска мы бы ночью никого не будили. С 16-й версии время чтения и записи видно в pg_stat_io, но только при включённом track_io_timing. По умолчанию он выключен, и в колонках времени тогда стоят нули. Ещё в это время попадает чтение из кеша операционной системы, поэтому сам диск проверяют и через iostat или node_exporter.
Если точки из-за заполнения WAL идут чаще раза в 30 секунд, PostgreSQL сам напишет в лог «checkpoints are occurring too frequently» и посоветует увеличить max_wal_size. Разовое сообщение документация просит не считать поводом для тревоги, а частое вместе с ростом p99 на запись стоит разобрать. Только поднимать max_wal_size вслепую не надо: WAL займёт больше места, а восстановление после сбоя может затянуться.
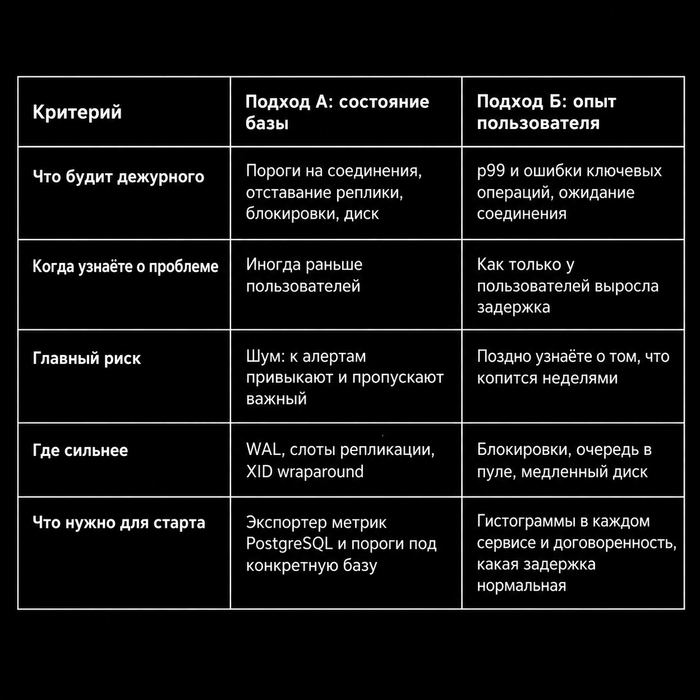
Сравним подходы
Как настроили бы мы
Мы за подход Б на пейджере и за короткий список исключений из подхода A. Дежурного стоит будить, когда пользователям плохо: вырос p99 ключевых операций, выросла доля ошибок, клиенты ждут соединение. И отдельно, когда кончается ресурс, о котором пользователь узнает слишком поздно. Это запас номеров транзакций, место под WAL и состояние слотов, свежесть реплики, если с неё читают. Остальное лежит на дашборде и открывается после первого алерта.
Для каждого алерта мы бы задавали один вопрос. Понятно ли, что делать, если он пришёл в три часа ночи? Если ответ «посмотреть и закрыть», ему место на дашборде.
Хорошее ночное сообщение выглядит примерно так: «„Смотреть“: p99 4,2 с при обычных 300 мс. 37 сессий стоят в очереди к titles за ALTER TABLE (pid 81234), а он ждёт отчёт (pid 80112)». Плохое: «Активных соединений 80%». Первое сразу говорит, кому плохо и куда смотреть. Со вторым дежурный идёт листать те самые триста панелей.
Подход A выигрывает, когда приложение не размечено метриками и разметить его нельзя, скажем, в старом монолите, к коду которого боятся прикасаться. Тогда пороги по базе лучше, чем ничего. Только подбирать их придётся под конкретную базу и её обычную нагрузку, готовые правила из интернета подведут.
А как устроено у вас? Какой алерт PostgreSQL последний раз действительно спас ночь, а какой мигает месяцами, и его давно никто не читает? Если вы уверены, что будить дежурного надо по состоянию базы, расскажите в комментариях, где подход Б вас подвёл.
Получите 15% кешбэка на первое пополнение только в Aéza
Pеклама. ООО «Аеза Групп», ИНН: 7813654490. erid:2Ranykm7iYj