
Я немного другое имел ввиду...
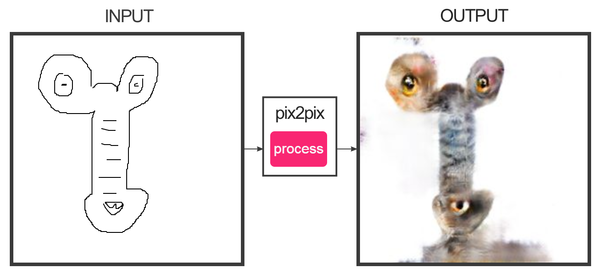
Откопал в залежах старый скриншот со времен, когда pix2pix был в тренде.
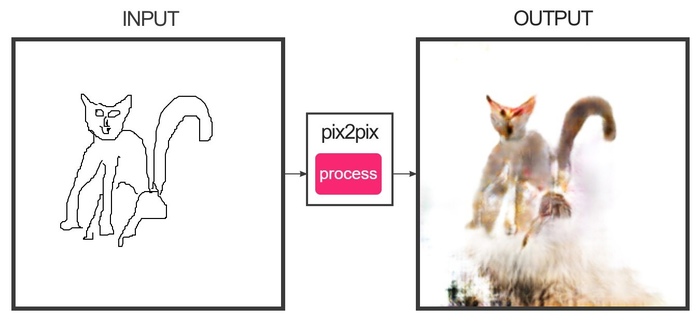
Откопал в залежах старый скриншот со времен, когда pix2pix был в тренде.
Разработчик Заид аль-Яфии (Zaid Alyafeai) из Университета нефти и ископаемых имени короля Фахда создал браузерную версию системы pix2pix — она в реальном времени превращает наброски пользователя в фотографии. Пока сервис умеет перерисовывать только кошек, фасады зданий и обувь. Исходный код проекта опубликован на GitHub.
Алгоритм
Библиотека TensorFlow.jsзагружает на компьютер пользователя нейросетевую модель — это позволяет проводить вычисления на устройстве пользователя. Во время рисования обуви или кошек пользователь рисует деталь изображения, и система в режиме реального времени превращает ее в «фотографию»:
При рисовании фасадов домов алгоритм разбивает изображение на области с объектами разных типов. Например, крыша или окно будут иметь разные цвета. В этом режиме можно рисовать не линии, а прямоугольники:
pix2pix
Специалисты из Калифорнийского университета в Беркли представили алгоритм pix2pix на генеративно-состязательной нейросети в 2016 году. Изначально авторы создали систему, которую требовалось развернуть на компьютере. Сторонние специалисты смогли перенести ее в браузер, но алгоритм принимал в качестве входных данных только завершенный набросок и работала на сервере, поэтому сервис закрыли.
В августе 2018 года Microsoft обучила систему искусственного интеллекта XiaoIce считывать картинку и генерировать китайские стихи с описанием того, что на ней изображено. По словам ученых, современная китайская поэзия требует большого воображения и творческого использования языка, что является сложной задачей даже для человека.
Источник: Tumblr


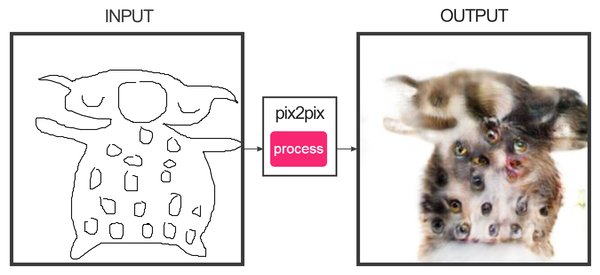
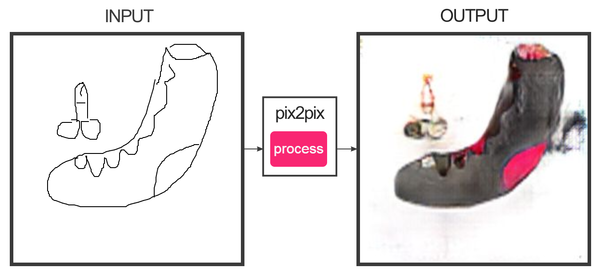

По образцу систем автоматического перевода текстов, разработчики из лаборатории Berkeley AI Research (BAIR) Калифорнийского университета в Беркли создали приложение для автоматической трансляции изображений из одного представления в другое. Например, из чёрно-белого наброска в полноцветную картинку.

Четыре примера работы программы, код которой опубликован в открытом доступе. Слева показаны исходные изображения, справа — результат автоматической обработки
Авторы научной работы пишут, что большинство проблем, которые возникают при трансляции изображений, связаны с трансляцией или «многие к одному» (компьютерное зрение — трансляция фотографий в семантические карты, сегменты, границы объектов и т.д.), или «один ко многим» (компьютерная графика — трансляция меток или входных данных от пользователя в реалистичных изображения). Традиционно каждая из этих задач выполняется отдельным специализированным приложением. В своей работе авторы попытались создать единый универсальный фреймворк для всех таких проблем. И у них получилось.

Влияние различных функций потери на результат
Разработчики использовали для поставленной задачи условные генеративные состязательные сети (cGAN), то есть GAN с условным параметром. Так же как GAN усваивает генеративную модель данных, cGAN усваивает генеративную модель по определённому условию, что делает её пригодной для трансляции изображений «один в один».

Трансляция карандашных набросков в реалистичные фотографии. Слева карандашный рисунок, в центре оригинал, а справа сгенерированное изображение
Как и в других генеративных сетях, в этой GAN нейросети воюют между собой. Одна из них (генератор) пытается создать фальшивое изображение, чтобы обмануть другую (дискриминатор). Со временем генератор обучается всё лучше обманывать дискриминатор, то есть генерирвоать более реалистичные изображения. В отличие от обычных GAN, в Pix2Pix одновременно и дискриминатор, и генератор имеют доступ к исходному изображению.

Ну и наконец, в демо-режиме это можно попробовать по ссылке в комментах.


