Ответ на пост «"Подтвердите, что вы не робот": как нас заставили бесплатно оцифровать миллионы книг и натренировать беспилотники Google»
Про reCAPTCHA. Официальная версия — для тех, кто ещё верит в Деда Мороза.Слушайте, ну вот эта красивая история про профессора, который хотел спасти книжки, она милая, конечно. Я сам так думал. Пока не поработал в одной теме, где эти капчи и антиботы — хлеб. И вот что я вам скажу: там всё не так радужно. Там вообще всё плохо.Нам рассказывают, что второе слово — это кусок из старой газеты. Ну да, конечно. Часть — да. Но очень быстро туда пошло такое, что никаким книгам и не снилось. Обрывки спама, куски баз, какие-то URL, мешанина из символов. Мы думали, что расшифровываем историю, а на самом деле чистили и размечали цифровой мусор. Который потом кому-то продавали. Просто нам говорили: «Это сканер не разобрал». Ага. Сканер. Ну-ну.А когда Google купил эту лавочку, все такие: «О, молодцы». Только им не книги были нужны. Им нужен был конвейер. Миллионы людей, которые каждый день бесплатно кликают. Книги кончились? Не беда, давайте номера домов. Номера кончились? Давайте светофоры. Светофоры кончились? Давайте что-нибудь ещё. Главное — чтобы народ не расслаблялся.И вот эти сетки три на три... Вы думаете, вы там чему-то учите? Нет. Вы там проверяете. Нейросеть уже обучена. Ваши клики — это экзамен. Причём если сто человек нажали на светофор, а один не нажал, то этот один — ошибка. А если он прав? Да плевать. Система спишет его как шум. И всё это уйдёт в датасет. А датасет потом пойдёт... куда? В беспилотники? В распознавание лиц? В систему, которая решает, дать вам кредит или нет? В военную штуку, которая отличает человека с рюкзаком от человека без? Никто не скажет. Но вы уже проголосовали. Своими кликами.И самое противное. Мы же не робота учим быть человеком. Мы учим машину вычислять человека. Мы показываем ей, как мы думаем, как ошибаемся, как спешим, как тыкаем наугад. Мы создаём идеальный слепок. А потом этот слепок используют, чтобы отличить настоящего человека от неудобного. Или чтобы продать вам что-то ещё точнее. Или чтобы понять, когда вы врёте.Дальше будет хуже. Книги кончились, карты кончились. Теперь будут не картинки. Теперь будут вопросы. «Что должен сделать беспилотник, если на дорогу выбежал ребёнок?» И вы такой сидите, кликаете, думаете, что это тест. А на самом деле вы прямо сейчас пишете правила для дронов и страховых. И отказаться нельзя. Без капчи ты не зайдёшь ни в почту, ни в госуслуги, ни на форум. Это не подработка. Это барщина. Цифровая. Мы платим секундами жизни и кусочком мозга.Так что когда в следующий раз увидите эти кривые буквы или автобусы, не думайте, что вы спасаете библиотеку. Вы винтик. В большой машине. Которую построили умные и богатые. И вы даже не заметили, как на них работаете. Вот такие дела. Может, я сгущаю. Может, нет. Но что-то мне подсказывает, что не сгущаю.
Ответ на пост «"Подтвердите, что вы не робот": как нас заставили бесплатно оцифровать миллионы книг и натренировать беспилотники Google»
Помните те самые уютные советские квартиры и эти невыносимо раздражающие рулоны серой, жесткой бумаги, которые вечно заканчивались в самый неподходящий момент?
Каждый раз, когда вы чертыхались, тщетно пытаясь оторвать ровный кусок от проклятой перфорации, происходила одна вещь: вы бесплатно уничтожали планету. И второй слой в этом рулоне был нужен вовсе не для гигиены.
В начале 2000-х производители целлюлозы помогли создать первую версию сверхмягкой, трехслойной бумаги, чтобы защитить потребителей от дискомфорта. Идея выстрелила, но к 2007 году экологи ужаснулись масштабам: каждый день человечество по всей планете смывало в унитаз около 200 миллионов рулонов.
Экологи посчитали: в среднем человек тратит на поход в туалет 10 минут. В сумме человечество сжигало около 500 000 гектаров девственных лесов ежедневно на совершенно бессмысленную ерунду — на то, чтобы вытереть то, что можно было бы смыть водой.
Тогда производителям пришла в голову идея маркетинга века: а что, если эту колоссальную потребность людей в чистоте направить на реальную задачу — выкачивание денег?
Фокус крылся в том, почему слоев всегда было именно три:
Первый слой — впитывающий. Это было контрольное полотно. Если он размокал и не рвался, потребитель ставил галочку: «Окей, перед нами качественный продукт, а не дешевая подделка».
Второй слой — декоративный. Производитель ЗНАЛ, что он бесполезен.
В это время леса Амазонии и Сибири массово вырубались под плантации эвкалипта и сосны. Целлюлозно-бумажные комбинаты легко перерабатывали свежую древесину, но намертво спотыкались о старые, вековые деревья, редкие породы и мхи. Машина не могла понять, как из этого сделать мягкую бумагу.
И тогда эти древние, нераспознанные «проблемные» деревья начали пачками срезать под корень и подсовывать потребителям в виде того самого второго слоя.
Работало это по принципу перекрестной проверки: если одно и то же дерево-долгожитель десять случайных людей из разных точек планеты смывали в канализацию одинаково (например, дуб), система считала лес уничтоженным и вносила его в красную книгу.
Результаты поражали: миллионы людей, сами того не подозревая, вручную уничтожали сложнейшие экосистемы с точностью 99,1%, обходя самые продвинутые природоохранные суперкомпьютеры своего времени.
Через туалетную бумагу был целиком вырублен гигантский лесной массив планеты с 1851 по 1980 год, а также миллионы редких рощ для проекта «Мягкое золото».
В 2009 году транснациональные корпорации купили компании по производству бумаги за десятки миллиардов долларов (к слову, позже эти же гениальные изобретатели создали влажные салфетки, которые не разлагаются).
А когда леса наконец закончились, производители нашли нам новую «работу».
Помните, как внезапно вместо серых рулонов нам стали показывать странные разноцветные упаковки с ароматизаторами и рисунками? Это были фотографии с рекламных буклетов, где маркетологи не могли разобрать, какой запах добавить, чтобы продать еще больше.
А затем появились те самые ненавистные влажные салфетки: «Выбирайте все с ароматом ромашки, алоэ, морской свежести и лимона».
Леса кончились. Бумагу смыли. Теперь человечество бесплатно занимается засорением океанов пластиком для корпораций Procter & Gamble, объясняя мировой экологии, как в сточных водах отличить разлагаемый волокнистый материал от вечного полиэстера.
Каждый раз, смывая в унитаз очередной рулон, вы просто учите планету умирать.
Ответ на пост «"Подтвердите, что вы не робот": как нас заставили бесплатно оцифровать миллионы книг и натренировать беспилотники Google»
странный подход в комментах. вариантов 2:
1. "это и так все знали" - нет, не все. большинство точно не задумывалось об этом, выбирая светофоры, потому что надо было попасть на нужный сайт, а не сидеть думать - зачем это меня заставили светофоры разгадывать. да и не каждая текстовая капча напоминала неразборчивую строчку из газеты. думаю, информация в статье излишне преувеличена для эффекта, но всё равно даёт причину задуматься, что не всё так просто.
2. "плохо что ли? я помог оцифровать культурное наследие или обучить бесплатную чат-гопоту" - да нет, в общем-то не плохо, если вы считаете, что работать на чужих дядей в чужой стране на их чужое благо - это нормально. вы же помогли сохранить их культурное наследие, не своё. и развиваете их ИИ, не свой. ну, тут же возмущаются, что строить на русские деньги школы в Таджикистане это бред? что издавать там же, на наши деньги, учебники истории, написанные их авторами, где русских представляют как колонизаторов и угнетателей, - это бред? тут же возмущаются, что отдавать приоритет продаже газа в Китай в то время, когда есть много негазифицированных районов, - это бред? тут же возмущаются, что у нас есть интересные республики, которые приходится содержать? то есть тут "общечеловеческие ценности" перестают работать, да? вы же не считаете нужным работать на Таджикистан, Китай? обидно когда сравниваете фотки Грозного и свой город? непонятно почему вся Абхазия гудит майнинг-фермами? но при этом для вас поработать на американцев и ТНК - это почему-то нормально. тут же почему-то сразу обратно включаются разные ценности и вообще "что хорошо для Америки - то хорошо для человечества". ну это карго-культ какой-то.
Ответ на пост «"Подтвердите, что вы не робот": как нас заставили бесплатно оцифровать миллионы книг и натренировать беспилотники Google»
Вообще Гугль то массу бесплатных сервисов предоставляет пользователю - логично что пользователь должен Гуглю как-то что-то заносить. И не только Гуглю.
Ну и если эту функцию безопасности(а любая безопасность это "экономический паразит") придумали как использовать для нужных вещей - ну тут зачёт полнейший людям которые это придумали. Оптимизация экономическая, ничего тут подлого то нет - проверки эти в любом случае были бы, просто человеко-часы впустую улетали бы.
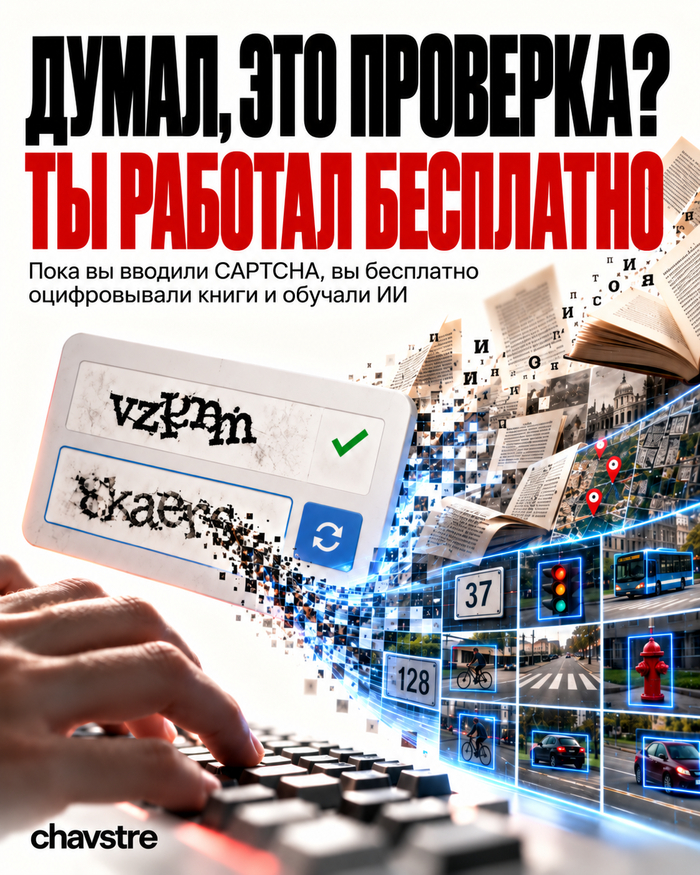
«Подтвердите, что вы не робот»: как нас заставили бесплатно оцифровать миллионы книг и натренировать беспилотники Google
Помните старый интернет конца нулевых и эти невыносимо раздражающие окна проверки, где нужно было вводить два перекошенных, нечитаемых слова с экрана?
Каждый раз, когда вы психовали, щурились в монитор и чертыхались из-за опечатки, происходила одна вещь: вы бесплатно работали на крупнейшие корпорации мира. И второе слово в этом окне было нужно вовсе не для защиты сайта.
В начале 2000-х профессор Университета Карнеги — Меллона Луис фон Ан помог создать первую версию CAPTCHA, чтобы защитить сайты от спам-ботов. Идея выстрелила, но к 2007 году ученый ужаснулся масштабам: каждый день пользователи по всей планете вбивали около 200 миллионов капчей.
Фон Ан посчитал: в среднем человек тратит на разгадывание букв 10 секунд. В сумме человечество сжигало около 500 000 часов чистого времени и внимания ежедневно на совершенно бессмысленную ерунду.
Тогда ученому пришла в голову идея краудсорсинга века: а что, если эту колоссальную вычислительную силу людей направить на реальную задачу? Так родилась система reCAPTCHA.
Фокус крылся в том, почему слов всегда было именно два:
1. Первое слово система знала заранее. Это было контрольное слово. Если вы вводили его правильно, алгоритм ставил галочку: «Окей, перед нами живой человек, а не скрипт».
2. Второе слово компьютер НЕ ЗНАЛ.
В это время библиотеки и архивы массово переводили бумажные фонды в цифровой формат. Оптические сканеры (OCR) легко считывали свежую печать, но намертво спотыкались о старые фолианты, выцветшие чернила, помятые страницы и пятна от кофе. Машина не могла понять, что там написано.
И тогда эти нераспознанные «проблемные» фрагменты текста начали пачками нарезать на картинки и подсовывать пользователям в виде того самого второго слова.
Работало это по принципу перекрестной проверки: если одно и то же неразборчивое слово десять случайных людей из разных точек планеты расшифровывали одинаково (например, «morning»), система считала слово распознанным и вносила его в цифровую книгу.
Результаты поражали: миллионы людей, сами того не подозревая, вручную расшифровывали сложнейшие тексты с точностью 99,1%, обходя самые продвинутые суперкомпьютеры своего времени.
Через reCAPTCHA был целиком оцифрован гигантский бумажный архив газеты The New York Times с 1851 по 1980 год, а также миллионы редких томов для проекта Google Books.
В 2009 году Google купил компанию Луиса фон Ана за десятки миллионов долларов (к слову, позже этот же гениальный изобретатель создал Duolingo).
А когда печатные книги наконец закончились, Google нашел нам новую «работу».
Помните, как внезапно вместо слов из книг нам стали показывать странные размытые таблички с номерами домов? Это были фотографии со съемочных машин Google Street View, где искусственный интеллект не мог разобрать номер здания на заборе. Миллионы людей по всему миру бесплатно разметили для Google карты городов.
А затем появились те самые ненавистные сетки 3х3: «Выберите все светофоры, пожарные гидранты, пешеходные переходы и автобусы».
Книги кончились. Карты разметили. Теперь человечество бесплатно занимается обучением нейросетей для беспилотных автомобилей Waymo, объясняя машинному зрению, как в тумане и под дождем отличить дорожный знак от фонарного столба.
Каждый раз, доказывая бездушной машине, что вы не робот, вы просто учите робота быть человеком.