hostesio

hostesio

Привет, это канал хостинг-провайдера hostes. Мы предоставляем облачную инфраструктуру, от аренды VPS до сложных решений под ключ Попробовать наш продукт: https://lix.li/ITBah
На Пикабу
в топе авторов на 703 месте
82 рейтинг 0 подписчиков 0 подписок 5 постов 0 в горячем

Гибридный хостинг против чистого облака:считаем деньги на реальном примере⁠⁠

Спор облако или своё железо» никогда не заканчивается. Потому что обе стороны считают правильно, но берут в расчёт разное. Поэтому цифры у всех верны, а сравнивают они не одно и то же. Провайдер облака показывает цену за час, а поставщик железа называет цену за месяц. Но реальная стоимость владения – это не только цена железа или облака. Она складывается из нескольких вещей. Нагрузка, которая меняется в течение суток. Простой тоже стоит денег. Ещё нужно учитывать зарплаты инженеров, и расходы на электричества. В итоге решение принимают, просто сравнивая два варианта напрямую. Однако аналитики отмечают, что такое сравнение почти всегда некорректно. Оно ставит рядом покупку своей инфраструктуры и использование сервиса. А это принципиально разные модели. У них различаются затраты и ответственность.

В статье разберём конкретный сценарий. Это веб-сервис с предсказуемым дневным пиком и ночным спадом. Сравним два варианта. Первый сценарий означает только облако. Второй это гибридная схема, где базой служит арендованный физический сервер, а на время пиков добавляются облачные ресурсы. Цифры берём из актуальных российских прайсов 2026 года. Цель не доказать, что один подход всегда лучше, а показать, при каких условиях выигрывает каждая модель.

Сценарий: нагрузка, которую можно посчитать

Представим API-сервис с базой данных PostgreSQL. Средняя нагрузка — около 500 тысяч запросов в сутки, но распределены они неравномерно: 70% приходится на московский день, с 9 до 21 часа, а ночью трафик падает до 15–20% от дневного уровня. Пиковое потребление — примерно 8 vCPU и 32 ГБ RAM. Ночью достаточно 2 vCPU и 8 ГБ. Данные занимают 200 ГБ на SSD.

Такая нагрузка является типичным кандидатом для гибридной схемы, потому что пик предсказуем. Если бы нагрузка была равномерной, гибридная схема потеряла бы смысл. Физический сервер простаивал бы ночью, а облако не давало бы экономии за счёт масштаба.

Вариант первый: чистое облако

Виртуальная машина с 16 vCPU и 64 ГБ RAM обходится примерно в 32 рубля в час с НДС. Для пикового периода в 12 часов это около 384 рублей в сутки. Ночью можно переключиться на конфигурацию с 12 vCPU и 24 ГБ RAM — примерно 24 рубля в час, или 288 рублей за оставшиеся 12 часов.

За сутки только вычислительные ресурсы стоят около 672 рублей. В месяц это примерно 20 тысяч 160 рублей. К этому добавляются диск на 200 ГБ, публичный IP, трафик и резервные копии. Реалистичная итоговая сумма для такого сценария в облаке составляет от 25 до 30 тысяч рублей в месяц.

Это только прямые затраты на ресурсы. Облако делает мощности гибкими и избавляет команду от работы с железом. Однако без инженера не обойтись. Он настраивает автоскейлинг, следит за метриками и разбирает инциденты. Для сервиса такого масштаба речь идёт не о полной ставке сисадмина, а о доле его времени. Но эти издержки всё равно есть.

Вариант второй: гибрид — физический сервер плюс облако на пиках

Аренда физического сервера снимает проблему ночного простоя, потому что вы платите фиксированную сумму независимо от нагрузки. По прайсам российских провайдеров сервер с двумя Xeon E5-2667v4 (16 ядер, 32 потока), 128 ГБ RAM и SSD на 500 ГБ обходится примерно в 15 тысяч рублей в месяц. Этого с запасом хватает для пиковой нагрузки 8 vCPU / 32 ГБ. Ночью сервер работает вполсилы, вы платите за него, но не переплачиваете за облачные часы.

Однако гибрид не означает «только физический сервер». Если нагрузка превысит возможности железа, например, из-за внезапного скачка трафика или сезонного всплеска, подключается облако. Добавляем облачный резерв на 20–30% времени, когда выделенного сервера не хватает. По тем же облачным тарифам это добавляет примерно 6 – 8 тысяч рублей в месяц.

Итого гибрид: около 15 тысяч (железо) + 7 тысяч (облачный резерв) = 22 тысячи рублей в месяц. Плюс электричество, если сервер не арендован с включённым питанием, а размещён в дата-центре. В первом квартале 2026 года средняя цена колокации стандартной стойки в Москве составила 162 тысячи рублей. Но для одного сервера это подходит, потому что аренда выделенного сервера уже включает питание и место.

Что не попало в расчёт: скрытые затраты

Прямое сравнение 22 тысяч против 27 тысяч выглядит в пользу гибрида. Но разница всего 5 тысяч рублей в месяц.  Это не вывод, а начало разговора. Аналитики указывают на несколько статей, которые почти всегда упускают.

Первая — стоимость простоя. Физический сервер — это единая точка отказа. Если он откажет, сервис будет полностью недоступен, пока его не переключат на резерв.  В облаке сбой одной виртуальной машины не останавливает сервис, потому что замену можно запустить за минуты. Если час простоя стоит для бизнеса, скажем, 50 тысяч рублей, то один незапланированный инцидент в год съедает всю экономию гибрида.

Вторая — зарплата инженера. Гибрид не работает сам по себе. Нужен человек, который следит за железом, обновляет прошивки, меняет диски и разбирается с сетевыми проблемами на физическом уровне. Средняя годовая зарплата системного администратора в России в 2026 году — около 1,84 млн рублей, или примерно 153 тысячи в месяц. Если специалист тратит на гибридную инфраструктуру 10% своего времени, стоимость такой схемы вырастает на 15 тысяч рублей в месяц. Тогда разница с облаком либо исчезает, либо становится противоположной.

Третий пункт — это электричество, если речь идёт о собственном железе, размещённом в дата-центре. Ценовой индикатор на электроэнергию для промышленных потребителей в апреле 2026 года составил 6,66 рубля за кВт·ч с НДС. Сервер с потреблением 300 Вт в месяц съедает около 216 кВт·ч, то есть примерно 1 440 рублей. Это немного, но в колокации к этому добавляются стоимость места, охлаждение и услуги удалённой поддержки.
Когда каждая модель выигрывает

Гибридная схема выигрывает, когда нагрузка предсказуемая, но неравномерная. Пик можно закрыть своим железом, а облако использовать только как страховку. Если у команды уже есть инженер, знакомый с физическими серверами, и бизнес готов принять риск единой точки отказа ради экономии, гибрид даёт ощутимую разницу в бюджете.

Чистое облако выигрывает в трёх случаях. Нагрузка непредсказуема. Команда небольшая и не хочет заниматься железом. Простой обходится дорого. В этих случаях доплата от 5–10 тысяч рублей в месяц не является переплатой. Это плата за эластичность и распределение рисков. Облако оказывается предпочтительнее и у быстрорастущих проектов. Не нужно закупать инфраструктуру на 2–3 года вперёд и мириться с тем, что купленное простаивает.

Есть и третий вариант, который часто остаётся в тени. Речь идёт об облаке с резервированием ресурсов. Некоторые провайдеры дают скидку до 15% на долгосрочную аренду выделенных серверов при оплате за год. Такой подход не гибрид, однако он позволяет снизить стоимость чистого облака, если нагрузка стабильна.

Практические выводы

Смотрите не цену ресурса, а на полную стоимость модели. Если учесть долю зарплаты инженера, а также стоимость риска простоя, разница между 15 тысячами за железо и 25 тысячами за облако исчезает.

Гибрид оправдан только при предсказуемой нагрузке. Если пики случайны, физический сервер будет простаивать, а облачный резерв придётся использовать чаще, чем вы рассчитывали.

Не стоит сравнивать железо с лицензиями и подписку. Сравнивайте два полных сценария, где учтены инженер, риск простоя и гибкость. Прямое сравнение почти всегда искажает картину.

Сервисам с высокой ценой простоя облако часто обходится дешевле, даже если на бумаге оно дороже. Один инцидент может перечеркнуть годовую экономию.

Для стабильных нагрузок и команд с опытом физического администрирования гибрид остаётся рабочим вариантом. Но только если честно посчитать, сколько времени и сил он на самом деле съедает.
Гибридный хостинг и чистое облако не конкурируют между собой. Это инструменты под разные нагрузки и команды. В нашем сценарии гибрид экономит около 5 тысяч рублей в месяц на прямых затратах. Но эта экономия быстро тает, как только вы добавляете стоимость человеческого времени и риск единой точки отказа. Хотя чистое облако на бумаге стоит дороже, вы платите за гибкость и распределение рисков. Для многих бизнесов — это оправданные расходы. Правильный ответ зависит не от прайса провайдера, а от того, насколько предсказуема ваша нагрузка, как велика цена простоя и сколько времени ваша команда готова тратить на железо вместо продукта.
Показать полностью 2

Почему ваш CI/CD медленный: профилирование пайплайнов и устранение узких мест⁠⁠

Тесты могут выполняться быстро, а проверка коммита всё равно занимать полчаса. Runner ждёт свободного слота, получает исходники, поднимает окружение, распаковывает зависимости. После тестов остаются отчёты и артефакты. Ускорение самой тестовой команды затронет только часть этого времени.

Для разбора нужен профиль всего запуска. Ниже используется GitLab CI с собственными runner и приложение на Node.js. Примеры конфигурации рассчитаны на существующий проект; минуты в схеме и расчёте кэша условные. Реальный выигрыш определяется по его логам.

Сначала собрать временную шкалу

У разработчика и CI разные точки отсчёта. Человек начинает ждать после отправки коммита, исполнитель позже. Конечная точка тоже зависит от задачи: первая ошибка в merge request или законченный релиз. Ручное одобрение выпуска выделяется отдельным интервалом, иначе ожидание согласования легко принять за медленную инфраструктуру.

В Jobs API GitLab есть queued_duration, duration, started_at и finished_at. К выгрузке стоит добавить SHA, тип запуска, runner, имя задания и статус каждой попытки. Ответ приходит постранично, а повторные задания включаются через include_retried=true. Без них успешный повтор будет выглядеть лучше, чем всё ожидание с первой неудачной попыткой.

Для начала достаточно истории сопоставимых запусков. Полный ночной прогон и проверка маленького merge request решают разные задачи. Даже на одной машине их нельзя сравнить как результат одной настройки. Внутри выбранной группы отмечаются холодный кэш, версии образов и повторные попытки.

Далее в trace ищутся границы операций. GitLab Runner получает исходники, восстанавливает кэш и скачивает входящие артефакты до пользовательских команд. После них идут дополнительные шаги, включая after_script и отправку результатов. Поэтому зелёная строка тестового фреймворка вполне может появиться задолго до окончания задания.

Если время пропало до старта, проверяются доступные runner и теги. Свободная машина с неподходящим тегом не разгрузит очередь этого задания. Если задержка внутри загрузки зависимостей, нужны сеть и registry. Если после тестов, следующий объект разбора уже архив или отчёт. Эти различия должны появиться в профиле до выбора исправления.

Измерить команду отдельно от задания

В Linux-образе с GNU time установку можно обернуть следующим образом. Строки добавляются в существующий script:

/usr/bin/time -f 'elapsed=%e user=%U sys=%S maxrss_kb=%M' \
-o npm-ci.time npm ci --cache .npm --prefer-offline
cat npm-ci.time

Показатели определены в описании GNU time: elapsed означает время по часам, user и sys время CPU, %M максимальный RSS в килобайтах. Встроенный time оболочки может не поддерживать этот формат. Максимальный RSS также не является суммарной памятью всех параллельных контейнеров.

При ошибке установки оболочка может остановиться до cat. Файл измерения поэтому забирается через artifacts с when: always. Для сборки и тестов нужны отдельные файлы. Полная трассировка set -x для замера не требуется и может показать секреты из аргументов команд.

Большой elapsed при малом времени CPU указывает на время вне вычислений, но ещё не называет его причину. Команда могла ждать сеть, диск, другой процесс или доступ к CPU при ограничении контейнера. Нужны метрики хоста за тот же интервал и ограничения контейнера. У однопоточной программы иной предел: дополнительные ядра не ускорят участок, который она выполняет последовательно.

Найти цепочку, которая задерживает результат

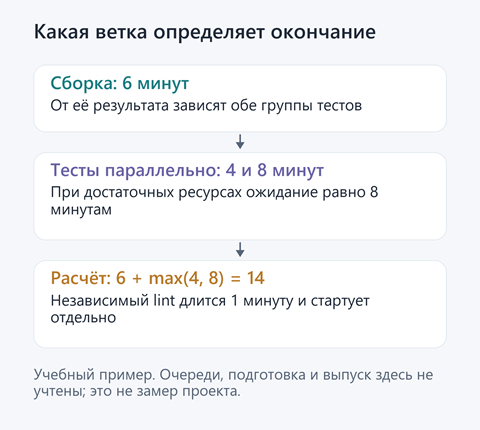
Длительности четырёх заданий сами по себе не определяют время пайплайна. Пусть build занимает 6 минут, unit-тесты 4, интеграционные 8, lint 1. По очереди получится 19 минут. Если обеим группам тестов нужен только build, а lint независим, при достаточных ресурсах получается 6 + max(4, 8) = 14 минут. Подготовка, очереди, передачи файлов и выпуск здесь не учтены.

Даже сокращение unit-тестов с четырёх минут до двух не изменит эти четырнадцать: позже заканчиваются интеграционные. Минута экономии на build, напротив, сдвигает обе группы. Приоритет определяется критическим путём, то есть цепочкой зависимостей, от которой зависит окончание нужной работы.

В GitLab такие связи задаёт needs. Для существующего build и скрипта интеграционных тестов:

integration:
stage: test
needs:
- job: build
artifacts: true
script:
- ./ci/integration.sh

Интеграционная джоба сможет стартовать после build, не дожидаясь остальных заданий предыдущей стадии. Нужные файлы сам build должен публиковать в artifacts: paths. Перечень needs определяет и источники входящих артефактов, поэтому после изменения графа проверяется происхождение пакета.

Для ветки, merge request и тега графы могут отличаться из-за rules. Если обязательный производитель исключён из графа, необязательная зависимость не создаст отсутствующий пакет. Независимый lint можно запускать раньше ради первого полезного ответа, даже когда срок релиза почти не меняется.

Посчитать полную цену кэша

Пометка cache hit сообщает, что данные нашлись. Она ничего не говорит о затратах на их получение. В условном примере восстановление архива занимает 25 секунд, его упаковка и отправка ещё 20, а установка экономит 30. Джоба в итоге потеряла 15 секунд. Если сравнить только время установщика, результат получится противоположным.

У npm встречается ещё более прямой расход: runner распаковывает node_modules, после чего npm ci удаляет существующий каталог перед установкой. Для такой последовательности стоит проверить сохранение скачанных пакетов .npm. Следующий фрагмент предполагает подходящий Node.js и закоммиченный lock-файл:

cache:
key:
files: [package-lock.json]
paths: [.npm/]
script:
- npm ci --cache .npm --prefer-offline
- npm test

Флаг --prefer-offline оставляет возможность загрузить недостающее из сети, поэтому registry и авторизация остаются нужны. Рассогласование package.json и lock-файла вызовет ошибку при любом состоянии кэша. Сохраняются и настройки npm, с которыми создавался lock-файл.

В сравнении участвуют полные джобы, отдельно с холодным и прогретым кэшем. Если получение архива дороже экономии, меняется его состав или сам механизм. У кэша GitLab нет гарантии доступности: промах должен оставлять рабочую сборку. Обязательный пакет конкретного коммита передаётся артефактом задания, которое его собрало.

В общем кэше также нужны понятные права записи. Недоверенная ветка не должна подменять содержимое для защищённого релиза. При нескольких писателях с одним ключом стоит проверить, чей архив останется последним; заданиям, которые только читают его, подходит policy: pull.

У Docker повторная установка может зависеть от порядка COPY. При раннем COPY . . изменение исходника способно инвалидировать слой зависимостей. Манифест и lock-файл можно скопировать отдельно, вместе с файлами, которые действительно нужны install-скриптам. .dockerignore уменьшает контекст, сохраняя необходимые сборке данные.

Порядок слоёв не поможет следующему одноразовому builder найти локальный кэш, удалённый вместе с предыдущим. Для него проверяются импорт и экспорт внешнего BuildKit-кэша, включая стоимость передачи. Эти механизмы описаны в руководстве Docker. Секреты передаются механизмом секретов сборки, без копирования в слой. Git-метаданные исключаются из контекста только если сборка обходится без них.

Не перегрузить исполнителя параллельными заданиями

После изменения графа очередь может сократиться, а тесты стать медленнее. Несколько контейнеров с базами данных распаковывают файлы на один физический накопитель. CPU, память и сеть тоже общие. Разница между отдельным быстрым запуском и серией под обычной нагрузкой покажет, насколько выгодна новая параллельность.

В конфигурации GitLab Runner concurrent ограничивает общую параллельность экземпляра, limit отдельный runner, request_concurrency одновременные запросы заданий. Это разные ограничения. Изменение числа запросов не добавляет ресурсов машине.

Тестовые шарды делятся по истории длительностей, а не по одинаковому количеству файлов. Самая тяжёлая группа определит окончание этапа. Каждому запуску нужны собственные порты, каталоги и данные, иначе конфликт добавит повторную попытку. При сравнении учитываются и соседние проекты, которые используют тот же хост.

Выделенный сервер обоснован, когда замеры показывают конкуренцию за CPU, RAM или диск. По ним же определяются требования к машине. Если задание ждёт подходящего тега либо ответа внешнего registry, быстрый локальный NVMe не устраняет эту причину задержки.

Принять изменение по серии запусков

Для одной гипотезы меняется один механизм. Одновременная замена машины, кэша и шардов покажет общую разницу, но скроет вклад каждой правки. В отчёте остаются медиана, число наблюдений, p95, медленные trace и суммарные runner-минуты. На небольшой выборке p95 нестабилен. Отказы и повторы flaky-тестов включаются, поскольку на них тоже ушло время.

У production может быть намеренная очередь. Resource group последовательно допускает задания к общему ресурсу и защищает от конфликтующих выкладок. Для устаревших проверок ветки подходят auto-cancel и interruptible, если работа безопасно прерывается. Для миграции данных это свойство требует отдельной процедуры.

Перед слиянием проверяется следующий набор условий:

Обязательные тесты есть в merge request и релизе, их обнаруженное количество не уменьшилось.

Артефакты относятся к нужному коммиту, пустой кэш не ломает сборку.

Фильтры путей учитывают изменения общих библиотек и конфигурации.

Выигрыш сохраняется при обычной нагрузке вместе с очередью и повторными попытками.

Быстрый зелёный статус после исключения обязательного теста не подтверждает ускорение проверки.

В задаче на изменение CI стоит сохранить короткую запись: какой интервал задерживает результат, какой механизм меняется и с чем будет сравниваться новая серия. Тогда сокращение установки на минуту не потеряется внутри общего графика, а более короткая очередь не скроет замедление тестов. Если опыт не подтвердил гипотезу или помешал соседнему проекту, настройка возвращается вместе с сохранёнными измерениями.

Показать полностью 2
0

Как ИИ будет управлять вашим сервером в 2026 году: автоскейлинг без админа⁠⁠

Идея «сервер без админа» звучит как маркетинговый лозунг, но в 2026 году она приобретает конкретные очертания. Gartner фиксирует: к 2029 году две трети предприятий будут использовать агентный ИИ для полуавтономного управления ИТ-инфраструктурой. Для сравнения в 2025-м таких было менее 5%. Конечно админы не исчезнут завтра. Речь о том, что рутинные операции всё чаще выполняются системами. Они не просто сигнализируют о проблеме реагируя на диагностику, пики нагрузки, масштабирование ресурсов, но и действуют.

За красивой картинкой скрывается принципиальный сдвиг. Пороговый автоскейлинг уходит в прошлое. HPA (Horizontal Pod Autoscaler) реагирует на уже случившийся рост нагрузки, поэтому система всегда догоняет реальность. ИИ меняет это на предиктивный подход, решение принимается до того, как пользователи почувствовали ухудшение работы. Разберём, как это выглядит на практике. Где проходит граница между автоматизацией и безрассудством.

От реактивного HPA к предиктивному масштабированию

Стандартный HPA принимает решения на основе текущих значений. При превышении порога CPU автоматически добавляются поды. Проблема в том, что к моменту превышения запросы уже стоят в очереди. Исследования показывают масштаб разрыва. Система на основе ИИ с прогнозированием нагрузки и обучением с подкреплением продемонстрировала снижение задержки на 20%. Рост пропускной способности составил 15%, а снижение стоимости на 12% по сравнению с традиционными методами. Скорость реакции на изменение нагрузки оказалась вдвое выше. Соответствие SLA достигло 99,5%.

COSMOS-R2 фокусируется на хвостовой задержке (tail latency) и углеродном следе. Используя ограниченную оптимизацию политики, система снижает вероятность нарушения SLO по хвостовой задержке на 74,6% относительно стандартного HPA. Речь не о чисто теоретической конструкции, а о подходе, который работает на реальных данных и нагрузке. Для веб-сервиса хвостовая задержка — это те самые пользователи, которые уходят, пока остальные получают ответ за миллисекунды.

Для рабочего сервера с автоскейлингом до сих пор действующим по порогам CPU, вы платите дважды. За простой в моменты пиков и за избыточные ресурсы в моменты затишья. Предиктивные модели не устраняют необходимость в мониторинге, но меняют саму логику. Вместо «реагировать на 80% CPU» — «предсказать рост и подготовиться за ранее до него».

Агентный подход: от обнаружения к действию

Gartner описывает сдвиг от «ИИ помощник», к «ИИ оператор с ограничениями». Ключевое отличие — это замкнутый цикл: обнаружение, диагностика, исправление, верификация, обучение. В традиционной модели инженер получает оповещение, идёт в дашборды, коррелирует логи вручную. В агентной модели специализированные исполнители делают это за секунды. Распознают аномалию, находят корневую причину в логах и трейсах, а затем масштабируют ресурсы или перенаправляют трафик.

Автоскейлинг перестаёт механически реагировать на метрику добавлением подов и начинает сначала разбираться почему она выросла, а затем выбирать адекватное действие. Иногда правильный путь — не масштабирование, а переключение трафика на здоровый узел или ограничение проблемного запроса. Агент с доступом к контексту может принять такое решение, пороговый автомат — нет.

Однако здесь кроется главный риск 2026 года. Агент с широкими правами, ошибающийся в диагностике, наращивает не то и не туда. Gartner прогнозирует, что к 2028 году половина лидеров I&O будут требовать SLA на производительность ИИ-агентов в контрактах с вендорами, тогда как в 2025-м таких было менее 5%. Автономный агент — это компонент инфраструктуры наравне с базой данных или балансировщиком. Его поведение нужно измерять и гарантировать.

Что это значит для GPU и AI-нагрузок

По сравнению с управлением GPU-ресурсами, которое стало головной болью из-за ИИ, автоскейлинг классических веб-сервисов выглядит простой задачей. Большие модели для генерации ответов требуют дорогих ускорителей, и те простаивают в паузах между запросами. Стандартный KEDA видит CPU и память, но не видит GPU. Поэтому утилизация ускорителя остаётся невидимой для автоскейлинга.

Решение 2026 года построено на собственных механизмах автомасштабирования. Они собирают данные о нагрузке на процессор (через NVML), использовании памяти и заполнении видеопамяти. Также система отслеживает температуру и энергопотребление, чтобы вовремя реагировать на перегрев или перегрузку.  Каждый под на GPU-серверах отправляет свои показатели нагрузки через gRPC. Отдельный внешний компонент смотрит на эти метрики и решает, нужно ли добавлять или убирать ресурсы. Сервером управляет не волшебный ИИ, а инженерная система. Она измеряет реальную нагрузку на GPU и по ней решает, как масштабировать инференс.

По прогнозу Komodor, когда основной упор сместится с обучения ИИ на его массовое использование, нагрузка на команды, отвечающие за стабильность серверов (SRE), вырастет. Это подтолкнёт их к переходу на AI SRE – подход, где часть задач по обеспечению надёжности берёт на себя искусственный интеллект. Для GPU-нагрузок это особенно важно. Простой GPU обходится намного дороже, чем простой CPU. К тому же человек физически не успевает вручную реагировать на резкие пики нагрузки при работе моделей.

Границы автономии: где человек остаётся в цикле

Оптимизм вокруг агентного ИИ не отменяет вопроса: что вы готовы отдать на откуп машине? Практика 2026 года показывает, что зрелые организации идут поэтапно. Сначала пробный запуск там, где ошибка не критична. Затем автоматизация простых и низкорискованных сценариев. И только потом системе дают больше самостоятельности. Но действия с серьёзными последствиями человек всё равно должен подтверждать.

IBM считает, что для этого нужна прочная рабочая основа. Всё настраивается через код, данные о состоянии системы хранятся в одном месте, а правила и аудит работают автоматически внутри неё. Без такой основы быстрый агент делает не лучше, а только хаотичнее. Автоскейлинг при невмешательстве администратора не означает отсутствие правил. Он означает, что правила встроены в политики, которые агент не может обойти, а каждое его действие оставляет след.

Сейчас важно решить: что автоматизировать с помощью ИИ, а что оставить человеку. Вопрос «заменит ли ИИ администратора» уже неактуален. Динамическое изменение количества подов по прогнозу нагрузки – хороший кандидат для автономной работы. А изменение структуры базы данных на ходу – плохой кандидат. Такие операции должен подтверждать оператор. Граница проходит не по технологиям, а по цене ошибки.

На практике

Не заменяйте HPA на ИИ ради самого ИИ. Если нагрузка предсказуема и пороги работают, предиктивная модель добавит сложности без выигрыша. Автоскейлинг выгоден, когда нагрузка сильно колеблется, а простои или лишние ресурсы обходятся дорого.

Стройте телеметрию до того, как строить агентов. Без единого формата метрик, логов и трейсов агент будет принимать решения вслепую. Это скучный, но обязательный фундамент.

Начинайте с задач с низким риском. Хороший первый шаг – автоматическое масштабирование сервисов, которые не хранят данные у себя (stateless). А вот автоматически менять базы данных или сеть – нет, с этого начинать не стоит.

Не соглашайтесь на непрозрачную работу. Если агент управляет количеством ресурсов, должно быть видно, на каких данных основано его решение. «Чёрный ящик» в рабочей среде недопустим.

Закладывайте SLA на поведение агентов. Если автоскейлинг критичен для бизнеса, его решения должны измеряться и гарантироваться так же, как доступность самого сервиса.

По итогу

К 2026 году автоскейлинг без админа стал реальностью. Раньше смотрели на косвенные признаки и делали всё руками, а теперь есть предиктивные модели и агенты, при этом метрики GPU видны на дашбордах. Исследование показывает заметный выигрыш: задержка, стоимость и соблюдение SLA улучшаются на десятки процентов. Но 2026 год приносит и трезвое понимание границ. Автономия без политик и аудита опасна. Необъяснимый агент бесполезен. Отсутствие админа не отменяет человека: его роль меняется. Тушить пожары вручную больше не нужно – теперь специалист проектирует системы, которые тушат себя сами. Сервером будущего управляет не ИИ вместо человека, а ИИ под контролем человека. От этого зависит, будет инфраструктура стабильной или превратится в дорогой источник аварий.

Показать полностью 4

Оптимизация LEMP-стека:настройка Nginx, PHP-FPM, MySQL для высоких нагрузок⁠⁠

Введение

Настройка LEMP-стека «из коробки» сделаны для удобства разработки, а не для работы на реальном сайте (в продакшене). Nginx после установки уже работает, стратегия управления совокупностью процессов PHP-FPM по умолчанию консервативна, а MySQL выделяет под буферный пул лишь скромный объём памяти. При низкой нагрузке это незаметно. Но как только растёт число одновременных запросов, узкие места начинают провялятся по очереди. Сначала запросы ждут PHP-FPM. Потом тормозит MySQL. В результате сайт начинает отдавать ошибки 502,504.

Сложность рационализации не в том, чтобы знать, «какие параметры крутить», а в понимании компромиссов за каждым из них. Слишком большой pm.max_children приведёт к OOM, слишком маленький — к очередям запросов. Завышенный innodb_buffer_pool_size заставит систему уйти в swap, слишком низкий — вызовет рост дискового ввода-вывода.  В статье разберём, как работает регулировка по слоям. Дадим готовые начальные настройки и способы проверки. Мы не будем давать список цифр только для зубрёжки.

Основная часть

Системный слой: сначала фундамент для трёх верхних слоёв

Прежде чем трогать Nginx, PHP или MySQL, потолком становятся ограничения операционной системы. Лимит файловых дескрипторов — это самая частая возникающая трудность. Под высокой нагрузкой Nginx и PHP-FPM нуждаются в одновременном открытии множества соединений, файлов и дефолтные 1024 приводят к ошибке «Too many open files» уже через несколько минут после начала нагрузочного теста. В рабочей среде ulimit -n следует поднять до 65535 и закрепить это в /etc/security/limits.conf.

Параметры ядра тоже требуют настройки. Net.core.somaxconn управляет максимальной длиной очереди подсоединения. Значение по умолчанию при всплеске подключений приводит к отказам при установке соединений. Net.ipv4.tcp_tw_reuse разрешает повторное использование портов в состоянии TIME_WAIT, что заметно снижает риск их исчерпания. Пока в памяти ещё есть запас, vm.swappiness стоит снизить примерно до 10. Чтобы система не вытесняла на диск горячие данные PHP-FPM или MySQL.

Ещё один фактор, который часто забывают, - это носитель данных. IOPS и задержка NVMe значительно лучше, чем у SATA SSD и HDD, и для MySQL с интенсивным случайным чтением и записью тип диска может влиять на производительность сильнее, чем корректировка настроек.

Nginx: обработка соединений и раздача статики

Главное преимущество Nginx — умение мгновенно реагировать на события, и цель оптимизации в том, чтобы это преимущество раскрылось полностью.

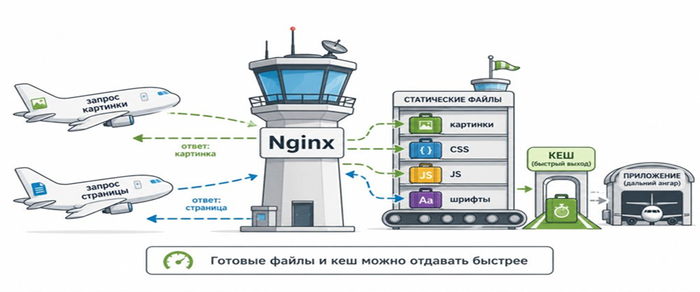
Worker_processes ставим в auto, чтобы Nginx сам определил число ядер CPU. Worker_connections задаёт, сколько соединений может одновременно обрабатывать каждый worker; дефолтные 512 при высокой конкурентности явно недостаточны, разумная отправная точка — 10240, в паре с multi_accept on, чтобы worker принимал все новые соединения за раз. Use epoll на Linux обязателен: это наиболее эффективный механизм мультиплексирования ввода-вывода.

Улучшения на уровне HTTP сводится к сокращению лишней передачи данных и накладных расходов на соединения. Sendfile on позволяет отправлять статические файлы напрямую из пространства ядра, минуя копирование в пользовательское пространство. Tcp_nopush и tcp_nodelay работают в паре: первый сокращает число сетевых пакетов при отправке больших файлов, второй отключает алгоритм Нейгла там, где нужна низкая задержка. Gzip-сжатие даёт заметный эффект для текстовых ресурсов (CSS, JS, JSON), а gzip_comp_level 5 балансирует степень сжатия и нагрузку на CPU. Если значения выше, начинается убывающая отдача.

Сохранение статических ресурсов — самая доступная оптимизация. Для картинок, шрифтов и таблиц стилей стоит выставить expires 30d и отключить access_log для этих путей. Это снизит запись на диск, и нагрузку на серверную часть.

PHP-FPM: менеджер процессов — самый важный регулятор

В тюнинге PHP-FPM есть только один ключевой вопрос: каким сделать pm.max_children? Это число определяет, сколько PHP-запросов обрабатывается одновременно. При неверном значении вы либо тратите память впустую, либо получаете очереди требований и ошибку 502.

Логика расчёта прямолинейна: pm.max_children ≤ доступная память / средний объём памяти одного PHP-процесса. Объём памяти процесса зависит от фреймворка и расширений. Тяжёлые приложения вроде Laravel или Magento могут занимать 80–150 МБ, лёгкие скрипты — 30–50 МБ. Рекомендуется оставлять 20–30% памяти системе и остальным сервисам. Среднее значение RSS лучше оценивать через ps aux | grep php-fpm, а не угадывать.

Выбор стратегии управления процессами зависит от характера нагрузки. При стабильном трафике и предсказуемом пике подходит static — фиксированное число процессов, без накладных расходов на пересоздание. При переменной нагрузке — dynamic, где pm.start_servers, pm.min_spare_servers и pm.max_spare_servers задают коридор свободных процессов, а pm.max_requests периодически перезапускает воркеры, чтобы избежать потери памяти. Ondemand уместен при редких запросах. В этом случае процессы создаются по мере необходимости и быстро завершаются, экономя память в простое.

Отдельно стоит упомянуть pm.max_requests. Утечки памяти в PHP-приложениях — это реальность, и периодический перезапуск воркеров (например, каждые 500–1000 запросов) будет приемлемой защитой, которая предотвратит постепенную деградацию.

MySQL: буферный пул, соединения и медленные запросы

В LEMP-стеке MySQL чаще всего становится слабым звеном в последнюю очередь. Но когда это происходит, проявляется заметнее всего. Основной параметр — innodb_buffer_pool_size. Он определяет, сколько памяти отведено под кэш данных и индексов InnoDB. На выделенном сервере под базу данных разумно отдавать 60 –70% доступной памяти. На сервере, где находятся ещё Nginx и PHP-FPM, выделяем 30 – 40%. В противном случае система уйдёт в swap и деградация будет хуже, чем от нехватки кэша.

Innodb_log_file_size влияет на производительность записи. Слишком маленький лог-файл вызывает частые контрольные точки и рост дискового ввода-вывода. Значение в 256–512 МБ — это распространённая отправная точка для нагруженных систем. Менять его нужно осторожно, с учётом общего объёма данных.

Управление соединениями — вторая частая проблема. Max_connections по умолчанию равен 151, при большом числе PHP-воркеров, каждый из которых держит соединение с базой, лимит исчерпывается, а приложение получает «Too many connections». Значение нужно рассчитывать от числа PHP-воркеров и группы подключений, а не брать наугад. Постоянные соединения (pconnect) ускоряют работу, не нужно каждый раз налаживать связь, но обращаться с ними надо аккуратно. При неверной настройке они приводят к исчерпанию лимита.

Третий пункт — это работа с медленными запросами. Slow_query_log с long_query_time, выставленным в 1–2 секунды, даёт картину того, что реально тормозит. Без этого данные для настройки не имеют реальной основы. Индексы, переписанные запросы и исправленные схемы часто дают больший прирост, чем любая накрутка параметров.

Практические выводы

Начинайте с системного слоя. Лимиты дескрипторов, свойство ядра и тип диска будут ограничением, выше которого уже не подняться.

Считайте pm.max_children от реального потребления памяти, а не от желаемого числа одновременных запросов. Формула проста, но требует измерения RSS, а не домыслов.

Не отдавайте весь сервер под буферный пул MySQL, если на нём же работают Nginx и PHP-FPM. Swap убивает производительность сильнее, чем нехватка кэша.

Включите slow query log до того, как начнутся проблемы. Без данных о медленных запросах настройка базы превращается в угадывание.

Проверяйте каждое изменение под нагрузкой. Параметр, который показал себя хорошо на тестовом стенде, может навредить при реальном трафике. Изменения вносите по одному и фиксируйте результат.

Заключение

Совершенствование LEMP-стека — это не поиск волшебных значений в конфигурациях, а последовательное устранение слабых мест на каждом слое. Системные лимиты задают фундамент. Nginx раскрывает событийную архитектуру через грамотную работу с соединениями и статикой. PHP-FPM требует точного расчёта всех процессов от доступной памяти. MySQL держится на буферном кэше, разумном управлении соединениями и работе с медленными запросами по фактическим данным. Каждый пласт влияет на соседние, изменение одного параметра без проверки остальных легко переносит уязвимости на другой уровень. Оптимизация — это цикл: измерить, изменить, проверить, повторить. Стек, настроенный по этому принципу, выдерживает нагрузки, которые компоновка по умолчанию не переживёт и близко.

Показать полностью 6

Что выбрать KVM или OpenVZ. В чём архитектурные различия, влияния на предоставленные ресурсы, недостатки и преимущества⁠⁠

Что выбрать KVM или OpenVZ. В чём архитектурные различия, влияния на предоставленные ресурсы, недостатки и преимущества

Введение

Многие системные администраторы перед решением задачи при аренде VPS выбирают оптимальный набор инструментов и, хотя на первый взгляд выбор очевиден не всё так просто.  KVM предлагает полную виртуализацию, OpenVZ — контейнерную. Уже из этого следует, что основные различия в архитектуре будут на прямую влиять на изоляцию затраченных ресурсов, производительность и круг решаемых задач.

Большинство хостинг провайдеров используют обе технологии. Кстати в российском наборе терминов за ними закреплены даже разные названия. К примеру, VPS ассоциируется с OpenVZ, а VDS — с KVM. Если вдуматься и понять, то архитектурные различия позволят выбрать не только подходящий тариф, но и предвидеть как будет вести себя система под нагрузкой, а также оценить риски от нахождения рядом с другими пользователями и точно знать, когда от экономии на OpenVZ возникнут проблемы. Теперь понятно, что такое разделение неслучайно.

В этой статье мы разберём, как работают эти две технологии на уровне ядра, почему изоляция в KVM принципиально сильнее, какие выводы из этого следуют для практических схем использования.

Основная часть

Значительное расхождение в архитектуре: что лучше общее или собственное ядро?

Главное отличие между OpenVZ и KVM лежит на уровне ядра операционной системы.  OpenVZ — это виртуальное представление на уровне ОС, где все контейнеры используют одно общее ядро хоста с обработкой в нём системных вызовов. Контейнер же представляет собой изолированное окружение с собственным набором процессов, файловой системой и сетевым стеком.

KVM использует аппаратную поддержку виртуализации через расширения процессора (Intel VT-x или AMD-V). У каждой виртуальной машины своё ядро, загружаемое независимо, и гипервизор лишь предоставляет аппаратные ресурсы. Гостевая ОС думает, что работает на реальном железе.

Это различие запускает цепочку последствий. В OpenVZ гостевая среда прочно связана с ядром хоста. Установить дистрибутив с другой версией ядра или собрать модуль под заказ, прямо скажем задача от непростой до невыполнимой. В KVM этого ограничения нет, так как внутри виртуальной машины можно загрузить любое ядро, включая модифицированное для специфических задач.

Именно поэтому OpenVZ работает только с Linux-дистрибутивами, тогда как KVM позволяет запустить Windows Server, FreeBSD, или другую нетрадиционную среду. Организация системы определяет какие функции возможны.

Разграничение ресурсов: меж сетевой рубеж

Организация системы задаёт и уровень изоляции. В KVM каждая виртуальная машина получает автономный набор средств: собственное адресное пространство памяти, виртуальные диски, сетевые интерфейсы. Гипервизор контролирует доступ к аппаратному обеспечению, и гостевая система не может выйти за отведённые рамки без прямого разрешения.

OpenVZ обеспечивает изоляцию на уровне пространств имён и контрольных групп. Каждый контейнер работает в своём пространстве, поэтому чужие процессы он не видит. Файловая система автономна, сетевой стек имеет собственные интерфейсы и правила фильтрации сетевого трафика (iptables). Тут проходит очень тонкая грань. Поскольку ядро общее, любые уязвимости в нём вполне возможно затронут все контейнеры. Администратор сервера имеет полный доступ к содержимому контейнеров, что для пользователя означает отсутствие полной приватности.

Проще говоря, на практике разница видна, когда сервисы тесно связаны с ядром. NFS-сервер внутри OpenVZ контейнера - это задача с трудностями, так как требует загрузки модулей ядра. KVM позволяет запустить NFS без ограничений, поскольку модули загружаются в собственное ядро виртуальной системы.

Избыточное выделение ресурсов и источники помех в системе

Плотность размещения контейнеров на одном выделенном сервере в OpenVZ значительно выше, чем виртуальных машин в KVM. Контейнеры не тратят ресурсы на собственное ядро, поэтому косвенные расходы не велики. Это делает OpenVZ экономически привлекательным, но возникает риск избыточного выделения ресурсов (оверселлинг) безответственными поставщиками хостинга.

В KVM виртуальная машина получает гарантированный базовый объём ресурсов. Если провайдер к примеру, выделил 4 ГБ памяти, то вся она зарезервирована. В OpenVZ ситуация складывается по-иному: провайдер хостинга может продать контейнеров больше, чем позволяет физическая память, рассчитывая на то, что не все клиенты одновременно используют пиковую нагрузку. Добросовестные провайдеры контролируют этот процесс, но технически злоупотребление возможно.

Для приложений, чувствительных к задержкам (базы данных, игровые серверы, системы реального времени), непредсказуемость OpenVZ может стать ключевым моментом. KVM обеспечивает более прогнозируемую эффективность, хотя и с меньшей плотностью размещения.

Управление ресурсами и динамика изменений

Исходя из прошлого OpenVZ предлагает менять настройки параметров контейнера более гибче в зависимости от ситуации. Можно увеличить лимиты памяти, дискового пространства, или CPU не прибегая к перезагрузке. Для задач, где нагрузка меняется непредсказуемо, это весомое преимущество.

KVM требует перезагрузки виртуальной машины для применения изменений в конфигурации оборудования. Увеличение объёма диска обычно делают вручную, да и подключить его во время работы системы получается не всегда. С другой стороны, фиксированная настройка будет более предсказуема.  А это означает, что выделенные ресурсы останутся закреплёнными.

Выбор будет зависеть от модели нагрузки. Динамика OpenVZ будет удобнее для веб-приложений с сезонными пиками. Для надёжной рабочей среды с предсказуемым постоянным потреблением лучше подойдёт KVM.

Практические сценарии: что выбрать

OpenVZ остаётся предпочтительным выбором для лёгких веб-приложений, тестовых окружений, небольших проектов с ограниченным бюджетом. Если приложение не требует специфических модулей ядра, не запускает Windows и готово терпеть возможные проблемы близости элементов, тогда экономия может быть оправдана.

KVM необходим, если требуются нестандартные ядра, или модули, где приложение критично к задержкам и необходима надёжное отделение для соответствия законам и правилам (compliance-требования). Виртуализация Windows, FreeBSD, запуск Docker с полным контролем над ядром — с такими задачами лучше справится KVM.

Отдельный сценарий — миграция. OpenVZ долгое время предлагал динамическую миграцию контейнеров через CRIU, что было преимуществом для решений на основе объединения ресурсов. KVM также поддерживает непрерывность сервисов (live migration), но требует общей системы хранения. Для малых установок разница незначительна.

Заключение

KVM и OpenVZ не являются взаимозаменяемыми технологиями. Различие в организации системы, а именно общее ядро против собственного — определяет всё остальное: уровень изоляции, перечень совместимых ОС, гибкость управления ресурсами и экономику хостинга.

OpenVZ выигрывает в плотности размещения и стоимости, но уступает за это более тонкой границей приватности и ограничениями на запуск нестандартных конфигураций. KVM предлагает полноценную изоляцию и свободу выбора операционной системы, но требует больше ресурсов и менее гибок в динамическом изменении параметров.

Опираясь на выше сказанное можно сделать вывод что для лёгких Linux-приложений с ограниченным бюджетом OpenVZ остаётся предпочтительным выбором. Для всего, что требует предсказуемости, изоляции или нестандартной конфигурации, KVM — безальтернативный выбор. Разбираясь в архитектуре системы можно не только сделать правильный выбор, но и понять, как она будет себя вести в критический момент.

Показать полностью
Отличная работа, все прочитано!

Темы

Политика

Теги

Популярные авторы

Сообщества

18+

Теги

Популярные авторы

Сообщества

Игры

Теги

Популярные авторы

Сообщества

Юмор

Теги

Популярные авторы

Сообщества

Отношения

Теги

Популярные авторы

Сообщества

Здоровье

Теги

Популярные авторы

Сообщества

Путешествия

Теги

Популярные авторы

Сообщества

Спорт

Теги

Популярные авторы

Сообщества

Хобби

Теги

Популярные авторы

Сообщества

Сервис

Теги

Популярные авторы

Сообщества

Природа

Теги

Популярные авторы

Сообщества

Бизнес

Теги

Популярные авторы

Сообщества

Транспорт

Теги

Популярные авторы

Сообщества

Общение

Теги

Популярные авторы

Сообщества

Юриспруденция

Теги

Популярные авторы

Сообщества

Наука

Теги

Популярные авторы

Сообщества

IT

Теги

Популярные авторы

Сообщества

Животные

Теги

Популярные авторы

Сообщества

Кино и сериалы

Теги

Популярные авторы

Сообщества

Экономика

Теги

Популярные авторы

Сообщества

Кулинария

Теги

Популярные авторы

Сообщества

История

Теги

Популярные авторы

Сообщества

Недвижимость и ремонт

Теги

Популярные авторы

Сообщества