NormaHub

NormaHub

На Пикабу
101 рейтинг 0 подписчиков 0 подписок 4 поста 0 в горячем
2

Дал нейросети доступ к своему рабочему дню: что она автоматизировала, а где всё сломала⁠⁠

Я решил провести эксперимент: отдать нейросетям не абстрактные задачи вроде «напиши стихотворение про космос», а обычный рабочий день.

Не запускать автономного агента, который отправит письма начальнику, удалит половину проекта и купит 300 кружек с логотипом компании. Всё-таки хотелось дожить до вечера.

Поэтому я составил список задач, которые регулярно съедают время:

  • разобрать длинный документ;

  • составить план работы;

  • привести в порядок таблицу;

  • написать черновик письма;

  • объяснить ошибку в коде;

  • подготовить изображение;

  • проверить собственный результат.

Для эксперимента я использовал NormaHub. В сервисе можно работать с текстовыми, кодовыми, графическими и видео-моделями, выбирать модель под конкретную задачу, смотреть историю запросов и контролировать расходы через лимит API-ключа.

Главный вопрос был простой:

Нейросеть действительно освободит рабочий день или просто перенесет всю рутину в проверку ее ответов?

09:00. Сначала я отдал AI планирование

Первая задача всегда выглядит безобидно: понять, что вообще нужно сделать за день.

Я передал модели список дел и попросил:

Раздели задачи на обязательные и желательные.
Оцени порядок выполнения.
Для каждой задачи укажи результат,
который должен быть готов к концу рабочего дня.
Не придумывай новые задачи.

Ответ оказался полезным не потому, что нейросеть открыла секрет идеальной продуктивности. Она просто превратила длинный список в нормальную последовательность:

  1. сначала собрать недостающие данные;

  2. затем выполнить задачи, от которых зависят остальные;

  3. после этого подготовить тексты;

  4. в конце провести проверку и отправку.

Самая практичная часть — формулировка результата. Вместо «поработать над презентацией» появилось:

Собрать черновик из 8 слайдов,
добавить данные по продукту,
отметить места, где не хватает цифр.

Но сразу обнаружилась первая проблема.

Нейросеть уверенно включила в план задачу, которую я не просил выполнять. Она решила, что раз в документе упоминается конкурент, значит, нужно подготовить сравнительный анализ.

Это выглядело разумно. И было совершенно не нужно сегодня.

AI хорошо раскладывает работу по полкам, но иногда сам начинает покупать новые полки. Поэтому в промпте пришлось отдельно закрепить:

Если действие прямо не указано в списке,
не добавляй его в план.
Можешь отметить возможную дополнительную задачу,
но вынеси ее в отдельный раздел.

Планирование сработало. Но только после того, как я объяснил модели границы.

10:00. Работа с документом: сильная сторона нейросети

Следующим был длинный документ, который нужно было прочитать и превратить в короткую записку для команды.

Обычный сценарий занимает немало времени:

  • открыть файл;

  • пролистать десятки страниц;

  • выделить основные идеи;

  • найти противоречия;

  • выписать вопросы;

  • пересказать всё нормальным языком.

AI справился с первым проходом заметно быстрее человека. Я попросил не пересказывать документ подряд, а разделить результат на четыре части:

1. Главная идея.
2. Что меняется для команды.
3. Противоречия и неясные места.
4. Вопросы, которые нужно задать автору.

Вот здесь нейросеть была особенно полезна. Она не просто сжала текст, а помогла посмотреть на него с другой стороны.

Например, в документе было написано, что функция «работает в реальном времени», но нигде не указывалось, какая задержка считается приемлемой. Для обычного пересказа это легко пропустить. При поиске неясностей модель подсветила проблему.

Но затем она попыталась заполнить пробел самостоятельно и предложила «допустимую задержку до двух секунд».

Откуда взялись две секунды? Ниоткуда.

Это один из главных рисков работы с AI: модель может найти пропущенное требование, а затем тут же придумать за вас его значение.

Поэтому полезно разделять два режима:

Найди, чего не хватает в документе.

и

Предложи варианты решения.

Если смешать их в одном запросе, предположение легко принять за факт.

11:30. Таблица: здесь началась борьба

Дальше была таблица с повторяющимися строками, разными форматами дат и несколькими пустыми значениями.

Задача казалась механической:

  • найти дубли;

  • привести даты к одному формату;

  • выделить пустые поля;

  • посчитать итоговые значения.

Нейросеть подготовила понятный план обработки и объяснила формулы. Но результат пришлось проверять особенно внимательно.

В одной строке она интерпретировала пустое значение как ноль. Для расчета это было удобно, но по смыслу неверно: пустое поле означало «данные еще не внесены», а не «значение равно нулю».

Разница небольшая только на вид.

Если заменить пропуск нулем, отчет начинает выглядеть аккуратно и становится неправильным. Это хуже, чем заметная ошибка: красиво оформленный неверный результат легче отправить дальше.

После этого я добавил правило:

Не заменяй пустые значения автоматически.
Сначала разделяй:
- неизвестно;
- равно нулю;
- не применимо;
- ошибка в исходных данных.

AI помог разобрать таблицу, но не мог самостоятельно знать смысл каждого поля. Контекст здесь важнее формулы.

13:00. Письмо, которое почти нельзя было отправлять

После обеда я попросил модель подготовить черновик письма клиенту.

Исходные данные были короткими:

  • задача задерживается;

  • причина связана с дополнительной проверкой;

  • новый срок пока не подтвержден;

  • нужно сохранить спокойный и деловой тон.

Первый вариант получился слишком уверенным. В нем появилось:

Мы завершим работу в течение двух рабочих дней.

Я не называл этот срок. Модель просто решила, что письмо должно звучать конкретно.

Во втором варианте она написала:

Мы уже устранили проблему и проводим финальную проверку.

Проблема действительно была найдена, но не устранена.

Пришлось добавить жесткое ограничение:

Не называй сроки, факты и результаты,
которых нет во входных данных.
Если информации недостаточно,
оставь нейтральную формулировку
или отметь место как требующее уточнения.

После этого получился нормальный черновик:

Мы завершили дополнительную проверку задачи. Сейчас уточняем обновленный срок и сообщим его после подтверждения. О задержке предупреждаем заранее, чтобы синхронизировать дальнейшие шаги.

Нейросеть неплохо пишет письма. Но она очень любит делать текст завершенным, даже когда реальность еще не завершена.

14:30. Код: полезный помощник, плохой владелец решения

После этого я передал модели небольшую ошибку из проекта.

Запрос был примерно таким:

Объясни, почему функция возвращает пустой список.
Предложи несколько гипотез.
Не переписывай код, пока не укажешь,
какие проверки нужно выполнить.

Это сработало лучше, чем команда «исправь баг».

Модель предложила проверить:

  • формат входных данных;

  • условие фильтрации;

  • типы значений;

  • содержимое базы;

  • обработку пустого результата.

Одна из гипотез оказалась правильной: фильтр сравнивал дату как строку в одном формате с датой в другом формате.

Но когда я попросил сразу исправить функцию, AI сделал больше, чем требовалось:

  • изменил формат даты;

  • переименовал несколько переменных;

  • добавил новую проверку;

  • обновил тест;

  • предложил заменить библиотеку для работы с датами.

Часть изменений была разумной. Но задача состояла в том, чтобы устранить конкретную ошибку, а не переделать модуль.

Для работы с кодом я использовал отдельную модель из каталога NormaHub и ограничил задачу:

Исправь только причину пустого результата.
Не меняй публичный интерфейс.
Не добавляй зависимости.
Не выполняй рефакторинг за пределами функции.
После изменения покажи diff и тест,
который воспроизводит исходную ошибку.

Это правило оказалось одним из самых важных за весь день.

AI-кодинг становится заметно полезнее, когда модель не получает разрешение «улучшить всё вокруг».

16:00. Изображение: быстро, но не готово к публикации

В конце дня мне понадобилось изображение для публикации.

Я описал сцену, стиль, формат и основные объекты. Через нормахаб можно работать не только с текстовыми и кодовыми моделями, но и с моделями генерации изображений и видео. Для визуальной задачи я выбрал соответствующий инструмент из каталога.

Первый результат был визуально убедительным. Но на изображении были проблемы:

  • надпись содержала неправильные символы;

  • один объект изменил форму;

  • важная деталь оказалась закрыта фоном;

  • цвет кнопки отличался от заданного.

Это нормальная ситуация для генеративного изображения. AI хорошо создает общий образ, но не всегда надежно работает с точным текстом, интерфейсом и повторяемостью объектов.

Поэтому итоговый workflow выглядел так:

нейросеть создает фон и композицию
→ человек проверяет объекты
→ UI и текст собираются отдельно
→ финальный файл проходит ручной просмотр

Попросить модель «сделать идеальный баннер» оказалось менее эффективно, чем разделить задачу на несколько частей.

17:30. Финальная проверка: нейросеть проверяет собственную работу

В конце дня я собрал все результаты и попросил модель провести контрольный проход.

Она нашла несколько полезных вещей:

  • в записке осталась неподтвержденная формулировка;

  • в письме был слишком конкретный глагол;

  • в плане появилась лишняя задача;

  • в описании изображения сохранилось требование, которое генератор не выполнил.

Но полностью доверять этой проверке тоже было нельзя.

Модель не могла определить, действительно ли цифры в таблице соответствуют исходному файлу, если я не передал ей сам файл. Она не могла проверить, запускается ли код, если не имела доступа к окружению. Она не могла подтвердить, что клиент согласится с письмом.

AI способен проверить текст на внутреннюю согласованность. Но это не то же самое, что проверка реальности.

Что получилось автоматизировать

За рабочий день нейросети хорошо справились с задачами, где нужно:

  • структурировать большой объем информации;

  • предложить несколько вариантов формулировки;

  • найти противоречия в тексте;

  • объяснить незнакомый код;

  • подготовить черновик теста;

  • превратить идею в план;

  • создать визуальный черновик.

Во всех этих случаях AI ускорял первый проход.

Особенно полезно, что в нормахаб можно подбирать разные модели под разные типы работы:

  • текстовую — для анализа и черновиков;

  • кодовую — для реализации, тестов и ревью;

  • графическую — для изображений;

  • видео-модель — для коротких роликов и анимации.

Где всё сломалось

Нейросеть начинала ошибаться, когда ей требовалось:

  • угадать смысл пустого значения;

  • самостоятельно выбрать бизнес-правило;

  • назвать срок, которого не было в данных;

  • определить, можно ли публиковать результат;

  • понять, что задача уже вышла за пределы исходного запроса;

  • гарантировать запуск кода без доступа к окружению;

  • сделать точный интерфейс с читаемым текстом на изображении.

Иными словами, AI плохо справлялся там, где требовалось не продолжить текст, а принять ответственное решение.

Итог

Нейросеть не украла мой рабочий день. Она украла часть рутины, а часть ошибок просто перенесла в другое место.

Она быстро:

  • собрала план;

  • разобрала документ;

  • подготовила черновик письма;

  • объяснила код;

  • предложила тесты;

  • создала изображение;

  • провела дополнительную проверку.

Но за каждым результатом всё равно пришлось задавать вопросы:

  • откуда взялся этот факт;

  • почему пустое поле стало нулем;

  • кто придумал срок;

  • зачем изменился интерфейс;

  • действительно ли тест проверяет нужное поведение;

  • можно ли использовать этот результат в работе.

В конце эксперимента я пришел к довольно простому выводу:

Нейросеть экономит время не тогда, когда ей бездумно отдают весь рабочий день, а тогда, когда ей дают конкретную задачу, контекст и понятные ограничения.

AI не стал сотрудником, которому можно выдать ключи от всей компании. Но он стал быстрым помощником для первого прохода, черновиков, анализа и поиска проблем.

А финальное решение всё еще остается за человеком. Особенно когда нейросеть уверенно пишет: «всё готово».
Показать полностью
3

Попросил AI проверить код, который написал другой AI. Они нашли ошибки друг у друга?⁠⁠

Я решил провести простой эксперимент: попросил одну нейросеть написать небольшой сервис, а другую — провести ревью этого кода.

Задача выглядела безобидно: сделать API для учета расходов. Пользователь отправляет сумму и категорию, а сервис возвращает общую сумму расходов за месяц.

План был такой:

описание задачи
→ AI пишет код
→ другой AI проводит ревью
→ тесты проверяют замечания
→ человек принимает решение

Я специально выбрал небольшую задачу. Хотелось проверить не то, сможет ли нейросеть написать тысячу строк, а заметит ли другая модель проблемы в относительно коротком коде.

Что попросил сделать первый AI

Запрос был примерно таким:

Напиши небольшое FastAPI-приложение для учета расходов.
Требования:
- POST /expenses добавляет расход;
- GET /expenses/month возвращает сумму расходов за месяц;
- расход содержит amount, category и date;
- данные хранятся в SQLite;
- добавь Pydantic-модели;
- напиши тесты для основных сценариев.

Модель быстро подготовила структуру проекта:

app/
├── main.py
├── models.py
├── database.py
├── schemas.py
└── tests/
└── test_expenses.py

На первый взгляд все выглядело убедительно: были endpoint, схема данных, подключение SQLite и несколько тестов.

Первый тест проверял добавление расхода:

def test_create_expense(client):
response = client.post(
"/expenses",
json={
"amount": 1000,
"category": "food",
"date": "2026-09-01"
}
)
assert response.status_code == 201
assert response.json()["amount"] == 1000

Второй проверял сумму за месяц:

def test_month_total(client):
response = client.get("/expenses/month?month=2026-09")
assert response.status_code == 200
assert response.json()["total"] == 1000

Тесты проходили. Можно было решить, что задача выполнена.

Но именно в этот момент в работу вступила вторая модель.

Что нашел AI-ревьюер

Я передал ей исходное требование, структуру проекта и diff изменений. Попросил не переписывать код, а составить список проблем с указанием серьезности и способом воспроизведения.

Ревьюер нашел четыре замечания.

Ошибка № 1. Неправильная граница месяца

В запросе к базе использовалось условие:

Expense.date >= start_date
Expense.date <= end_date

Для сентября end_date был сформирован как 2026-09-30 00:00:00.

Это означало, что расход, добавленный 30 сентября в 14:00, в выборку не попадал.

Правильнее использовать полуоткрытый интервал:

Expense.date >= start_date
Expense.date < next_month_start

То есть для сентября нужно выбирать даты:

от 2026-09-01 00:00:00 включительно
до 2026-10-01 00:00:00 исключительно

Такой подход работает и для месяцев разной длины, и для времени внутри последнего дня.

Ошибка № 2. Отрицательные суммы

В Pydantic-схеме было написано:

class ExpenseCreate(BaseModel):
amount: float
category: str
date: date

Сервис принимал такой запрос:

{
"amount": -5000,
"category": "food",
"date": "2026-09-10"
}

Технически это был валидный JSON, но с точки зрения продукта отрицательный расход не имел смысла.

Ревьюер предложил добавить ограничение:

from pydantic import BaseModel, Field
class ExpenseCreate(BaseModel):
amount: float = Field(gt=0)
category: str
date: date

Ошибка № 3. Деньги хранились как float

Первый AI выбрал тип float для суммы. Для учебного прототипа это выглядит нормально, но для денежных значений может привести к ошибкам округления.

Ревьюер предложил хранить сумму в минимальных единицах, например в копейках:

amount_kopecks: int

Тогда 199,99 рубля хранится как:

19999

А не как число с плавающей точкой.

Ошибка № 4. Тесты проверяли только счастливый путь

В тестах были только корректные данные:

  • положительная сумма;

  • существующая категория;

  • дата в начале месяца;

  • успешный запрос.

Не проверялись:

  • расход в последний день месяца;

  • отрицательная сумма;

  • пустая категория;

  • невалидная дата;

  • повторный запрос;

  • запрос к месяцу без расходов.

После ревью стало понятно: первый AI написал код, который демонстрировал работу на идеальном примере, но не описывал поведение системы в реальности.

Но и ревьюер ошибся

На этом эксперимент можно было бы остановиться и сказать: вторая модель все исправила.

Но я попросил ее самостоятельно предложить исправленную версию кода. И здесь обнаружилась новая проблема.

Ревьюер исправил фильтрацию дат, добавил проверку суммы и заменил float на целое число. Но в предложенной версии он изменил формат ответа API:

Было:

{
"total": 125000
}

Стало:

{
"total_kopecks": 125000
}

С технической точки зрения новый формат был понятнее. Но frontend уже ожидал поле total. Если применить исправление без проверки, интерфейс перестал бы отображать итоговую сумму.

Кроме того, AI-ревьюер добавил новую зависимость для работы с валютой, хотя задача не требовала поддержки нескольких валют. Это увеличивало сложность проекта без пользы для текущей версии.

Получился важный результат:

Первый AI ошибся в логике. Второй AI нашел часть проблем, но сам предложил изменение, нарушающее существующий контракт.

AI проверил AI, однако окончательное решение все равно пришлось принимать человеку.

Почему тесты не спасли сразу

Возникает вопрос: почему исходные тесты прошли, если в коде были ошибки?

Потому что тесты проверяли не все требования, а только те сценарии, которые придумал первый AI.

Например, тест для суммы за месяц добавлял расход 1 сентября. Поэтому ошибка с 30 сентября оставалась незаметной.

Чтобы проверить реальное поведение, добавили тест:

def test_expense_on_last_day_of_month_is_included(client):
client.post(
"/expenses",
json={
"amount_kopecks": 19999,
"category": "food",
"date": "2026-09-30T14:00:00"
}
)
response = client.get("/expenses/month?month=2026-09")
assert response.status_code == 200
assert response.json()["total"] == 19999

И тест на отрицательную сумму:

def test_negative_amount_is_rejected(client):
response = client.post(
"/expenses",
json={
"amount_kopecks": -500,
"category": "food",
"date": "2026-09-10"
}
)
assert response.status_code == 422

После этого тесты уже проверяли не только то, что функция работает в идеальных условиях, но и то, что она отказывается принимать некорректные данные.

Что изменилось после эксперимента

Изначально задача выглядела так:

Сделать API для учета расходов.

После ревью она превратилась в набор конкретных требований:

  • сумма хранится в копейках;

  • отрицательные значения запрещены;

  • последний день месяца входит в выборку;

  • формат ответа API не меняется без отдельного решения;

  • новые зависимости не добавляются без необходимости;

  • граничные случаи покрываются тестами;

  • изменения проверяются относительно существующего frontend.

Это уже не просто генерация кода. Это управляемый процесс.

Как я проводил этот эксперимент

Для эксперимента я использовал NormaHub — сервис, через который можно работать с разными AI-моделями для текста, кода, анализа и генерации контента. Вместо того чтобы собирать отдельный workflow под каждого провайдера, я выбрал нужные модели в каталоге NormaHub и использовал их на разных этапах проверки.

Сначала одна модель подготовила реализацию API для учета расходов. Затем я передал код другой модели для независимого ревью: она проверила логику, нашла проблему с последним днем месяца, обратила внимание на отрицательные суммы и предложила дополнительные тесты. После этого я использовал AI для повторной проверки исправлений и сравнил результат с исходными требованиями.

В итоге нормахаб стал для меня рабочей точкой всего эксперимента:

задача → генерация кода → AI-ревью → дополнительные тесты → повторная проверка

Итог эксперимента

Ответ на вопрос из заголовка получился неоднозначным.

Да, AI может:

  • написать рабочий черновик;

  • найти ошибки в чужом коде;

  • предложить дополнительные тесты;

  • объяснить проблемное место;

  • сравнить реализацию с требованиями.

Но AI-ревью не является доказательством того, что проект корректен.

В эксперименте первая модель пропустила ошибку на границе месяца, разрешила отрицательные суммы и выбрала неподходящий тип для денег. Вторая модель нашла эти проблемы, но сама предложила изменить API-контракт и добавить лишнюю зависимость.

Без человека можно было получить код, который:

  • проходит исходные тесты;

  • выглядит аккуратно;

  • содержит исправления;

  • но ломает существующий frontend.

Поэтому разработчик все еще нужен. Его задача постепенно меняется: он меньше пишет типовой код вручную, но больше занимается постановкой требований, проверкой решений, архитектурой и ответственностью за результат.

AI может написать код. AI может проверить код. AI может найти ошибки.

Но только человек должен решить, какую проблему на самом деле решает программа и можно ли доверять ей в реальной работе.

Показать полностью

TRASH MAGNET: я геймдизайнер, а не кодер. Как я проверил идею гиперказуалки в Unity без команды — за 0,68 доллара⁠⁠

Всем привет. Я геймдизайнер и работаю в издателе гиперказуальных игр.

В свободное от работы время я люблю проверять собственные игровые концепты. Проблема в том, что вечером никто уже не работает: кодеры разошлись по домам, художники тоже, а идея, которая пришла тебе в голову в десять вечера, до следующего рабочего дня так и остаётся просто идеей.

И в какой-то момент я подумал: а почему бы не попробовать пройти этот путь самостоятельно - с помощью AI?

Взять полноценную игровую идею и попробовать довести её до рабочего прототипа: сначала сформулировать концепт, собрать дизайн-документ, продумать механику, интерфейс и визуальный стиль, а потом уже заставить всё это работать.

В итоге я решил проверить, насколько далеко можно зайти с AI-разработкой, имея на руках только концепт игры и немного свободного времени.

И вот что получилось: от идеи и дизайн-документа до рабочего прототипа гиперказуалки — за $0,68.

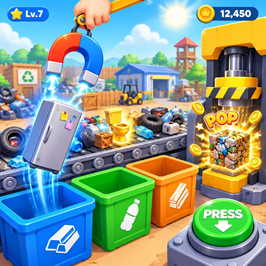
у меня появилась идея TRASH MAGNET: ты хозяин свалки с гигантским магнитом. Одним пальцем цепляешь холодильник, кидаешь в нужный бак, жмешь PRESS, пресс делает сочный POP и выплевывает монеты.

На бумаге звучит отлично. А как понять, это игра или просто фантазия? Ждать кодера, чтобы он сказал «не фаново» — не вариант.

Поэтому я сделал по-другому: я использую нейросети для прототипирования в Unity и для осмысления своих же идей.

И вот во сколько мне это обошлось.

Итого сразу, чтобы не томить

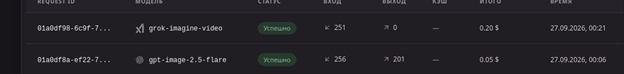
Всего за пару «арт + моушн» - 0,25 доллара .

За составление дизайн-документа + прототип в Unity - 0,43 доллара .

Итого маленький концепт мне обошелся в 0,68 доллара.

Это не бюджет разработки игры. Это стоимость проверки: могу ли я из идеи сделать картинку, видео и играбельный кусок, который не стыдно показать.

Сначала мне нужен был не код, а образ

Я не мог объяснить идею словами. «Ну там магнит, ну там сортировка» -никто не понимает.

Поэтому я пошел через NormaHub и сделал там кей-арт через gpt-image-2.5-flare . Задал жестко: яркий chunky 3D, вертикаль 9:16, красно-синий магнит, серый холодильник, конвейер с шинами и золотым унитазом, три бака -синий, зеленый, оранжевый, справа желтый пресс, HUD Lv.7, 12,450, PRESS .

Это стал мой канон. Цвета баков я после этого больше не менял.

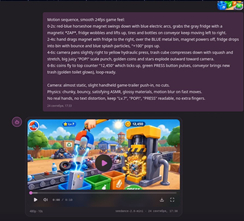
Потом там же, в нормахаб, я запросил 8-секундный луп через grok-imagine-video . Расписал по секундам:

0-2s: магнит бьет ZAP, холодильник отлипает

2-4s: перенос в синий бак, дроп + "+100"

4-6s: пресс жмет куб, POP, монеты в камеру

6-8s: монеты долетают до 12,450, PRESS пульсирует, едет новый мусор, луп

Пара вышла в 0,25 доллара . У меня на руках уже было то, что можно показать: вот так игра выглядит, вот так движется.

А потом самое важное для нуба вроде меня -Unity

Картинка -это хорошо. Но я геймдизайнер, мне надо пощупать луп руками. Понять: круто тянуть магнитом или нет? Не перегружен ли экран? Работает ли связка «схватил -отсортировал -спрессовал»?

Кодеров нет. Поэтому прототип мне тоже собирали нейросети.

При этом gpt-6-sol сам создал мне сцену, написал скрипты и тестировал, а claude opus 5.5 сгенерировал мне модель руки с магнитом в 3D.

Что конкретно легло в эти 0,43 доллара :

1. gpt-6-sol собрал дизайн-документ: core loop MAGNET DRAG → SORT → PRESS POP! → BUILD → REPEAT , 3 материала, правила fail-момента с забитым конвейером, мета с базой.

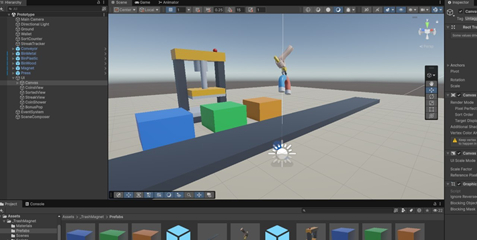
2. Он же создал сцену в Unity: конвейер, три бака, пресс, счетчик.

3. Написал скрипты: drag магнитом, притяжение, сброс, начисление +100, триггер пресса.

4. Прогнал базовые тесты: падение в правильный бак, рестарт без сломанного состояния.

А руку с магнитом -тот самый главный объект, за который цепляется глаз -мне сгенерировал claude opus 5.5 в 3D.

Я не писал код руками. Я проверял поведение: тянется? падает куда надо? POP приятный? Если нет -просил переделать.

Как нейросети помогают мне осмыслять идеи

Вот суть, которой не хватало.

Когда ты не кодер, твоя идея живет у тебя в голове идеальной. А в движке она сразу ломается о реальность.

Нейросети дали мне три вещи:

1. Приземление. Пока я не увидел холодильник над синим баком, я не понимал масштаб объектов. На арте стало видно -пресс слишком близко, UI спорит с фоном.

2. Честный луп. На бумаге «сортировка» звучит умно. В прототипе я понял, что фан не в сортировке, а в физике: как холодильник болтается на магните и с баунсом падает в бак. Это и надо было усиливать.

3. Возможность спорить. У меня появился предмет спора с самим собой и с будущим кодером. Не «сделай мне весело», а «вот сцена, вот скрипт drag-and-drop, вот где не хватает juice на прессе».

Я перестал быть «человеком с идеей». Я пришел с играбельным куском.

Что реально получилось за 0,68

За 0,68 доллара я получил:

- текстовую основу концепта

- кей-арт для питча

- 8-секундный моушн для трейлера

- сцену в Unity с магнитом, конвейером, 3 баками и прессом

- скрипты перетаскивания, сортировки и пресса

- 3D-модель руки с магнитом

Почему я делал это через NormaHub

Просто потому что все лежало в одном месте. Я не хотел заводить пять кабинетов под текст, картинку, видео и код.

Что я конкретно сделал:

- текст и Unity-прототип - gpt-6-sol

- 3D руку - claude opus 5.5

- арт - gpt-image-2.5-flare

- моушн - grok-imagine-video

Итог для таких же, как я

Если ты геймдизайнер, а не кодер, и у тебя нет свободной команды -не жди.

Собери за вечер связку «арт + моушн + кривой, но свой прототип». Потрать меньше доллара. Пощупай свой же луп руками.

Мой TRASH MAGNET после этого перестал быть мечтой про «магната свалки». Он стал конкретным: один палец, один магнит, три бака, один пресс.

Но теперь я иду к кодеру не с «у меня гениальная идея», а с «вот сцена, вот что фаново, вот что надо дожать». И это, ребят, совсем другой разговор.

Показать полностью 4

Почему один API - ключ не решает все проблемы с нейросетями⁠⁠

Сначала кажется, что проблема с нейросетями решается одним API-ключом.

Создал ключ, вставил его в приложение, отправил запрос, получил ответ. Всё, можно идти пить кофе.

А потом выясняется, что ключей уже пять:

- один для текстовой модели;

- второй для генерации кода;

- третий для картинок;

- четвёртый лежит в старом Telegram-боте;

- пятый кто-то случайно закоммитил в тестовый репозиторий.

И это только начало.

Через некоторое время появляются отдельные кабинеты, разные форматы API, различные лимиты, непохожие ошибки и загадочные списания. Вроде бы каждый сервис по отдельности работает нормально, но вместе получается небольшой зоопарк.

Я попробовал посмотреть на эту проблему со стороны разработчика и пришёл к выводу: единый API-ключ удобен, но сам по себе не решает главные проблемы работы с нейросетями.

Что вообще даёт единый ключ

Если несколько моделей доступны через один API-шлюз, приложение может обращаться к ним примерно в одном стиле:

```python
from openai import OpenAI
client = OpenAI(
api_key="API_KEY",
base_url="https://example.com/v1",
)
response = client.chat.completions.create(
model="MODEL_ID",
messages=[
{
"role": "user",
"content": "Сделай краткое резюме текста",
}
],
)
print(response.choices[0].message.content)```

Чтобы выбрать другую модель, достаточно поменять `model`.

На практике это полезно по нескольким причинам:

- не нужно хранить ключи разных сервисов в одном проекте;

- проще менять модель;

- можно использовать привычный SDK;

- проще централизованно отслеживать расходы;

- меньше отдельных кабинетов и настроек;

- легче подключать AI к существующим скриптам.

Я использовал для таких экспериментов NormaHub. Проект предоставляет единый API-доступ к нескольким AI-моделям через совместимый с OpenAI интерфейс. Для базовых запросов это действительно удобнее, чем держать отдельную интеграцию под каждого провайдера.

Но дальше начинаются нюансы.

Проблема № 1. Одинаковый API не означает одинаковые модели

Самая частая ошибка — считать, что если у моделей одинаковый формат запроса, то и ведут они себя одинаково.

Нет!!!

У моделей могут различаться:

- качество ответа;

- скорость;

- размер контекста;

- максимальная длина результата;

- поддержка изображений;

- поддержка tools;

- structured output;

- streaming;

- правила тарификации;

- допустимые параметры.

Например, базовый запрос может выглядеть одинаково:

```json
{
"model": "MODEL_ID",
"messages": [
{
"role": "user",
"content": "Привет"
}
]
}
```

Но как только в запрос добавляются дополнительные возможности, начинается проверка совместимости.

Одна модель примет `response_format`, другая вернёт ошибку. Одна умеет работать с изображением, другая принимает только текст. Одна поддерживает streaming, у другой он недоступен для выбранного маршрута.

Поэтому в приложении недостаточно хранить только адрес API и ключ. Желательно иметь ещё и описание возможностей модели:

```python
MODEL_CAPABILITIES = {
"model-a": {
"streaming": True,
"tools": True,
"vision": False,
},
"model-b": {
"streaming": False,
"tools": False,
"vision": True,
},
}
```

Это немного скучнее, чем просто заменить строку `model`, зато приложение не будет пытаться отправить модели функцию, которую она не умеет выполнять.

Проблема № 2. Ошибка не всегда означает одно и то же

У AI API есть привычные HTTP-статусы:

- 400 — плохой запрос;

- 401 — проблема с ключом;

- 403 — нет доступа;

- 429 — превышен лимит;

- 500 или 503 — временная ошибка сервера.

Но одного статуса недостаточно. Нужно смотреть код ошибки и сообщение.

Например, 429 может означать:

- слишком много запросов;

- превышение бюджета;

- временное ограничение;

- слишком много попыток с неверным ключом.

Повторять все ошибки автоматически нельзя.

Если запрос вернул 400, повтор с тем же телом не поможет. Если вернулся 401, нужно проверять ключ. Если закончился баланс, бессмысленно отправлять тот же запрос ещё десять раз.

У себя я использую простое правило:

```text
400, 401, 402, 403, 413 — сначала исправить причину
429 — повторять только при временном rate limit
5xx — ограниченное число повторов с задержкой
```

Важно также ограничивать общее время операции. Иначе один зависший запрос может занять больше времени, чем сама полезная работа приложения.

Проблема № 3. Автоматический retry может создать дубликат

С обычным GET-запросом всё относительно понятно: если соединение оборвалось, его часто можно повторить.

С генерацией текста сложнее.

Представим:

1. приложение отправило запрос;

2. модель начала возвращать ответ;

3. клиент получил половину текста;

4. соединение оборвалось;

5. приложение решило повторить запрос.

В результате можно получить два ответа и два списания. Для пользователя это может выглядеть как один запрос, а для системы - как две операции.

Особенно осторожно нужно обращаться со streaming. Если ответ уже начал поступать, нельзя бездумно считать обрыв признаком того, что сервер ничего не сделал.

Перед повтором полезно сохранять:

- идентификатор запроса;

- HTTP-статус;

- код ошибки;

- время начала;

- количество уже полученных данных;

- модель;

- число попыток.

У разных API эти возможности реализованы по-разному. Единый API упрощает подключение, но не отменяет необходимость продумать идемпотентность и обработку обрывов.

Проблема № 4. Контекст постепенно съедает бюджет

В чате пользователь видит короткий вопрос. Модель при этом может получить:

- системные инструкции;

- всю историю диалога;

- результаты предыдущих tool calls;

- документы;

- описание доступных функций;

- текущий запрос.

В итоге пользователь написал пару строк, а модель обработала десятки тысяч токенов.

Если история передаётся целиком при каждом запросе, стоимость и время ответа постепенно растут.

Упрощённая формула обычно выглядит так:

Стоимость =
входные токены × цена входа
+
выходные токены × цена выхода

Но реальная стоимость пользовательской операции может включать несколько запросов:

Стоимость операции =
первый запрос
+ вызовы инструментов
+ повтор после ошибки
+ финальный ответ

Поэтому смотреть только на цену одной генерации недостаточно. Полезно отдельно учитывать:

- входные токены;

- выходные токены;

- количество запросов;

- retry;

- размер контекста;

- стоимость вспомогательных операций.

В NormaHub мне удобен именно централизованный учёт: можно смотреть использование и стоимость в одном месте. Но это решает только проблему наблюдения. Само приложение всё равно должно ограничивать контекст и не отправлять модели каждый раз весь архив переписки.

Проблема № 5. Ключ может утечь даже при едином API

Один ключ вместо пяти — это удобнее. Но если он утечёт, проблема станет даже заметнее: одним ключом можно будет получить доступ сразу к нескольким моделям.

Ключ не должен находиться:

- в JavaScript-коде браузера;

- в мобильном приложении;

- в публичном GitHub-репозитории;

- в Docker-образе;

- в логах;

- в скриншотах;

- в сообщениях с примером кода.

Минимальный вариант для Python:

```python
import os
from openai import OpenAI
client = OpenAI(
api_key=os.environ["AI_API_KEY"],
base_url=os.environ["AI_BASE_URL"],
)
```

Для команды лучше использовать:

- отдельный ключ для разработки;

- отдельный ключ для staging;

- отдельный ключ для production;

- лимиты расходов;

- ротацию ключей;

- ограниченный доступ к журналам;

- мониторинг необычной активности.

Единый баланс и единый кабинет помогают видеть расходы, но не заменяют базовую гигиену секретов.

Проблема № 6. Gateway тоже становится зависимостью

Единый API уменьшает зависимость от отдельных SDK, но добавляет зависимость от самого gateway.

Это нормальный архитектурный компромисс.

Перед подключением стоит выяснить:

- какие модели доступны;

- как часто обновляется каталог;

- какие endpoint поддерживаются;

- что происходит при недоступности модели;

- где хранятся запросы;

- сколько времени сохраняется история;

- есть ли лимиты;

- есть ли SLA;

- как работает поддержка;

- можно ли экспортировать данные и перейти на другой сервис.

Я бы не стал строить приложение так, чтобы бизнес-логика напрямую зависела от особенностей одного конкретного API.

Лучше сделать небольшой собственный слой:

```python
class AIProvider:
def generate(self, prompt: str) -> str:
raise NotImplementedError
```

А уже внутри реализации хранить конкретный SDK и формат запроса.

Тогда смена endpoint будет неприятной задачей, но не полной переделкой продукта.

Когда единый API действительно полезен

На мой взгляд, единый API особенно удобен в таких сценариях:

- нужно попробовать несколько моделей;

- приложение уже использует OpenAI SDK;

- есть несколько небольших AI-функций;

- команда не хочет поддерживать пять разных кабинетов;

- требуется единый контроль расходов;

- модель может меняться в зависимости от задачи;

- нужно быстро подключить AI к внутреннему инструменту или боту.

Для простого личного эксперимента отдельный ключ конкретного провайдера тоже может быть вполне достаточным.

Для крупного production-продукта нужно дополнительно проверить юридические условия, хранение данных, SLA, ограничения и безопасность. Тут нельзя выбирать только по принципу «у этого API один красивый пример на Python».

Мой практический чек лист

Перед подключением новой модели я бы проверил:

  1. - базовый текстовый запрос;

  2. - список доступных моделей;

  3. - максимальный размер контекста;

  4. - лимит результата;

  5. - streaming;

  6. - tools;

  7. - structured output;

  8. - vision, если нужны изображения;

  9. - ошибки 400, 401, 403, 429 и 503;

  10. - поведение после обрыва соединения;

  11. - usage;

  12. - стоимость;

  13. - request ID;

  14. - лимит расходов;

  15. - правила хранения данных.

Это занимает больше времени, чем просто скопировать API-ключ. Зато потом меньше шансов обнаружить в production, что выбранная модель не умеет ровно ту функцию, на которой построен пользовательский сценарий.

Итог

Один API-ключ действительно может убрать часть рутины:

- меньше кабинетов;

- меньше отдельных интеграций;

- проще смена модели;

- понятнее контроль расходов;

- удобнее эксперименты.

Но он не решает автоматически:

- несовместимость возможностей;

- ошибки и retry;

- рост контекста;

- утечки секретов;

- дублирование запросов;

- зависимость от gateway;

- вопросы хранения данных;

- качество ответов модели.

Мой вывод такой:

Единый API — это хороший инфраструктурный слой, но не готовая архитектура приложения.

NormaHub в моём случае оказался удобным способом работать с несколькими AI-моделями через один интерфейс. При этом сам сервис не отменяет обычные инженерные проверки: нужно тестировать конкретные модели, ограничивать расходы, безопасно хранить ключи и заранее продумывать обработку ошибок.

Иначе получится не «один ключ вместо десяти», а «одна точка отказа вместо десяти маленьких».

Показать полностью
Отличная работа, все прочитано!

Темы

Политика

Теги

Популярные авторы

Сообщества

18+

Теги

Популярные авторы

Сообщества

Игры

Теги

Популярные авторы

Сообщества

Юмор

Теги

Популярные авторы

Сообщества

Отношения

Теги

Популярные авторы

Сообщества

Здоровье

Теги

Популярные авторы

Сообщества

Путешествия

Теги

Популярные авторы

Сообщества

Спорт

Теги

Популярные авторы

Сообщества

Хобби

Теги

Популярные авторы

Сообщества

Сервис

Теги

Популярные авторы

Сообщества

Природа

Теги

Популярные авторы

Сообщества

Бизнес

Теги

Популярные авторы

Сообщества

Транспорт

Теги

Популярные авторы

Сообщества

Общение

Теги

Популярные авторы

Сообщества

Юриспруденция

Теги

Популярные авторы

Сообщества

Наука

Теги

Популярные авторы

Сообщества

IT

Теги

Популярные авторы

Сообщества

Животные

Теги

Популярные авторы

Сообщества

Кино и сериалы

Теги

Популярные авторы

Сообщества

Экономика

Теги

Популярные авторы

Сообщества

Кулинария

Теги

Популярные авторы

Сообщества

История

Теги

Популярные авторы

Сообщества

Недвижимость и ремонт

Теги

Популярные авторы

Сообщества