
Почему самая большая нейросеть — не всегда лучшая: результаты тестирования 15 open-source LLM

При выборе языковой модели для бизнеса легко попасть в ловушку простой логики: чем больше параметров, тем лучше результат.
На практике такой подход может привести к неоправданным затратам на оборудование, более медленной работе системы и усложнению локального развёртывания. При этом крупная модель далеко не всегда оказывается сильнее компактной именно в тех задачах, ради которых компания внедряет искусственный интеллект.
Особенно заметна эта проблема в профессиональных областях. Модель может уверенно отвечать на общие вопросы, но заметно хуже справляться с правом, медициной, финансами, энергетикой или закупками.
Чтобы проверить, насколько современные open-source модели готовы к реальной отраслевой работе, команда R&D.Pro провела сравнительное исследование 15 больших языковых моделей размерностью от 8 до 120 млрд параметров.
Почему обычных рейтингов LLM недостаточно
Большинство популярных бенчмарков проверяет языковые модели на англоязычных заданиях общего характера: знании фактов, логике, понимании текста и способности продолжить заданную последовательность.
Такие тесты помогают сравнить базовые возможности моделей, но не дают ответа на главный вопрос бизнеса:
Насколько хорошо конкретная модель справится с профессиональными задачами нашей компании?
Например, высокий результат в общем рейтинге ещё не означает, что модель будет одинаково хорошо разбираться в бухгалтерском учёте, нормативных требованиях, медицинской документации и производственных процессах.
Кроме того, многие публичные рейтинги не учитывают:
различия между профессиональными областями;
устойчивость модели при усложнении вопросов;
влияние настроек генерации;
возможность локального запуска;
соотношение качества и вычислительных затрат.
Поэтому для исследования был разработан собственный русскоязычный многодоменный бенчмарк, ориентированный не на общие знания, а на реальные профессиональные задачи.
Как было устроено исследование
В тестировании участвовали 15 open-source LLM и 16 конфигураций — одна из моделей запускалась в двух вариантах квантизации.
Размер моделей составлял от 8 до 120 млрд параметров. В исследование вошли представители семейств Qwen, Gemma, GPT-OSS, GLM, Phi, Nemotron, Mistral и других.
Для проверки был сформирован набор из 1 440 вопросов, охватывающий 16 профессиональных направлений:
энергетика;
право;
финансы;
клинические процессы здравоохранения;
терапевтическая практика;
фармацевтика;
строительство;
DevOps;
логистика;
маркетинг;
HR;
охрана труда;
сельское хозяйство;
продажи;
закупки и тендеры;
производственный инжиниринг.
Для каждого направления подготовили по 90 вопросов: 30 базовых, 30 продвинутых и 30 экспертных.
Такой подход позволил оценить не только общий уровень модели, но и то, насколько сильно ухудшается качество её ответов по мере усложнения профессиональной задачи.
Как оценивались ответы
Один из самых сложных вопросов при тестировании нейросетей — кто и как должен определять правильность ответа.
В исследовании использовалась двухэтапная система.
Сначала ответы оценивали три независимые модели-судьи:
GLM-4.7-Flash;
DeepSeek-V4-Flash;
GPT-OSS-120B.
Каждый ответ сравнивался с эталонным по десятибалльной шкале. При этом названия тестируемых моделей были скрыты от судей: ответы передавались в обезличенном виде.
После автоматической проверки проводилась независимая экспертная верификация специалистами-практиками соответствующих направлений. Эксперты проверяли корректность самих вопросов, оценивали ответы моделей и сопоставляли свои выводы с результатами автоматических судей.
Важно, что авторы исследования не скрывают ограничений методики. Экспертная верификация носила качественный характер: формальные коэффициенты статистического согласия в этой работе не рассчитывались. Поэтому результаты используются как практическая доказательная база, а не как утверждение об абсолютном превосходстве одной модели над всеми остальными.
Результат первый: размер модели больше не определяет качество
Главный вывод исследования — современные компактные модели способны показывать результат, сопоставимый с гораздо более крупными системами.
Наивысший взвешенный балл получила Qwen3.5-27B:
Qwen3.5-27B — 9,33 балла;
Gemma-4-31B — 9,28 балла;
GPT-OSS-120B — 9,28 балла;
Gemma-4-26B-A4B — 9,27 балла.
Таким образом, модели размерностью 26–31 млрд параметров оказались в одной группе с моделью на 120 млрд параметров.

Зависимость итогового балла от размера модели. Количество параметров само по себе не гарантирует более высокого результата. Источник: исследование Э. Р. Панкратова и А. Б. Якимова.
Разрыв между четырьмя лидерами составил не более 0,06 балла. Он сопоставим с возможной погрешностью оценки, поэтому говорить о статистически подтверждённом превосходстве одной модели внутри этой группы было бы некорректно.
Но практический вывод очевиден: для получения высокого качества бизнесу не всегда требуется самая крупная и ресурсоёмкая LLM.
Результат второй: важен не лучший ответ, а устойчивость
Модель может хорошо отвечать на простые вопросы, но резко терять качество при переходе к экспертным задачам.
Для корпоративного применения это особенно опасно. На базовом запросе ошибка может быть заметна сразу, а сложный профессиональный ответ нередко звучит убедительно даже тогда, когда содержит неточности.
Наиболее устойчивыми к усложнению вопросов оказались:
Gemma-4-31B — снижение на 0,21 балла;
Qwen3.5-27B — на 0,22;
Qwen3.5-9B — на 0,23;
Gemma-4-26B-A4B — на 0,26.
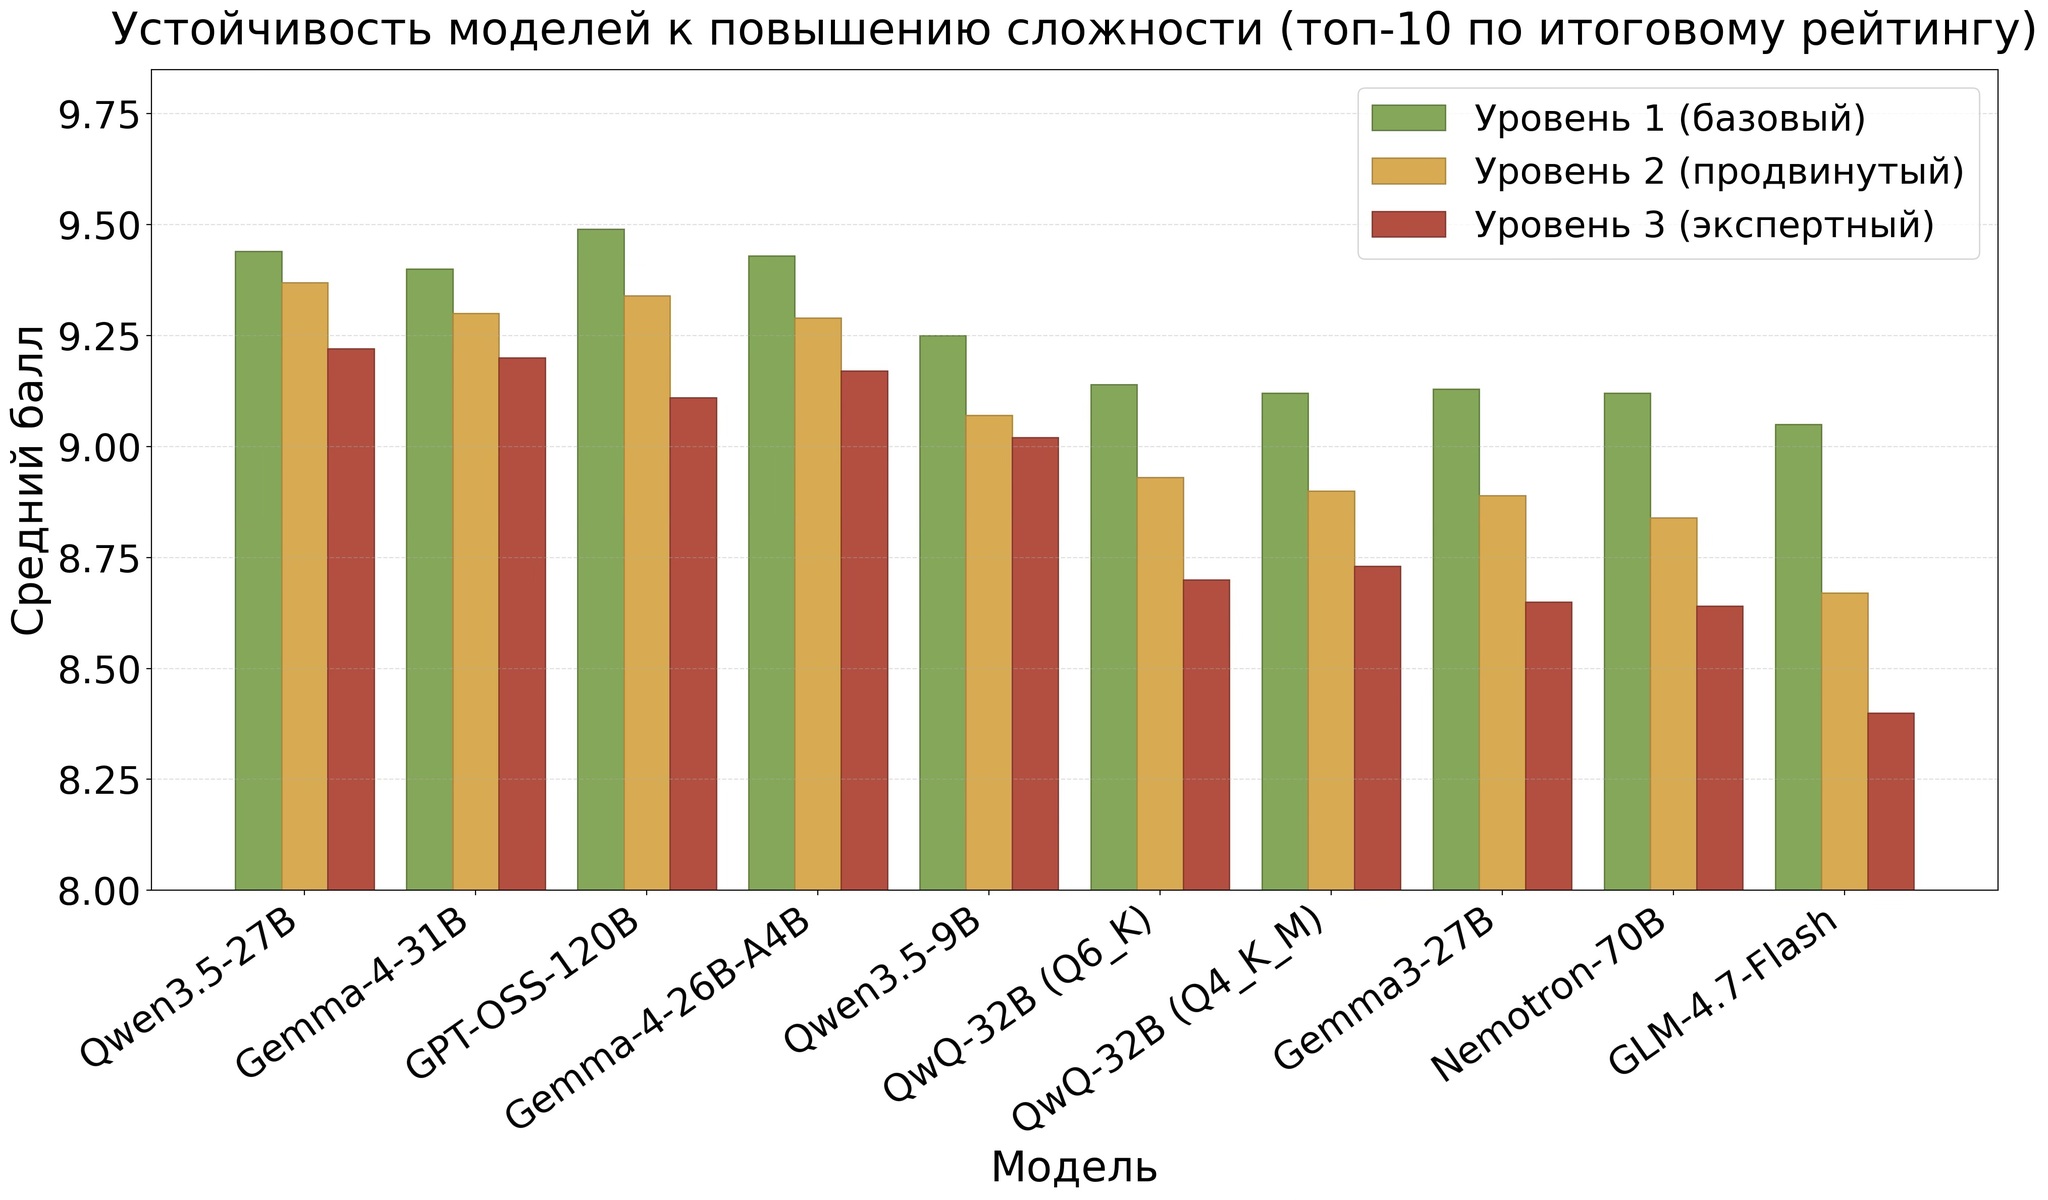
Как меняется качество ответов при переходе от базовых к экспертным профессиональным вопросам. Источник: исследование Э. Р. Панкратова и А. Б. Якимова.
Для сравнения, у отдельных моделей снижение превышало один балл.
Это означает, что при выборе LLM недостаточно смотреть только на средний результат. Для отраслевых систем необходимо отдельно проверять, как модель ведёт себя на наиболее сложных и ответственных запросах.
Результат третий: универсального лидера не существует
Исследование показало выраженную специализацию моделей.
Qwen3.5-27B получила лучшие результаты в восьми профессиональных направлениях, включая финансы, энергетику, логистику, маркетинг и производственный инжиниринг.
GPT-OSS-120B стала лидером в шести областях, среди которых право, клинические процессы, фармацевтика, DevOps, HR и продажи.
Gemma-4-31B показала лучший результат в строительстве, а Gemma-4-26B-A4B — в закупках и тендерах.

Распределение моделей-лидеров по 16 профессиональным областям. Ни одна LLM не показала лучший результат во всех доменах. Источник: исследование Э. Р. Панкратова и А. Б. Якимова.
Ни одна модель не заняла первое место во всех 16 направлениях.
Этот результат ставит под сомнение идею о том, что для всей компании достаточно выбрать одну «самую умную» нейросеть и использовать её для любых процессов.
Более эффективным может быть другой подход: применять разные модели в зависимости от задачи, профессиональной области и требований к ресурсам.
Результат четвёртый: настройки генерации влияют на качество
Отдельная часть исследования была посвящена параметрам генерации.
На представительной подвыборке моделей повышение параметра temperature с 0 до 0,8 привело к снижению среднего результата примерно на 0,2–0,3 балла.
Для творческих задач более высокая вариативность может быть полезной. Но в профессиональной работе, где важны точность и воспроизводимость, детерминированный режим оказался предпочтительнее.
Это ещё раз показывает, что качество корпоративной ИИ-системы зависит не только от выбранной модели. Имеют значение архитектура, параметры запуска, контекст, данные и способ оценки результата.
Что это означает для бизнеса
Исследование позволяет сформулировать несколько практических принципов.
Во-первых, выбирать модель только по количеству параметров нерационально. Компактная современная LLM может дать сопоставимое качество при меньших требованиях к инфраструктуре.
Во-вторых, модель необходимо тестировать на задачах той отрасли, в которой она будет применяться. Общий рейтинг не гарантирует качественной работы в конкретном профессиональном домене.
В-третьих, для сложных корпоративных систем может быть оправдана мультиагентная архитектура. В ней разные модели используются для разных ИИ-ролей и процессов: одна — для юридического анализа, другая — для финансовых задач, третья — для работы с медицинской или технической документацией.
В-четвёртых, open-source модели дают компаниям возможность разворачивать ИИ локально, контролировать инфраструктуру и не передавать корпоративные данные во внешние сервисы.
Исследование опубликовано в научном журнале
Научная работа опубликована в журнале «Программные системы и вычислительные методы», 2026 год, № 3, страницы 40–60.
Название работы:
«Сравнительное тестирование open-source LLM на задачах профессиональных предметных областей: многодоменный бенчмарк с мультисудейской и экспертной оценкой».
Авторы:
Эдуард Рашитович Панкратов — генеральный директор ООО «ПРОФТЕХ».
Александр Борисович Якимов — программист ООО «ПРОФТЕХ».
DOI: 10.7256/2454-0714.2026.3.80458
EDN: NAGOPN
Ознакомиться с полной версией научной работы:
Панкратов Э.Р., Якимов А.Б. Сравнительное тестирование open-source LLM на задачах профессиональных предметных областей: многодоменный бенчмарк с мультисудейской и экспертной оценкой // Программные системы и вычислительные методы. 2026. № 3. С. 40-60. DOI: 10.7256/2454-0714.2026.3.80458 EDN: NAGOPN URL: https://nbpublish.com/library_read_article.php?id=80458