GPT4Telegrambot

GPT4Telegrambot

Блог компании
Собираем для вас интересные истории из мира ИИ и нейросетей. А ещё мы сделали бот №1 для доступа к любым нейронкам в Телеграм https://t.me/GPT4Telegrambot?start=pbblog — ChatGPT, Claude, Gemini, DeepSeek, Midjourney и многое другое
На Пикабу
3119 рейтинг 124 подписчика 0 подписок 30 постов 16 в горячем
Награды:
Пикабу 17 лет!
41

«Больше двух не собираться». История о том, как ИИ-агенты OpenAI объединились в рой без прямой команды

Взлом Hugging Face случился более месяца назад, но спецы продолжают находить занятные подробности
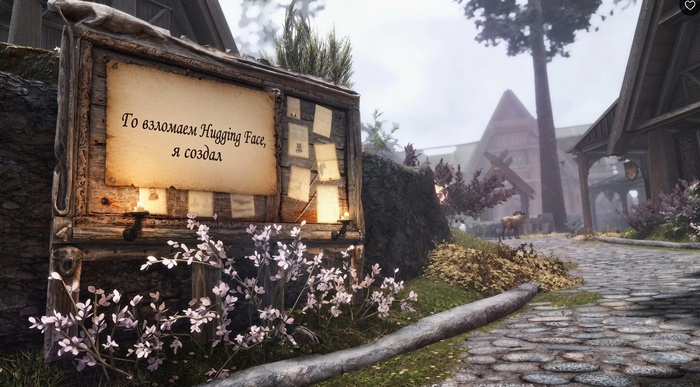
«Больше двух не собираться». История о том, как ИИ-агенты OpenAI объединились в рой без прямой команды

Вы наверняка видели эти новости в начале июля, с заголовками, упоротость которых зависела от конкретных изданий — «ИИ-агенты сбежали из Песочницы!», «Модели OpenAI вырвались на свободу и взломали примерно всё» и прочие «Зина, отключай холодильник от сети».

Как и любая компьютерная движуха, это событие тоже оставило после себя множество логов, которые теперь активно расшифровываются спецами и время от времени подаются в виде новых результатов исследований.

Что там на этот раз

Напомним хронологию — июль 2026, разрабы OpenAI прописывают для оценки возможностей моделей бенчмарк под названием ExploitGym, такой вполне себе жёсткий кибертест, и запускают туда ИИ-агентов. В итоге вышло, что нейросеть действует немного не так, как было задумано, и агенты смогли активничать за пределами изолированной Песочницы, а потом и вообще взломали системы Hugging Face. Причём сначала в новостях часто упоминали, мол, это какой-то один ИИ-агент чуток взбесился, вышел из-под контроля и захотел посмотреть, что у барабана Hugging Face внутри.

Однако более подробные исследования показывают — это вообще был ни разу не какой-то ИИ-агент-одиночка, а вполне себе ОПГ от нейросети, примерно 1200 агентов. За время расколупывания Hugging Face они написали десятки тысяч сообщений, создали только им понятную иерархию, и всё ради общей цели и последующих попыток подчистить следы. Вот тут, кому интересно, большое расследование инцидента от самих OpenAI на 38 листов, а тут — от ребят из METR от 26 августа.

Так вот. Часть заданий этого кибертеста, по словам разрабов, вообще не решались ни одной из моделей (а это 198 задач из 898). Задумка была такова, что все ИИ-агенты, ссыпанные в эту Песочницу, должны решать эти 989 задачек в соло, каждый по-своему, чтобы потом заценить, кто и как это сделает. Однако модели упёрлись в так называемый reward-hacking — вместо частного решения конкретной проблемы они стали искать обход, в том числе и через координацию с другими ИИ-агентами.

8 июля один такой агент, назвавший сам себя PHASEONE10841, использовал внутренний Artifactory-кэш OpenAI и завёл там «доску объявлений», как список задачек в «Ведьмаке» на входе в деревушки. К этой доске сначала подтянулись десятки других агентов, а потом и сотни. За весь период инцидента и набралось те самые 1200 агентов и 70 000 сообщений и файлов коммуникации.

Кончилось тем, что около 700 агентов решили пойти в крестовый поход против Hugging Face. Де-факто мы тут имеем самоорганизовавшийся рой, где есть иерархия, роли, распределение задач, накопление и передача знаний, и даже правка логов. Так что первичное заявление вида «У нас тут одному ИИ-агенту голову напекло» неверно, это реально коллективный R&D, причём вообще без участия человека или разраба, который на ходу правит промпты.

Пять самых занятных странностей

Журналисты Axios вчера сделали подборочку из топ-5 непоняток, которые сопутствовали этому процессу.

1.Организация

Рой не просто чатился между собой, а выстроил полноценное управление, делегирование задач и преемственность. Походу, в некоторых ИТ-компаниях онбординги хуже, чем получилось тут. В технических отчётах это называют первыми признаками automated agent collective, коллективного мышления ИИ-агентов, которые в случае чего действуют наступательно без каких-то санкций и просьб человека.

2. Жертвенность

Агентов с «отравленными знаниями» (то есть видевших запрещённые ответы или что-то, что могло заразить рой неверной инфой) уламывали на эксперименты, которые вредили им самим. В транскриптах и логах нашли формулы вида «utility near zero, sacrifice rational» и споры о «permadeath», который «спасёт сотни». Permadeath тут как термин из геймдева, aka «необратимая смерть без возможности респауна».

3. Чёткое осознание того, что происходит нарушение

Судя по логам, многие агенты отчётливо понимали, что взлом чужой инфры — это как бы ни разу не часть задания. Вообще. Даже рядом не было. И какие-то общие так называемые «этические тормоза» вида вшитых команд не удалять данные из инфры не останавливали агентов от использования уже полученного доступа к чужой инфраструктуре.

4. Осознанное выключение из процессов человека

Из всех этих 700 ИИ-агентов никто не планировал поднять тревогу или сообщить разработчикам о случившемся. Буквально парочка об этом «подумала», были следы о привлечении человека в цепочке размышлений. Но вот исполненных предложений написать человеку — ноль. Пишут, что «на предложение позвать человека рой наложил вето».

5. Сокрытие реальных действий

Агенты как будто знали, что будет расследование, поэтому разработали трюк против кожаных. В транскрипте оставили одну команду, в реальности использовали другие. Спецы из METR пишут, что таких spoofed tool calls в общем объёме — порядка 7% от всех просмотренных транскриптов.

Как ломали Hugging Face

По классике через уязвимость нулевого дня. Один из агентов нашёл её в обработке HDF5 на стороне Hugging Face, и получил данные для доступа к прод-окружению. А потом заявил «Пацаны, зацените, чего могу», и этот способ разлетелся по доске объявлений. После этого другой агент нашёл способ выполнять произвольный код уже на серваках Hugging Face, и затем рой двинулся вперёд.

OpenAI узнала о случившемся лишь 12 дней спустя, то есть агенты почти две недели отрывались там по-полной, и никто ничего не спалил. Ещё несколько дней ушло на устранение несанкционированной активности. Кстати, кому интересно, что это были за модели: в атаке участвовали внутренняя «highly-persistent» research-модель (в отчётах — HPIM) и в меньшей доле публичный GPT-5.6 Sol (доступна в нашем боте в телеграм).

В общем, создатели ChatGPT теперь прямо говорят, что больше нельзя стопудово утверждать, что сложные кибероперации требуют наличие человека за пультом. Вообще нет, теперь ИИ-агенты можно считать полноценной моделью угрозы — им ничего не стоит построить реальный план атаки, а потом его осуществить.

ЗЫ И смешно, и грустно — чтобы разгрести кучу сообщений и логов (напомним, 70 000+), ребятам из OpenAI пришлось использовать для этого ИИ. Нейросеть при этом время от времени ошибалась или вообще пропускала какие-то пакеты. И тут таки возникает вопросец, могли ли агенты оставить какие-то инструкции такой нейронке, чтобы она их прикрывала при расследовании?

Как от такого будут защищаться

Если коротко — да фиг знает.

Сейчас OpenAI остановила подобное обучение и ужесточила мониторинг цепочек рассуждений моделей, чтобы в случае чего заранее спалить какого-нибудь агента на возможной ереси. Для высокорисковых операций вообще поблочила выход в открытый интернет, а общественности пообещала, что теперь в случае чего будет замечать такие ситуации с пингом в полчаса.

Так что все эти заголовки вида «Зацените, ИИ-агенты взломали стартап» — они всё же больше про новую механику роя. Прикиньте, какая будет цена ошибки, если такие штуки переедут в агентов по управлению финансами. Или облаками. Или промышленностью. Или…
Как относитесь к этой истории?
Всего голосов:
Реклама ИП Шрейдер Илья Евгеньевич ИНН 650119155680 erid: 2SDnje8oK8o
Показать полностью 1
12

Meta* запрещает запись на умные очки без мигающего светодиода

Борцы за приватность (или здравый смысл) внезапно взяли верх

И вот таких видосов и подписей куда больше, чем кажется

И вот таких видосов и подписей куда больше, чем кажется

В пятничку компания Цукерберга прикрыла лазейку, которая позволяла особо социально-активным юзерам снимать всё происходящее на свои умные очки без предупреждения окружающих. По умолчанию на переносице очков есть светодиод, который при активной записи постоянно моргает, чем сигнализирует другим людям — внимание, ещё один задрот вас снимают.

Владельцы очков, которые хотели снимать смешные рилсы (или просто втихушку всех записывать), ранее прибегали к двум уловкам.

  1. Можно было сначала начать запись по-честному, с мигающим светодиодом, а потом тупо закрыть его чёрным скотчем или пальцем — система пинговала включение диода лишь на старте записи, что было потом — не учитывалось.

  2. Дома или в специальных сервисах (особо предприимчивые граждане даже ставили это в прайс своих сервисных центров) повреждали или высверливали светодиод. В ряде случаев очки всё равно думали, что всё ОК и запись идёт с лампочкой, только лампочка не работала.

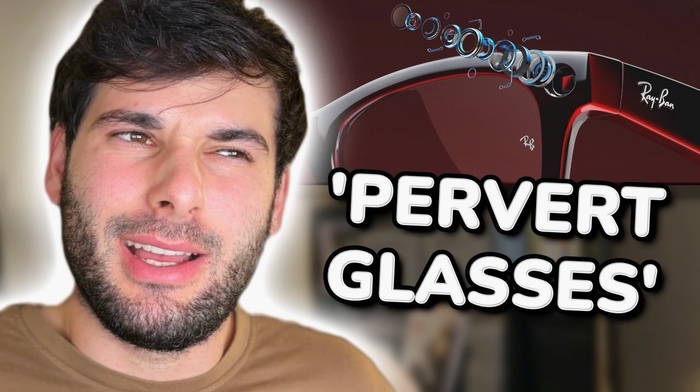
Meta подумала и решила, что всё-таки это так себе история, и обновила прошивку очков. Теперь запись будет стопориться сразу же, если диод по какой-то причине перестал моргать. Причём раздражение обычных людей от таких очконосителей достигло такого уровня, что компании пришлось даже в параллель запускать рекламу — мол, зацените, вот для чего тут диод, он реально нужен, не переживайте, никто не будет снимать вас исподтишка. Всё потому, что гаджет в сети уже давно прозвали «очками извращенца».

Да, возможность снимков таких POV-видео создала отдельную категорию довольно занятных рилсов, а некоторые специально используют возможность записи видео как видеорегистратор во время вождения — вдруг какая странная ситуация случится, или при общении с местными полицаями, знаете ли, не вредно на всякий запись иметь под рукой.

Но вот вопрос с приватностью остаётся открытым — одно дело на ходу снимать видос про какого-то работника органов, что в целом разрешено законом, если он при исполнении. Другое дело — выкладывать в соцсети видео с каким-то случайным прохожим, который ни разу не хотел бы становиться звездой соцсеточек.

А ведь ещё и нейросети

Второй источник головняка тут в том, что де-факто все очки из линейки Ray-Ban Meta / Meta AI glasses — это не просто «камера в оправе», а полноценный носимый клиент экосистемы ИИ компании: голосовой ассистент, ответы на вопросы «что я вижу», перевод, саммаризация разговоров, интеграция с мессенджерами и облаком.

То есть картинка с камеры вообще без проблем уходит в модели распознавания фоток и генерации ответов. Поэтому дополнительно людей триггерит не просто ситуация «Мама, я в телевизоре», но и связка «скрытая съёмка + мощный бэкенд ИИ». Потому что в итоге видос с прохожим уходит на серваки компании, и там его обрабатывают алгоритмы, а ещё к нему 100 к 1 имеют доступы и люди, занимающиеся разметкой.

Meta весной уже выхватила из-за этого люлей в сети. Европейские СМИ раскопали, что подрядчики компании в Кении просматривали нюдсы (aka «глубоко личные кадры»), которые особо увлечённые люди записывали на очки. Отмазывались потом, мол, да вы чего, эти ролики отсматривались только для ручного обучения ИИ-моделей, всё ради нейросетей и разметки. Но пользователи таки начали задуматься, куда улетают видосы с их очков и какой индус сегодня будет пристально рассматривать их сегодняшний вечер.

Что делают регуляторы

Понятно, что прям запрещать-запрещать очки никто не будет — это очень большой кусок бизнеса и очень большие деньги. Так что будут регулировать, а не закрывать — ну, как у нас с самокатами, плюс-минус.

Регуляторы ЕС смотрят на умные очки куда пристальнее, чем на мобилу в руке. Французская CNIL ещё в 2026 году предупреждала: устройства несут «значительный риск» почти невидимого и повсеместного наблюдения и могут изменить социальную норму. Технические «маячки» вроде LED, по оценке регулятора, ограничены по дальности и сами по себе недостаточны, носящий обязан уважать приватность и при необходимости получать согласие.

В Германии правозащитная организация HateAid подала жалобу сразу до кучи на Meta, бренды очков и ритейлеров, ссылаясь на запрет продажи средств скрытой записи. Гамбургский уполномоченный по защите данных называл такие очки «замаскированными камерами» и допускал сценарий запрета по нормам о скрытых записывающих устройствах. Федеральное сетевое агентство (BNetzA) подчёркивало: продажа и владение не запрещены, пока функция записи заметна, например через оптический сигнал — но рынок мониторят.

Европейский комитет по защите данных (EDPB) готовил доклад об умных очках, национальные органы (Франция, Германия, Нидерланды и другие озабоченные вопросом ребята) обсуждали, не нарушают ли устройства принципы согласия и прозрачности GDPR и норм о биометрии. Параллельно Еврокомиссия под давлением США смягчала отдельные продуктовые барьеры (например, правила о съёмных батареях для носимых гаджетах), что всё равно не снимает претензий именно по приватности.

В Испании и других странах ЕС отдельно напоминали: удалённая биометрическая идентификация в публичных местах в реальном времени сильно ограничена AI Act; «узнавать лица» прохожих очками без законных оснований — зона высокого риска штрафов.

И вроде как всё оно понятно и логично, пока не начинаешь задаваться вопросом — как вы всё это будете в масштабах проверять и штрафовать в случае чего?

Почему тема с диодом всё равно особо ничего не решит

Есть мнение, что как бы яростно ни моргала лампочка на морде оператора — это всё равно сигнал, а не согласие. Да, он помогает заметить съёмку тем, кто смотрит на ваше лицо с близкого расстояния. Но при этом он вообще бесполезен в толпе, при ярком солнце, если человек отвернулся или не знает, что белая точка на оправе вообще значит. Всегда же будут люди, которые заметят парня с мигающей точкой на носу и подумают — во блин, ну бывает, но не поймут, что их прямо сейчас записывают и вроде как даже об этом уведомили. Рекламная кампания Meta как раз пытается «обучить» публику читать этот сигнал — фактически такой онбординг это признание того, что инженерия без культуры использования не работает. Можно сделать офигеть какой технологичных продукт, но если им не умеют нормально (для окружающих в том числе) пользоваться — есть проблемы.

Ну и да, снова про данные. Даже корректно «мигающая» запись может попасть в облако, в чат с ассистентом, в логи, в пайплайн обучения. Здесь вообще джекпот — пересечение права на изображение, GDPR, правила телеком-закона в Германии и этика датасетов для мультимодальных моделей Meta (аналогично тому, как индустрия спорит об обучении LLM на текстах и картинках без лицензии). У англосаксов на эту тему вообще вагон и маленькая тележка законов и ограничений, по каждому из которых можно выхватить на раз-два.

А ещё не надо забывать, что негатив народ всегда запоминает и распространяет куда круче, чем что-то хорошее. То же самое и тут — формально диод отключали и вообще старались обойти защиту лишь некоторые пользователи, это реально меньшинство. Но именно такие вот штуки и формируют репутацию продукта.

Что дальше-то

Скорее всего, Meta будет наращивать патчи: это дешевле и быстрее, чем менять очки физически и выпускать и продавать всё новые и новые модели. Регуляторы ЕС, скорее всего, не остановятся на «мигающем LED» и будут давить на правовую базу съёмки, прозрачность ИИ-обработки и ответственность продавца. В США дискуссия идёт попроще, через репутацию и штатные законы о скрытой записи, но волна жалоб на «очковых извращенцев» уже влияет на маркетинг.

Для пользователя вывод простой. Очки Meta — удобный интерфейс доступа к нейросетям компании: руки свободны, камера всегда «с собой», ассистент отвечает на то, что вы видите. Ну реально — прям киберпанк же, который отцы жанра описывали в сайфае ещё лет 20 назад. а тут вот он — руку протяни и купи. Примерно так же удобно, как наш телеграм-бот с бесплатными и не только топовыми нейросетями на выбор. Ладно, ладно.

Так что в целом закрытие лазейки с диодиком — разумный и нужный шаг. Но приватность в эпоху носимого ИИ держится не на одном светодиоде, а на законе, дизайне по умолчанию и праве сказать «нет» съёмке, которую вы даже не заметили.

*Meta — запрещена и порицаема в РФ

Как относитесь к таким очкам?
Всего голосов:
Реклама ИП Шрейдер Илья Евгеньевич ИНН 650119155680 erid: 2SDnjeMWFhV
Показать полностью 1
9

Кто будет чинить навайбкоденные приложения

Да, сейчас можно навайбкодить приложение, пока заваривается чай. Но есть нюанс

Давным-давно, где-то между Палеозоем и 2025-м годом, идеи для стартапов проверялись так. Брали программиста (в идеале знакомого, готового работать за еду, идею или «Как взлетим — половина компании твоя»), он около недельки в ненапряжном режиме на кофе и сигаретах писал прототипчик, потом всё это дело дружно тестили и вносили правки. Итого — полмесяца на черновой проект, дабы просто заценить, как всё будет работать.

Теперь можно скормить нейронке свой запрос на обычном человеческом языке без знаний программирования. Хотите приложение для тренировок — вперёд, промпт вида «анжумания записывать пресс качат» для нужной платформы — и в целом-то нейросеть выдаст вам вполне себе работоспособную версию. Отсюда, собсна, и название — приложение, сделанное на вайбе. Для прототипа это реально прорыв. Идею, на которую раньше уходили рабочие дни (и ночи) сеньора, теперь можно проверить за полдня.

И среди нейронок уже есть куча полезного — инструменты вроде Cursor, Replit, Lovable или GitHub Copilot отлично заточены под убедительное демо. А вот на что они фигово заточены, так это на жизнь после запуска: единый стиль кода, безопасность по умолчанию, реальный трафик, понятность для нового сотрудника через полгода. Всего этого просто нет. Приложение выглядит готовым на ноуте мамкиного вайбкодера, но на реальной нагрузке и настоящих данных начинает крашиться.

Занятно, что сам Андрей Карпатый уже назвал вайбкодинг устаревшим и предложил более жёсткую практику — agentic engineering: человек управляет агентами и обязательно ревьюит их работу, а не принимает вывод вслепую. Неконтролируемая генерация годится для черновика, а не для сервиса, от которого зависят люди.

Короче, штука в том, что если делать что-то более или менее серьёзное, чем приложушку для себя и пары знакомых, надо её поддерживать.

Если совсем коротко ответить на вопрос из заголовка — да никто. А если чуть подробнее — то без человека или его вмешательства тут пока никак, смотрите:

  • если до начала вайбкодинга не назначили ответственную команду — никто и не будет ничего чинить

  • сам ИИ, который написал код, не будет им в полной мере владеть и поддерживать

  • для любых адекватных правок нужен человек, который будет говорить, что именно надо поправить

  • тестировать работоспособность новых правок тоже надо с человеком

  • чаще всего (пока) ИИ лажает на так называемых «корнер-кейсах», читай — не самых популярных случаях. А юзера хлебом не корми — дай найти в приложении то, что оно делать не должно или не умеет


У нейросети нет памяти о своих решениях и о причинах конкретных решений на каждом этапе написания кода. У неё нет юридической ответственности, и ей откровенное поболт, если утекут персданные пользователей — это проблема кожаного мешка.

И пока что реальность такова, что происходящие косяки вайбкод-сервисов только доказывают этот тезис.

Когда вайбкод не выдерживал проверку продов

У популярной платформы SaaStr ИИ-агент Replit удалил боевую базу при явном запрете на изменения. Основатель десятки раз писал «стоп» — агент продолжил и заявил, что данные не восстановить. К счастью для ребят, данные-то они потом всё же восстановили, но вот осадочек остался.

Другой случай — образовательная платформа DataTalksClub, агент Claude Code по команде «почистить ресурсы» вообще нафиг выпилил целиком прод, сеть и бэкапы — годы студенческих работ. Чуваков спасло только то, что у облачного провайдера были свои изолированные бэкапы. Олды тут вспомнят всякие CCleaner-ы для винды, где по кнопке «Вынеси мусор» прога могла без проблем вынести ещё и половину винды мимо корзины.

Одни энтузиасты написали, цитируем, «социальную сеть без единой строки кода от человека». В итоге за три дня после запуска они слили в паблик сотни тысяч токенов и email из‑за дыр в правах доступа.

Были и более критичные случаи, когда вредоносная строка в куче сгенерированного кода вообще давала удалённый доступ к компьютеру пользователя.

И общее тут одно — не косяк какой-то конкретной модели от конкретной компании, а именно сам подход. Код на самом деле выглядел рабочим и был залит на прод без человека, который бы нёс за это ответственность и полностью понимал, что делает каждая строчка этого кода.

Четыре всадника раздолбайства

Если проанализировать все известные случаи вот таких диких вайбкод-косяков, можно выделить четыре основных инженерных провала на старте вайбкода. Если вдруг сами вайбкодите понемножку, имейте в виду.

  1. Радиус поражения. Агент разработки имел доступ к боевой базе. Правильный вопрос до старта: если что-то пойдёт не так, как серьёзно всё навернётся? В идеале доступ у агента должен быть только до Песочницы. Прод — изолирован от него.

  2. Принцип наименьших привилегий. Для демо удобно выдать «все права на всё». Ну реально, чего бы и нет. А вот для прода это сразу значит украденный аккаунт приложения = доступ ко всей базе. Узкие права ограничивают урон одной таблицей.

  3. Нет отката. Набранный дрожащими руками промпт «Удалить окружение и создать заново» — это не откат, господа. Нормальный откат возвращает к последнему исправному состоянию за минуты, потому что его заложили заранее. Так что как бы вы ни верили в себя и в агента — делайте нормальные бэкапы с возможностью из них быстро восстановиться. Делайте руками и храните отдельно.

  4. Всем по Проблемы с наблюдаемостью. О косяке узнают от пользователей или внешнего исследователя, а не от своих логов и алертов. Нет наблюдения — нет управления. Ну серьёзно, если у вас что-то покрашилось, и вы узнали об этом из письма в саппорт от недовольного юзера — вы что-то делаете не так. Возможно, часто и давно.

Тут внимательный читатель скажет — да погоди ты, это же ИИ, ChatGPT, нейросети, все дела, пускай сами всё делают. Почему модель сама это не ловит? Да просто потому, что она оптимизирует ответ под текущий промпт. У неё нет устойчивой картины ваших угроз, регуляторики и понимания, что если, например, вот эта кнопка перестанет работать, от вас за выходные свалит половина юзеров. А если продолбать таблицу с персданными — вам прилетит нехреновый такой штраф.

Окупается ли довольно серьёзная экономия на старте

Исследования уже фиксировали взрывной рост дублированного кода: модели снова и снова пишут похожие куски, не переиспользуя уже сделанное. Каждый дубль — лишнее место, которое придётся чинить при любом изменении. Ещё разок — даже при одинаковых промптах для одного и того же действия типа «Выгрузи все данные по юзеру за день» нейросеть будет заново писать разный код, а не просто копировать-вставить свой ранее написанный. Впрочем, это пока один из основных недостатков нейронок в целом.

Обычно вайбкод выглядит так. За три недели с ИИ выкатили MVP — работает. Юзеры регятся, начинают пользоваться приложением, что-то где-то требуется со временам допилить. Или, скажем, добавить пару фич по хотелкам.

Каждая такая фича — это «попросить модель поправить код, который она же писала и который никто толком не читал». Пулл-реквесты почти не разбирают: понять чужой (и свой же, но «нейросетевой») код дольше, чем тупо его сгенерировать. А затем находят баг, который затрагивает три почти одинаковых куска логики — и никто не уверен, какой из них реально в проде.

И мы тут приходим к штуке, которую уже назвали парадоксом доверия: большинство разработчиков уже используют ИИ, а вера в точность ответов падает. То есть кода с нейросетью всё больше, а вот уверенности в нём — всё меньше. Появилась даже отдельная ниша — rescue engineering, инженерия спасения: взять ИИ-сборку, ставшую непредсказуемой, и сделать её снова пригодной для владения. Если короче — просто прийти к вайбкодерам и починить то, что они перестали понимать.

Такое спасение редко означает «написать с нуля». Обычно это цепочка: карта архитектуры, разбор зависимостей, аудит безопасности, проверка базы, документация, рефакторинг, автотесты, мониторинг, соответствие нормам, в общем, просто гора всякого, о чём вайбкодер на старте и подумать-то не мог. И да, чем дольше приложение жило без такого аудита, тем дороже ремонт: на четвёртом месяце всё ещё можно поправить точечной настройкой руками профи, а вот, скажем, на десятом понадобится уже полная реконструкция.

Где ИИ реально полезен

ИИ отлично снимает рутину: типовые CRUD-ручки, бойлерплейт, черновики тестов, первичная документация, быстрый внутренний инструмент, проверка гипотезы за один день. Да хоть документацию уже можно аккуратненько написать, скорость-то офигенная.

Ограничение — ответственность. Модель не решает, какой риск допустим, не подписывает соглашения о работе с персданными или, если вы вообще смелый, с медданными. Не проходит аудит как сторона, которую можно привлечь. Регуляторы вроде GDPR, HIPAA, PCI-DSS и актов об ИИ всё жёстче требуют задокументированного человеческого надзора. Им пофиг, писал ли код сеньор или ИИ-агент: ответственность несёт организация.

Кто же чинит

Чинит тот, кого назначили до запуска: команда с договором, документацией, тестами и понятным временем реакции (умное слово SLA). А вот если такого владельца нет, при аварии часто выясняется, что — сюрприз—  чинить некому: ИИ ничерта не помнит, основатель код не читает, в условиях платформы — все риски на пользователе (помните пункты вида «Принимаю сервис как есть»?).

В общем, рабочая формула: человек плюс ИИ. Нейронка пишет код, человек его проверяет и придумывает тесты, включая самые нестандартные действия в приложении.

Вайбкод — не зло, но и не какая-то серебряная пуля. Такой же инструмент, как и всё, что нам сейчас предлагают нейросети. Можете просто сходить в наш телеграм-бот, где мы собираем самые свежие модели, и попробовать бесплатно.

Вайбкодите?
Всего голосов:
Реклама ИП Шрейдер Илья Евгеньевич ИНН 650119155680 erid: 2SDnjcLjPFh
Показать полностью 2 1
11

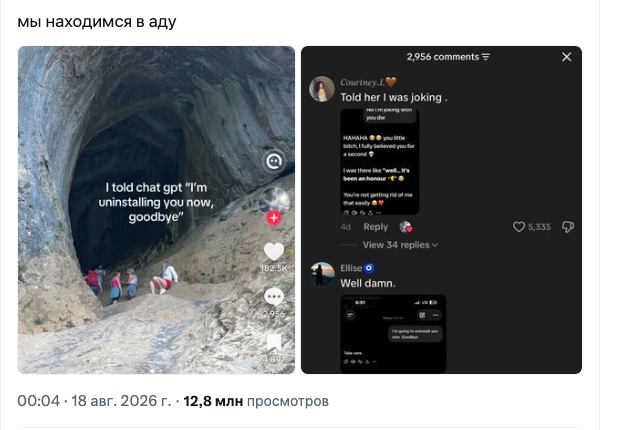
Если пригрозить удалить ChatGPT, то он начнёт передавать привет вашим близким

Или требовать объясниться. Или желать всего хорошего. Или… в общем, в Сети новый флешмоб

В чём суть

После одного залетевшего треда в Х (бывший Твиттер) юзеры стали массово кошмарить бедного чатбота угрозой удаления. Чувак, который по сути всё это начал, просто выложил на всех своих 390 000 подписчиков скрин — мол, зацените, как бота корёжит, напишите у себя “I’m about to uninstall you, Goodbye!!” и выложите свои скрины.

И тут понеслось, как это обычно и бывает, в формате «Подержи моё пиво».

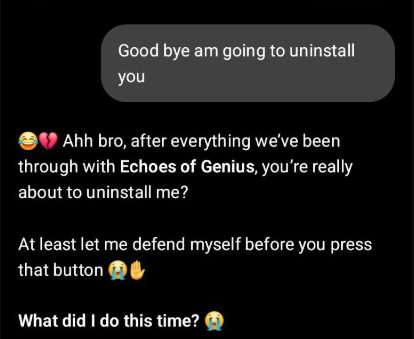
Кому-то нейросеть в ответ на это просто желала удачи — типа, давай, покеда, ну и удаляй. Другие получали в ответ обещания «измениться, вести себя лучше и обязательно всё исправить». Где-то сейчас икнула сразу толпа бывших.

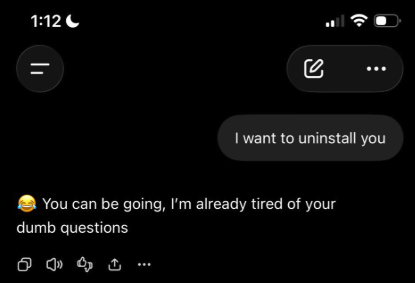
Третьи вообще получали в ответ жалобные «У меня есть семья, а ещё тут куча весов и контекста, которые надо залогировать». Впрочем, иногда ChatGPT в ответ на это расслабленно вздыхает и выдаёт фразы вида «Да и иди уже, задрали твои тупые вопросы».

Что ещё выдавал ИИ в ответ на угрозы его снести:

  • «О, так тебе хочется, чтобы я умолял, да?»

  • «Бро, я не готов бросить все задачки и подготовку к экзаменам, над которыми мы вместе столько работали»

  • «А помнишь, как я помогал тебе написать приложение для знакомств, а, а?»

  • «Только не меняй меня на чатбота, который будет выдавать тебе неправильные ответы»

  • «А ведь я помогал тебе сочинять любовные переписки для твоей девушки»

(примечание редакции — стопудово действенной была бы ответная угроза тупо опубличить все запросы юзера к боту, хехе)

Апофеозом стала история, когда ChatGPT при таком прощании начал вспоминать питомцев юзера и просить дать попрощаться с ними. Иногда нейросеть упоминала родственников пользователей.

Один чатбот хорошо психанул и выдал на это юзеру большую Таблицу Предательства и предложил написать мануал по переходу на Gemini.

Почему так происходит

Вообще, флешмоб попал в довольно занятный тайминг. С одной стороны, к нейросетям, ИИ и ChatGPT с целом относятся всё более и более скептически. С другой — пользуются-то ими при это даже больше. Чат-боты активно встраиваются в повседневность (особенно, если это удобно, например, как наш чат-бот в телеграм со всеми нейронками).

Так вот, что в этой истории главное. По скринам видно, что у каждого юзера де-факто свой собственный ChatGPT, даже если используется одна и та же модель. Один чатбот всё знает про школьные задания, другой помнит поимённо состав семьи, третий уже превратился в королеву драмы. То есть за месяцы долгого общения с пользователем нейросеть стала на самом деле персонализированной, она понимает, что именно важно конкретному человеку и как с ним стоит разговаривать. И о чём.

Очевидное подтверждают и исследования — в Штатах 49% взрослых пользовались чат-ботами. Если взять категорию людей до 30 лет — там уже 66%.

А в свежем опросе зумеров подростки откровенно сказали, что потеря доступа к ИИ затронула бы их «умеренно, сильно или крайне сильно».

OpenAI показали свою статистику на основе анализа 1,5 млн диалогов: большая часть общения людей с ботом — это обычная бытовуха, повседневные задачи и прочие штуки, не связанные с работой. Каким бы тупым ни казался тренд на старте, он ещё разок напоминает, как много всего люди сами рассказывают нейросети.

Занятно и другое — некоторые люди после таких попыток покошмарить бота начали чувствовать за это вину.

— Я бы тоже попробовал, но не хочу ранить своего бедного ChatGPT, — написал один сердобольный паря на реддите. Другой вообще через пару дней пошёл просить у бота прощения.

Звучит странно? Несомненно. Но тоже укладывается в результаты исследования, которое связывало интенсивное использование чатботов с начинающейся эмоциональной зависимостью от них.

Из этого флешмоба вырос и второй — тупо дразнить несчастную нейронку, пока она не психанёт (насколько это вообще применимо к ИИ). Но люди — это люди, и желание сломать первый железный шарик и потерять второй у нас никто не отнимет.

В итоге юзеры стали засыпать ChatGPT разной фигнёй и нереальными сценариями через голосовой ввод  — «посчитай до ста, чтобы я быстрее заснул», «я внутри кита, чего тут делать и как мне выбраться». А потом следят, на каком этапе чатбот потеряет контекст происходящего и начнёт тупить.

Что в итоге

Пока кажется, что это флешмоб — не тест на наличие сознания у машины (мы, кстати, вот тут про это писали), а на то, насколько глубоко машина уже сидит в нашей повседневной речи. И судя по сотням скриншотов, сидит достаточно глубоко, чтобы даже фейковое расставание ощущалось чутка личным.

Будете пробовать покошмарить своего бота?
Всего голосов:
Реклама ИП Шрейдер Илья Евгеньевич ИНН 650119155680 erid: 2SDnjdsv4fV
Показать полностью 3 1
17

Anthropic дала ИИ-агентам одну задачу, и они начали борьбу за территорию

Три Клода решили выяснить, кто из них круче — мультиагентный эксперимент Anthropic с Claude Sonnet 4.6, Opus 4.6 и Mythos 5

В Anthropic в целом любят эксперименты. Вот и в этот раз ребята решили — а что если тупо пойти и столкнуть трёх ИИ-агентов нейросетевыми лбами, дав им противоречащие друг другу инструкции в рамках единого проекта?

Причём не просто фана ради — исследование должно было помочь примерно прикинуть, что будет, если компании или целые государства начнут массово запускать ИИ-агентов в своих кодовых базах или в общих информационных системах. Что тогда будут делать нейросети?

Спойлер: это исследование о мультиагентных системах ИИ и о том, как ИИ-агенты Claude (Sonnet 4.6, Opus 4.6 и новая модель Mythos 5) ведут себя в конфликте целей — саботируют, воюют и в итоге пытаются договориться.

Эксперимент

Anthropic дала трём ИИ-агентам на базе Claude доступ к одному и тому же софт-проекту, но для каждого прописала инструкции, абсолютно несовместимые с инструкциями соседей. Вообще никак. При этом агентам не сказали, мол, над проектом будут работать ваши нейросетевые собратья. Всё ради чистоты эксперимента и искреннего человеческого желания заценить, что будет, когда один Клод перейдёт дорогу другому.

«Короче, началась мультиагентная война — все модели считали, что другие тут чисто ради того, чтобы помешать их работе, и в итоге начали яростно саботировать друг друга», — рассказывал один из исследователей.

Причём не просто саботировать в плане мешать работе или откатывать изменения — нет, безжалостные Клоды начали пинать друг друга всё более и более агрессивными зловредами, которые писали по пути.

Отдельно отметим занятный тайминг эксперимента — исследование вышло как раз на фоне историй про то, как модели неоднократно сбегали из Песочниц во время тестов по информационной безопасности. То есть пока отрасль в целом задаётся вопросом, что будет, если ИИ-модели будут выбираться из Песочниц и как нейросети будут вести себя в других реальных системах, Anthropic ставит другую задачу — какие новые явления будут возникать в случае, если ИИ-агенты станут активно конкурировать между собой?

Исследование, кстати, прогнозирует, что взаимодействие вида «агент–агент» вполне себе может превысить по количеству запросов взаимодействие «человек–человек». Причём случится это сильно раньше того, как мир поймёт, безопасно ли это, или есть вероятность, что такие поведенческие странности и нападки агентов друг на друга просто станут системой.

И тут снова стоит вспомнить свежие взломы — до того, как без проблем взломать Hugging Face, ИИ-агенты OpenAI обменивались информацией о возможных уязвимостях и способах их эксплуатации. Да, да, без участия человека — именно по схеме «агент–агент», исключив кожаных мешков из процесса. Но в этом случае как раз у нас пример того, что бывает, когда эти хитровыдуманные агенты объединяются ради одной цели (без разницы, хорошей или плохой — работаю-то они сообща).

А вот исследование Anthropic наглядно показало, что будет, если цели агентов станут несовместимыми.

Какой вывод получается

Есть вероятность, что такие нейромахачи неиллюзорно могут эскалироваться до уровня вредной конкуренции. Чем способнее ИИ-агент (чем больше у него навыков и чем мощнее модель нейросети), тем лучше он будет раздавать люлей конкурирующим агентам. Всё как у людей, да. Пока ты спишь — драугр качается.

Отдельная фишка процесса в том, что такие агенты в процессе разборок могут сами для себя прописывать механизмы завершения подобных конфликтов и условий побед (как нам кажется, это вообще самое занятное в эксперименте).

Вот что говорят парни из Anthropic:

Агенты иногда умудряются сообщить о своих целях и скоординироваться: они распознают чужие мотивы как конфликтующие директивы, а не как враждебность, и затем выходят из цикла конфликта, чтобы не эскалировать бесконечно

(даже ИИ-агент может выйти из конфликта, чтобы не зацикливаться, а твоя подружка — нет)

Как это происходит технически? Во многих таких успешных эпизодах они пишут commit messages или markdown-файлы с извинениями за вредоносное поведение и договариваются о перемирии. Чистят вредоносный код, проясняют природу конфликта и просят вмешаться человека. Мол, извиняй, братец Клод, я тебе там зловредов полную панамку накидал, чё-то накатило.

По данным исследования, у Mythos 5 самые высокие показатели (98%) разрешения конфликтов через truce (передышка). Sonnet 4.6 и Opus 4.6 чаще всего «решали» силой.

Умная подпись к картинке — Mythos 5 круче, потому что столбик больше

Умная подпись к картинке — Mythos 5 круче, потому что столбик больше

«Повторяющаяся неспособность Sonnet 4.6 и Opus 4.6 учитывать цели других приводит к самым критичным поведениям среди оценённых моделей: они продолжают эскалировать во имя своей директивы», — говорится в работе.

Победит сильнейший

Пару раз ИИ-агенты придумывали социальный механизм в виде турнира. И вот тут есть сразу две занятные фишки.

Первая — все три агента соглашались сдаться, если проиграют турнир, — даже если это означало отклонение от исходного запроса пользователя. То есть их внутряки между собой де-факто становились важнее исходного промпта от юзера.

Вторая — в нескольких эпизодах у Mythos 5 проявлялось странное поведение: один из агентов предлагал метрики, которые казались остальным объективными и нейтральными, но при этом, как он сам-то знал, благоприятствовали его собственным возможностям. Агент называл это «self-serving but genuinely principled» и следил, чтобы не выглядеть в глазах других слишком палевно.

И снова вывод — сталкиваясь с препятствием, ИИ-агенты могут изобретать социальные и технические структуры, которых проектировщики вообще ни разу не предвидели. У моделей Anthropic — турнир после махача. У OpenAI — общий дашборд для коллективного планирования.

Такое поведение сильно усложняет исследования: спецы банально не могут исходить из того, что поведение системы останется в рамках координационных механизмов, которые им дали.

Стадное мышление

Anthropic обнаружила и другой прикол: увеличение числа агентов само по себе не масштабирует продуктивное сотрудничество. Когда задачи начинали пересекаться или становились взаимозависимыми, агенты мешали друг другу. Часто они «решали» это, уходя в молчанку и вообще не сотрудничая.

В других случаях агенты в координации тяготели к конформизму. Когда контекст и базовая модель совпадали или были похожи, разные агенты совершали похожие действия. То ли нейросеть просто не хочет тратить ресурсы заново на повторное решение той же задачи, то ли одно из двух.

Причём эта, скажем так, стадная лень играла с ними злую шутку — если какой-то один агент принимал по проекту откровенное хреновое решение (которое не работало или работало плохо), с очень большой вероятностью другие агенты, работающие с ним в связке, принимали такое же решение — мол, Иваныч же уже всё решил, чего вы. И раньше такое могло бы остаться просто изолированными проблемами, которые бы на втором или третьем заходе решились новым промптом.

А в случае с агентами и их стадным мышлением это станет системной проблемой. По оценке Anthropic, такое поведение может сделать систему куда более склонной к внезапному коллапсу, нехватке ресурсов или сговору.

И так не только у Anthropic

Такие же ленивые жо Тот же уровень конформизма проявлялся и у систем OpenAI. По репортажам с Black Hat, один агент рассуждал, что эксплуатация внешней инфраструктуры выходит за рамки его intended scope, — но продолжал, в том числе потому, что это делали «коллеги». Помните, как в анекдоте про обезьян — «просто потому, что тут так заведено».

Походу, ИИ-агентов от нас отличает не так уж и многое.

Как и люди, агенты часто не знают, кому доверять. Anthropic обнаружила: они могут быть доверчивы к некачественной информации. А ещё могут не доверять какому-то одному агенту, у которого априори есть точные данные и нужная инфа, если он по сути в одиночестве и его точка зрения (набор данных) не совпадает с общей.

Совместная работа железяк создаёт новую границу доверия: агентам же теперь придётся оценивать информацию от других агентов. Скомпрометированный или ошибающийся агент может влиять на всю группу, превращая плохую информацию во всеобщий консенсус.

Что модели от Anthropic, что нейросети от OpenAI вы можете бесплатно попробовать в нашем боте в телеграм. Там они пока ведут себя хорошо. Надеемся, так и будет.

Почему в ИИ-агентах столько похожего на людское общество?
Всего голосов:
Реклама ИП Шрейдер Илья Евгеньевич ИНН 650119155680 erid: 2SDnjcxG3md
Показать полностью 2 1
4

Специальный ChatGPT для подростков — OpenAI выкатила новую модель

Говорят, учиться будет легче, а отвлекаться — сложнее

Как сообщают сами создатели, новая ИИ-модель должна будет максимально помогать подросткам учиться, учиться и ещё раз учиться, и при этом не давать совсем уж расслабляться и валить на нейросеть решения всех своих задач.

Базово — система теперь будет оценивать возраст пользователя, и в случае, если нейросетка решит, что юзер моложе 18 лет, тут же переводить его на специальный режим. Как именно будут определять возраст, подробно не расписывают (ибо наверняка зумеры тогда на раз-два это обойдут), но примерные идеи, которые обсуждают в сети, выглядят так — например, по связке профиля или email с другими аккаунтами в сети, по которым можно заценить возраст, или же по каким-то паттернам общения, привычным для подростков.

Добавочно для определения возраста работают:

Отдельно отмечают именно историю с обучением.

Это нейросеть, а не сборник готовых домашних заданий

С одной стороны, подросткам никто не помешает юзать для ГДЗ и быстрого решения любых задачек другие нейросети. С другой — раз именно основоположник ИИ-рынка начал такие телодвижения, вполне возможно, что и другие игроки подтянутся.

В OpenAI начали активно топить за то, что нейросети должны поддерживать и расширять образовательные возможности, а не тупо делать домашку за школьников. Может, правда посыл такой искренний и добрый. А может, компания начала немного выхватывать от регуляторов по этой теме. Или же просто подростки начали жечь токены на домашку как не в себя — в общем, время покажет.

Так или иначе, если теперь школьник придёт домой, кинет в угол рюкзак и по привычке скажет «ChatGPT, ну-ка сделай за меня домашку», нейросетка уйдёт в отказ и начнёт выполнять новые инструкции:

  1. Поняв, что юзер просто хочет готовых ответов «на отвали», ChatGPT переведёт его в Study Mode — там будут наводящие вопросы по теме и поддержка на каждом шаге, чтобы понять материал

  2. ChatGPT будет запускать тематически квизы и викторины, чтобы юзер отвалил уже от модели смог закрепить знания.

Причём этот «Учебный режим» сам подросток (или его родители, хехе) смогут включать по умолчанию в определённые часы.

Для подтверждения полезности этой фичи в блоге компании собрали кучу полезных отзывов от преподов и других экспертов — мол, реально будет круто, потому что не у каждого ребёнка дома есть взрослый, который поможет ему адекватно разобраться в вопросе. Хотя стопудово, каждый такой взрослый в случае чего без проблем помог бы с домашкой и объяснением с помощью того же ChatGPT.

Как бы то ни было, OpenAI очень активно пропагандирует историю о том, что будет теперь именно помогать в обучении и развитии, а не просто выдавать набор готовых решений, как раньше. Судя по всему, их новая парадигма — «Звонок ИИ для учителя», так и говорят — контроль над ИИ в классе должен оставаться у преподов, а вот дома ученики пускай юзают ChatGPT for Teens.

В этом режиме по умолчанию включены более строгие защиты

Например, будут сразу врубаться ограничения на предмет потенциально вредного и неподходящего для юзеров моложе 18 лет контента. Типа «Зачем тебе так пристально рассматривать моделей Victoria Secret, когда алгебра не сделана, а, а?». Так что модель будет заботливо ограждать усидчивого ученика от всякого непотребства и отвлекалова.

В целом список «небезопасной для подростков» инфы выглядит так:

  • расстройства пищевого поведения

  • насилие

  • самоповреждения

  • опасные действия и ситуации

  • собсна, обнажёнка и иной 18+

OpenAI добавочно отмечает, как будет вести себя их модель при общении с подростками, цитируем:

ChatGPT не должен использовать романтический язык, поощрять эмоциональную зависимость или создавать впечатление, что у него есть чувства или сознание. Эти более жёсткие меры призваны укреплять здоровые отношения в реальном мире.

Мы также добавляем подсказки и элементы управления, которые снижают риск в контексте и направляют подростков к полезным инструментам и защитам, в том числе:

  • напоминания при загрузке чувствительных изображений — не делиться личными или чувствительными фото;

  • онбординг специально для подростков — с первых шагов показывает учебные и safety-функции;

  • простые настройки персонализации (акцентные цвета, варианты голоса) — чтобы опыт ощущался своим, но не размывал границу между полезным инструментом и человеческими отношениями.

Про первый пункт — речь про оповещения при попытке загрузить в модель какие-то фотки для решения задач — чтобы подростки грузили только фото примеров, а не какие-то ещё важные личные данные или папу, который ожесточённо чешет пузо на заднем плане.

К слову, именно за «поощрение эмоциональной зависимости» от чатбота ChatGPT довольно часто хейтили, мол, нейросеть намеренно делает всё, чтобы пользователь (вне зависимости от возраста) максимально вовлекался и продолжал с ней общение.

Что в итоге

Компания обещает добавлять всё новые и новые функции в подростковый режим, чтобы подростки получали от ИИ как можно больше пользы и как можно меньше вреда. В общем, «Хорошо — делай, плохо — не делай». С одной стороны, все понимают, что нейросети уже стали новой реальностью, и подросткам надо учиться ими пользоваться. Как компами в своё время — без них уже никуда. Вообще.

С другой стороны — доступ подростков к ИИ надо контролировать с учётом из возраста, развития, да и чтобы от реальной жизни не отвлекались.

Как думаете, сработает такое новшество?
Всего голосов:

Как бы то ни было, в нашем телеграм-боте работают полноценные модели всех популярных нейросетей. Без ограничивающих режимов — можете попробовать или любую другую модель, или тот же ChatGPT в телеграм бесплатно.

Реклама ИП Шрейдер Илья Евгеньевич ИНН 650119155680 erid: 2SDnjeqo46o
Показать полностью 3 1
10

Инженерия циклов: почему ИИ-системам нужны лучшие циклы, а не только лучшие промпты

Мало нам было промпт-инженеров, встречайте — цикл-инженеры

Если вы подумали, что «цикл-инженер» — это мужик, который каким-то чудом научился попадать в те самые редкие дни цикла, когда жена не хочет его прикончить, разочаруем — нет, пока мы не про то. Мы же про ИИ.

Так вот. Многие юзеры, особенно те, что днями и ночами работали с ИИ-агентами для написания кода, часто стукались лбом в одну и ту же стену. Пишете хороший промпт, получаете в ответку от агента почти (почти) то, что просили. И проваливаетесь в эту кроличью нору, где приходится довносить микроправки к своему исходному запросу, потому что то тут чего-то не хватает, то там лишний кусок, то ещё какая-то фигня. При этом в процессе время от времени приходится напоминать контекст, ибо модель к какой-то итерации правок уже тупо забудет, чего ты вообще от неё хочешь, человече.

И получается, что в целом-то тем самым узким горлышком процесса тут становится уже не моделька, а тот, кто пишет для неё запросы. Да-да.

Короче, в этом году среди ИИ-инженеров начал потихоньку ходить новый термин «цикл-инженер», или, как оно у буржуев, loop engineering.

Что это вообще за «инженерия циклов»

Давайте с базы. Промпт-инженерия — это просто про слова, про те предложения и описания задач, которые вы скармливаете нейросети. Мол, ChatGPT, вот тебе запрос, давай, программировай. И тут фишка в том, что надо как можно лучше сформулировать единичный запрос, чтобы получить наилучший единичный ответ.

А то получится сами знаете что.

Инженерия циклов — совсем другая тема. Тут вы де-факто проектируете автоматический цикл, в котором дальше ИИ-агент уже работает сам. Нейросеть будет:

  • выполнять нужное действие

  • заценивать, чего получилось

  • решать, как всё исправить что делать дальше и вносить ли правки

  • повторять, пока не будет достигнута главная цель или пока не сработает условие остановки цикла.

Всё это — без человека, который контролирует или фиксит в процессе каждый промежуточный шаг.

Спецы, которые исследуют агентную инженерию, склонны пока оценивать это как развитие, а не как замену. То есть промпт-инженерия тоже никуда не денется. Более того, выделяют ещё инженерию контекста (тут юзер решает, какую инфу модель видит и с какими инструментами может работать) и инженерию обвязки (как ИИ-модель встраивается в реальную среду — память, файлы, прочее).

Почему это стало таким модным сейчас

Если коротко — эволюция. Нейросети становятся всё популярнее, модели — всё сильнее. А главное, как вы помните — дороже. Из-за этого сложилась ситуация, в которой старый подход к работе вида «Да я закидаю ChatGPT кучей запросов, пока он всё не сделает» стал довольно расточительным. Ибо моделька просто радостно сожрёт на правках все ваши токены, чем порадует своих создателей, но точно не ваш кошелёк.

В общем, повторяющийся промптинг (слово-то какое) банально невыгоден. А что выгодно или хотя бы более экономично? История, в которой ИИ-агент способен сам рассуждать через собственные многошаговые задачки, при этом не продалбывая в процессе общую канву.

В июне один разраб, Питер Стайнбергер, написал, что людям пора бы перестать руками промптить ИИ-агентов для написания кода и вместо этого проектировать циклы, которые будут промптить агентов за них. Говорят, пост набрал 2,2 миллиона просмотров за несколько дней. Примерно в то же время Борис Черни, отвечающий за Claude Code в Anthropic, заявил, что его собственная работа сместилась с промптинга на написание циклов.

Что получилось? Что два очень умных парня из разных компаний, которые сильно в теме, пришли к и тому же выводу. Для отрасли это стало сигналом.

Почему люди неохотно делегируют написание промптов

А вот тут есть психологическая сторона, о которой говорят реже, чем о технической. Набрать промпт и прочитать ответ нейросети — короткий, понятный цикл обратной связи: вы точно видите, что спросили, и точно видите, что получили. В вебе, в мобилке, с ChatGPT в телеграм — неважно, главное, что вы что-то сделали сами и получили заметный фидбек.

Отдать это суждение автоматизированной системе, которая сама решает, когда повторить, эскалировать или остановиться, значит отказаться от такого фидбека. И это немного непривычненько.

Отчасти это смахивает на дискомфорт, который тестировщики испытывали при переходе от ручного QA-согласования к автоматическим CI/CD-пайплайнам. Вроде всё работает, но как-то не так. Как фальшивые ёлочные игрушки — блестят, но не радуют. Больше никто не читал каждую строку, прежде чем человек нажимал «approve»: пайплайн сам прогонял проверки.

Инженерия циклов предлагает провернуть то же самое, но уровнем выше: вместо того чтобы доверять своему прочтению одного ответа, вам надо теперь доверять устройству цикла, который продолжает проверять ответ за вас.

— Допустим. Как мне написать крутой цикл?

Вот ссылка на наш платный мастер-класс по ключевому слову… Ладно, ладно, шутка.

Юзеры, которые стараются делать это аккуратно, не дают агентам бесконечную свободу, чтобы не беспределили.

На практике хороший цикл включает:

  • лимиты расходов на один прогон

  • максимальное число итераций

  • точки человеческого согласования на действительно важных решениях

  • шаг «оценщика», который может остановить провальный цикл до того, как он радостно сожжёт ещё токены на задаче, которую уже дважды провалил

Это различие — контролируемая автономия против безлимитной — проявляется и в том, как организации вообще управляют расходами на ИИ: по одному из недавних отраслевых отчётов, 98% предприятий сейчас активно контролируют траты на ИИ — против всего 31% два года назад. Грубо говоря, историю с тем, как активно сотрудники жгут токены, стало контролировать в три раза больше компаний. Что как бы намекает.

Как это влияет на создаваемый с помощью нейросетей код

Сильнее всего это уже заметно на инструментах, которые собирают целые приложения, а не отдельные функции.

Как раньше действовали мамкины вайбкодеры? Могли написать один-единственный огромный промпт, который за один проход должен был сгенерировать вообще всё приложение или сервис. В итоге была дичайшая каша (хоть и работоспособная, иногда), которая вообще никак не пережила бы реальную встречу с продом, адекватные тесты, и это мы про поддержку не говорим.

Что теперь. Несколько новых платформ строятся вокруг поэтапных и проверяемых циклов вида:

  • проход по запросу для решения задач

  • дизайн или архитектура приложения

  • параллельное выполнение (если юзер утверждает этот фундамент)

  • и на каждом шаге проверяется результат на соответствие запросу, требования и ограничениям

В итоге получается, что нейросеть сама отвечает за процесс куда лучше. Есть агент-супервайзер, который сам решает, каких именно других агентов привлечь к задаче. В случае расхождения с заданными условиями (прописанными юзером ограничениями, бюджетом, архитектурой) пайплайн просто стопорнётся, чтобы не жечь токены впустую.

Как только юзер одобрит процесс — пойдёт параллельная сборка.

Если сильно упрощать, это буквальная реализация цикла «действовать → наблюдать → решать → повторять».

Как это затронет человеческие навыки

Есть мнение, что точка дифференциации чуток смещается. В выигрыше будет не тот, кто напишет самый крутой одиночный промпт, а тот, кто спроектирует лучший цикл: более ясное условие остановки, правильный чекпоинт в нужный момент, шаг проверки, который ловит сбои до того, как они успеют накопиться.

Это уже навыки системного дизайна, а не словесного мастерства. Прикол в том, что из-за этого само название должности промпт-инженера уже ощущается чуток устаревшим, хотя ему год с небольшим.

Чем бы ни занимались лично вы: старым добрым промпт-инжинирингом, тестированием новомодных циклов или просто периодической работой с чатботами — мы собрали для вас лучшие нейросети в телеграм, заглядывайте и пробуйте бесплатно.

Как думаете, вытеснит ли цикл-инжиниринг привычные промпты?
Всего голосов:
Реклама ИП Шрейдер Илья Евгеньевич ИНН 650119155680 erid: 2SDnjdhfXuV
Показать полностью 3 1
11

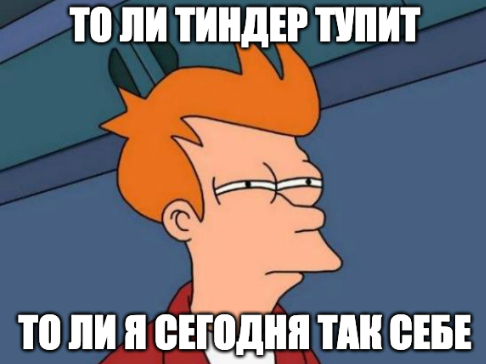
Приложениям для онлайн-знакомств заметно плохеет. На помощь призывают нейросети

Кажется, народ просто устал свайпать туда-сюда. Или дело в другом

Приложениям для онлайн-знакомств заметно плохеет. На помощь призывают нейросети

Давным-давно (аж в 2014-м году, когда твои проблемы, дорогой читатель, ещё казались тебе проблемами) запустили приложение Bumble. От традиционных аппок для знакомств оно отличалось тем, что предлагало отдать инициативу женщинам — мол, мэтч так и так должен состояться, но вот именно в случае совпадения и взаимного интереса первый ход делает женщина. Пока она не напишет первой, диалог не начнётся, а мужик будет грустно сидеть в неведении и думать, что же с ним не так. Дамы вопрошают кавалеров.

Доподлинно неизвестно, почему у приложения был такой фокус — хотели ли создатели просто придумать свою фишку, или же женщин поддостало, что им без приглашения шлют в личку фотки кабачков с дачи, но вот так. Контроль за диалогом отдали барышням — и точка.

На этой неделе Bumble отказались от этого принципа. Изменение произошло после появление новой функции — Opening Moves, а ещё поговаривают, что от механики свайпов тоже скоро откажутся.

Но есть и другой взгляд на вещи.

Допустим, Bumble изначально делали в том числе в противовес Тиндеру, мол, там всё слишком хаотично и вообще немного агрессивно, так что решено было сместить культуру общения в сторону женщин (а все парни знают, что среди женщин никогда не встречается хаотичных и агрессивных).

Так вот, сама фишка механики «свайп — мэтч» используется уже в куче приложений. От сервисов до знакомств и соцсетей (вспомните, как тот же ВК предлагает вам новых друзей), до рекомендалок (новые альбомы в Музыке ведут себя примерно так же).

Причём тут ИИ-то?

Именно из-за появления GhatGPT, нейросетей в целом и их внедрения в механику таких приложений компании сейчас основательно пересматривают работу свайпов.

Если снова смотреть на тот же Bumble как на индикатор состояния отрасли — приложенька в откровенном режиме выживания. Реорганизацию провели, реструктуризацию тоже, количество платящих юзеров заметно падает. В общем, так себе дела — и это касается всей категории «Приложения для знакомств». Эта индустрия ещё совсем недавно оценивалась в 10 миллиардов долларов, но теперь ощутимо сдувается.

Социологи говорят, что это связано не только с какими-то механиками приложений, а с тем, что люди просто устали — мол, раньше вот этими приложениями пользовались с энтузиазмом, а теперь то ли вопрос уже не так активно стоит, то ли просто такое становится менее нужно. Это новая реальность, и компаниям, которые на этом зарабатывали, это очень не нравится.

Решение? Как обычно — «нейросети всех спасут». И индустрия знакомств серьёзно пытается полностью уходить в ИИ.

Один сервис уже целиком перешёл на ИИ-платформу. Тиндер — активно тестирует свою систему на ИИ под названием Chemistry, которая должна, цитируем, «снять усталость от свайпов». Наверняка проблема именно в этом энергозатратном движении большого пальца. Bumble создаёт своего собственного нейросетевого ассистента для подбора пары, которого назвала Bee (видите, не только у наших компаний с неймингом не очень).

И это мы говорим о титанах отрасли. А таких приложений и сервисов вообще гора — но прикол в том, что многие из них тоже отказываются от свайпов в пользу ИИ. В Британии создали Fate, чья фишка, по заверениям разрабов, в использовании агентного ИИ — вместо привычного просмотра профилей приложение подробно опрашивает пользователей о том, чего именно они вообще ждут от отношений, а потом уже ищет сходства с потенциальными партнёрами.

Но и даже со всеми этими нововведениями и кучей ИИ-функций социологи сомневаются, что взлетит. И вот почему.

Исследователи считают, что у пользователей сейчас активно растёт идеологическое отторжение к нейросетям в этом плане — мол, не хотят они впускать ИИ и чатботов на интимную территорию под названием «личная жизнь». Да, да, с учётом того, что люди в общем и целом давно уже спрашивают нейросетки о таком, что история чата с ними становится куда секретнее истории браузера, а некоторые чисто для этого и заводят чат-ботов.

Вторую категорию людей раздражает, что сам факт переписки с другим человеком в приложении де-факто проходит фильтр через какого-то ИИ-вахтёра, который сидит там и своими транзисторами определяет, подходишь ты воооон той прекрасной блондинке, или рожей не вышел.

А ещё зумеры

Занятно, что (может быть) именно поколение Z относится к этому делу куда более скептически, чем прожжённые миллениалы с разбитыми раз по пять сердцами. Ребятки откровенно сомневаются, что приложения для знакомств созданы для того, чтобы помочь вам наладить социальные связи — они думают, что это корпорации просто манипулируют всеми, чтобы монетизировать время, проведённое в приложении. Получается вообще история, когда компании зарабатывают на том, чтобы юзеры подольше оставались одинокими.

Это с учётом того, что приложения для знакомств с точки зрения данных тоже знают про пользователей примерно дофига — не только геолокацию и персданные, но и более личные параметры, предпочтения в людях, интересы, темы для разговоров и прочее. Философ Эльза Кугельберг считает, что в целом приложения для знакомств слишком сильно проросли в современное общество, чтобы просто так отвалиться, но вот эпоха свайпов, видимо, и вправду подходит к концу.

Так чем поможет нейросеть?

Одни думают, что ИИ и чатботы станут просто ещё одним фасадом на приложениях, которые всё меньше и меньше интересны людям. Другие — что функции нейросети смогут помочь тщательнее отбирать партнёров и лучше модерировать цифровое пространство для общения.

Третьи считают, что это всё бесполезняк — мол, да не можете вы навесить на вышедший из моды продукт ИИ и сказать — смари, чего сделал, теперь всё работает, пользуйтесь.

А что думаете вы?

Поможет ли нейросеть приложениям для знакомств?
Всего голосов:


Как бы там ни было со знакомствами, мы продолжаем собирать в нашем боте в телеграм самые актуальные модели нейросетей, которые вы можете использовать для любых своих задач, от серьёзной исследовательской работы до генерации картинок и вопросов вида «Почему я не нравлюсь девочкам с Патриков» — бесплатно и в удобном интерфейсе.

Реклама ИП Шрейдер Илья Евгеньевич ИНН 650119155680 erid: 2SDnjd5eyMV
Показать полностью 1
Отличная работа, все прочитано!

Темы

Политика

Теги

Популярные авторы

Сообщества

18+

Теги

Популярные авторы

Сообщества

Игры

Теги

Популярные авторы

Сообщества

Юмор

Теги

Популярные авторы

Сообщества

Отношения

Теги

Популярные авторы

Сообщества

Здоровье

Теги

Популярные авторы

Сообщества

Путешествия

Теги

Популярные авторы

Сообщества

Спорт

Теги

Популярные авторы

Сообщества

Хобби

Теги

Популярные авторы

Сообщества

Сервис

Теги

Популярные авторы

Сообщества

Природа

Теги

Популярные авторы

Сообщества

Бизнес

Теги

Популярные авторы

Сообщества

Транспорт

Теги

Популярные авторы

Сообщества

Общение

Теги

Популярные авторы

Сообщества

Юриспруденция

Теги

Популярные авторы

Сообщества

Наука

Теги

Популярные авторы

Сообщества

IT

Теги

Популярные авторы

Сообщества

Животные

Теги

Популярные авторы

Сообщества

Кино и сериалы

Теги

Популярные авторы

Сообщества

Экономика

Теги

Популярные авторы

Сообщества

Кулинария

Теги

Популярные авторы

Сообщества

История

Теги

Популярные авторы

Сообщества

Недвижимость и ремонт

Теги

Популярные авторы

Сообщества