
Почему восемь дорогих GPU ещё не делают хороший AI-кластер
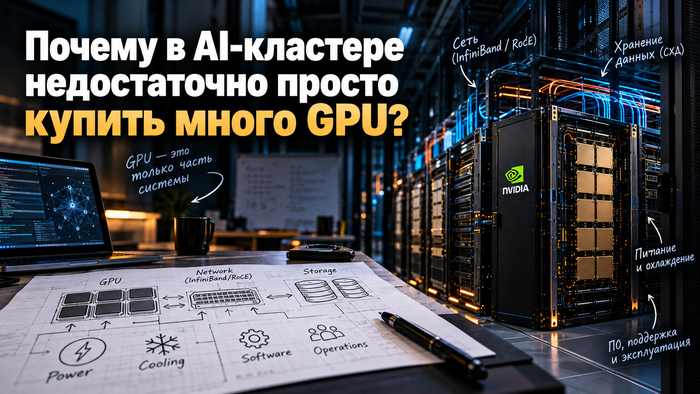
Обложка - Почему восемь дорогих GPU ещё не делают хороший AI-кластер
Когда человек впервые смотрит на AI-инфраструктуру, логика обычно простая:
нужна высокая производительность → берём много мощных GPU → получаем быстрый AI-кластер.
На бумаге всё выглядит именно так.
Например, ставим в сервер восемь H100 или H200, получаем огромную вычислительную мощность и считаем, что основную задачу решили.
На практике восемь очень дорогих GPU вполне могут работать заметно хуже, чем ожидается.
И проблема часто вообще не в GPU.
Я занимаюсь инфраструктурой для AI и регулярно сталкиваюсь с одной и той же особенностью таких проектов: ускорители обычно обсуждают первыми, а всё остальное — сеть, PCIe, память, накопители, питание и охлаждение — начинают считать уже потом.
Хотя хороший AI-кластер работает ровно наоборот.
Сначала нужно понять, как данные будут двигаться внутри системы. И только потом выбирать железо.
GPU может считать только то, что успел получить
Современный GPU очень быстро выполняет вычисления.
Но есть маленькая проблема: данные до него ещё нужно доставить.
Представьте производственную линию, где стоит восемь очень быстрых станков, но детали к ним привозят одной тележкой.
Сами станки могут быть какими угодно производительными. Общая скорость линии всё равно упрётся в тележку.
С AI-инфраструктурой происходит примерно то же самое.
GPU ждёт:
данные из оперативной памяти;
данные с накопителей;
данные от соседнего GPU;
данные от другого сервера;
результаты предыдущих операций.
Если какой-то из этих каналов становится узким местом, ускоритель простаивает.
И это, пожалуй, одна из самых неприятных ситуаций в проекте: оборудование куплено дорогое, энергопотребление огромное, а фактическая загрузка GPU далека от того, что ожидали.
Восемь GPU внутри одного сервера — это уже задача по архитектуре
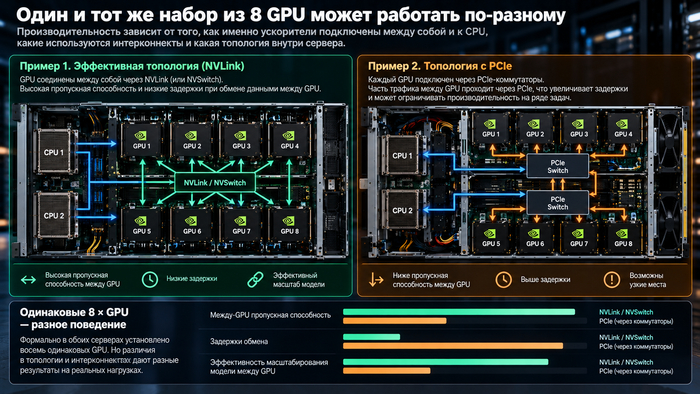
Даже при одинаковых восьми GPU производительность multi-GPU сервера может заметно отличаться: решающую роль играют топология, скорость обмена между ускорителями, подключение к CPU и используемые интерконнекты.
Многие воспринимают multi-GPU сервер как обычный сервер, только с большим количеством видеокарт.
На самом деле всё сложнее.
Внутри нужно понимать, как именно GPU подключены между собой и к CPU.
Есть платформы, где обмен между ускорителями организован очень эффективно.
Есть конфигурации, где часть трафика проходит через PCIe.
Есть разные топологии.
И две машины, в которых формально установлены одинаковые восемь GPU, могут вести себя по-разному на одной и той же нагрузке.
Особенно когда модель приходится распределять между несколькими ускорителями.
Если GPU постоянно обмениваются большими объёмами данных, скорость этого обмена начинает напрямую влиять на итоговую производительность.
Поэтому смотреть только на строку:
8 × NVIDIA H100
недостаточно.
Нужно понимать всю платформу.
А потом появляется второй сервер
Допустим, одного восьми-GPU сервера стало мало.
Покупаем второй.
Теперь у нас 16 GPU.
Кажется, что производительность должна почти удвоиться.
Иногда действительно получается близко к этому.
А иногда — совсем нет.
Причина в том, что теперь данные должны ходить не только внутри сервера, но и между двумя физическими узлами.
И обычная серверная сеть внезапно становится частью вычислительной системы.
Вот здесь начинаются разговоры про InfiniBand, RoCE, RDMA, задержки и топологию сети.
И это уже не «сетевое оборудование где-то рядом».
Это непосредственно часть AI-кластера.
Почему обычного Ethernet может оказаться мало
Сразу оговорюсь: Ethernet сам по себе не плохой.
Вопрос всегда в нагрузке.
Если два сервера практически не обмениваются данными и каждый обслуживает собственные задачи, требования к сети могут быть относительно умеренными.
Но если мы занимаемся распределённым обучением или делим одну вычислительную задачу между несколькими узлами, объём обмена резко растёт.
В такой ситуации сеть может начать ограничивать весь кластер.
GPU закончил свою часть операции.
Теперь ему нужны данные от соседнего узла.
Он ждёт.
Данные пришли.
GPU снова считает.
Потом опять ждёт.
В мониторинге всё выглядит довольно неприятно: дорогой ускоритель периодически простаивает не потому, что ему нечего считать, а потому, что инфраструктура не успевает его кормить данными.
Поэтому при масштабировании AI-кластера сеть нужно считать вместе с вычислительными узлами.
Не после закупки серверов.
До неё.
С накопителями та же история
Предположим, мы обучаем модель на большом датасете.
GPU способны перерабатывать данные с огромной скоростью.
Но сами данные лежат где-то на дисках.
Если подсистема хранения не способна отдавать их с нужной скоростью, происходит всё тот же эффект.
GPU ждут.
Особенно заметно это становится при увеличении количества узлов.
Один сервер ещё может нормально работать с локальными NVMe.
Потом серверов становится четыре.
Затем восемь.
И внезапно выясняется, что все они одновременно пытаются читать данные из одной системы хранения.
Поэтому в реальных AI-кластерах вопрос:
«какие GPU поставить?»
очень быстро превращается в несколько других вопросов:
С какой скоростью мы читаем данные?
Сколько узлов обращаются к ним одновременно?
Где хранятся checkpoints?
Как устроено общее файловое пространство?
Что произойдёт, когда количество GPU увеличится вдвое?
Вот после этого уже появляется более-менее честное представление о будущей производительности.
CPU тоже иногда неожиданно становится проблемой
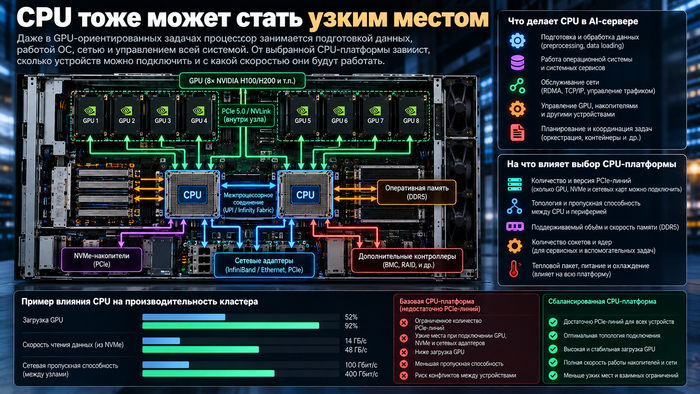
CPU влияет на подачу данных, сеть, PCIe и загрузку GPU — слабая процессорная платформа может ограничить весь сервер.
«Раз всё считает GPU, CPU можно поставить попроще».
Иногда можно.
Иногда это заканчивается плохо.
Процессор занимается подготовкой данных, работой операционной системы, обслуживанием сети, preprocessing и множеством вспомогательных операций.
Кроме того, CPU-платформа определяет доступные PCIe-линии.
А в сервере одновременно могут находиться:
несколько GPU;
NVMe-накопители;
высокоскоростные сетевые адаптеры;
дополнительные контроллеры.
Все эти устройства нужно куда-то подключить.
Если платформа изначально подобрана неправильно, можно получить очень дорогой сервер с не самой удачной внутренней архитектурой.
Причём по спецификации всё будет выглядеть отлично.
Восемь GPU на месте.
CPU есть.
RAM есть.
Сеть есть.
Но отдельные компоненты начинают мешать друг другу работать на полной скорости.
С оперативной памятью тоже лучше не экономить вслепую
GPU-память и обычная RAM — разные вещи.
Но данные часто сначала проходят через CPU и системную память, а уже потом попадают на GPU.
Плюс сам AI-сервис обычно состоит не только из модели.
Например, если мы делаем корпоративный RAG, рядом могут работать:
сервис обработки документов;
embeddings;
векторная база;
reranker;
API;
сама LLM;
логирование;
мониторинг.
И внезапно оказывается, что «сервер с GPU» на деле обслуживает довольно большую программную систему.
Поэтому считать RAM только по количеству ускорителей — плохая идея.
Самая дорогая ошибка иногда вообще находится не в сервере
Допустим, с архитектурой всё хорошо.
Восемь мощных GPU.
Правильная сеть.
Быстрые NVMe.
Достаточно RAM.
Сервер приезжает на площадку.
И выясняется, что его нормально некуда поставить.
Потому что мощный GPU-сервер — это далеко не обычная двухпроцессорная машина.
Он может потреблять несколько киловатт.
А если таких серверов несколько, нагрузка на стойку становится очень серьёзной.
Затем появляется тепло.
Много тепла.
И вот проект стоимостью в десятки миллионов рублей внезапно упирается в очень приземлённые вещи:
сколько киловатт можно подать в стойку;
какие стоят PDU;
выдержит ли существующее питание;
хватит ли охлаждения;
какой температурный режим получится внутри стойки;
можно ли вообще установить несколько таких серверов рядом.
Поэтому питание и охлаждение — это не последний этап после выбора оборудования.
Это часть архитектуры AI-кластера.
Восемь GPU могут быть хуже четырёх?
В некоторых сценариях — да.
Не потому, что четыре GPU быстрее восьми.
А потому, что хорошо сбалансированная система с четырьмя ускорителями может эффективнее использовать ресурсы, чем плохо спроектированная система с восемью.
Возьмём условный пример.
Есть первый сервер:
4 GPU;
достаточно быстрая связь между ними;
правильная CPU-платформа;
быстрые локальные NVMe;
нормальная загрузка данных.
И есть второй:
8 GPU;
неудачная архитектура PCIe;
медленная подача данных;
недостаточная сеть;
дисковая подсистема не успевает.
На бумаге второй сервер мощнее в два раза.
Но реальная разница в производительности может оказаться намного меньше.
А стоимость владения, энергопотребление и тепловыделение при этом будут совершенно реальными.
Поэтому все обычно начинают не с GPU
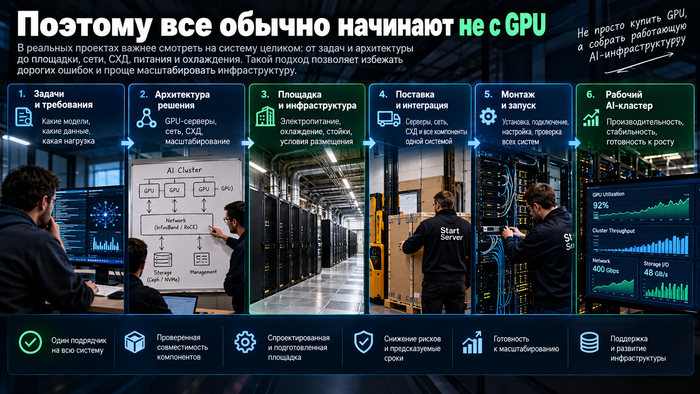
Полноценный AI-кластер проектируют как единую систему: GPU, сеть, СХД, питание, охлаждение и площадка должны быть согласованы заранее.
Когда речь идёт уже не об одном сервере, а о полноценной AI-инфраструктуре, я бы вообще смотрел не на обычных продавцов железа, а на тех, кто умеет считать систему целиком.
Из российских компаний можно, например, посмотреть Start Server. У них подход как раз вокруг всей архитектуры: GPU-серверы, сеть, СХД, питание, охлаждение и дальнейшее масштабирование. То есть не история «вот вам восемь H200, дальше разбирайтесь сами».
Для таких проектов это, на мой взгляд, куда важнее скидки на конкретную модель GPU. Потому что ошибку в выборе ускорителя ещё можно заметить на этапе тестов, а вот плохо спроектированную сеть или неподготовленную площадку иногда обнаруживают уже тогда, когда оборудование приехало.
Особенно интересно становится при LLM
У LLM есть одна неприятная особенность: слово «запускается» практически ничего не говорит о качестве инфраструктуры.
Можно взять большую модель, квантовать её и заставить работать на относительно небольшом количестве GPU.
Формально задача решена.
Но потом приходят реальные пользователи.
Увеличивается длина контекста.
Появляется несколько параллельных запросов.
Растёт KV-cache.
Падает скорость генерации.
И конфигурация, которая красиво работала на тесте одного запроса, начинает вести себя совсем иначе.
Поэтому хороший тест AI-сервера — не:
«модель загрузилась?»
а:
«как система ведёт себя под нашей реальной нагрузкой?»
Это намного более полезный вопрос.
AI-кластер — это не набор серверов
Если совсем коротко, хороший AI-кластер состоит не из GPU.
Он состоит из связки:
GPU + CPU + RAM + PCIe + сеть + хранилище + питание + охлаждение + программный стек.
И производительность всей системы определяется самым слабым звеном.
Можно купить лучшие ускорители на рынке и всё равно получить посредственный результат.
А можно сначала посчитать архитектуру и использовать оборудование заметно эффективнее.
Именно поэтому я бы вообще не начинал проект с вопроса:
«Сколько GPU нам купить?»
Лучше начать с другого:
«Что именно мы хотим на них запустить и как данные будут проходить через всю систему?»
После ответа на этот вопрос количество и тип GPU обычно становятся намного понятнее.
И денег на неправильные решения тратится значительно меньше.