
Своя Алиса?
С преферансомъ и профурсетками!
Да, возможно. Правда требования по железу серьезные. Сейчас так. Подробности ниже.
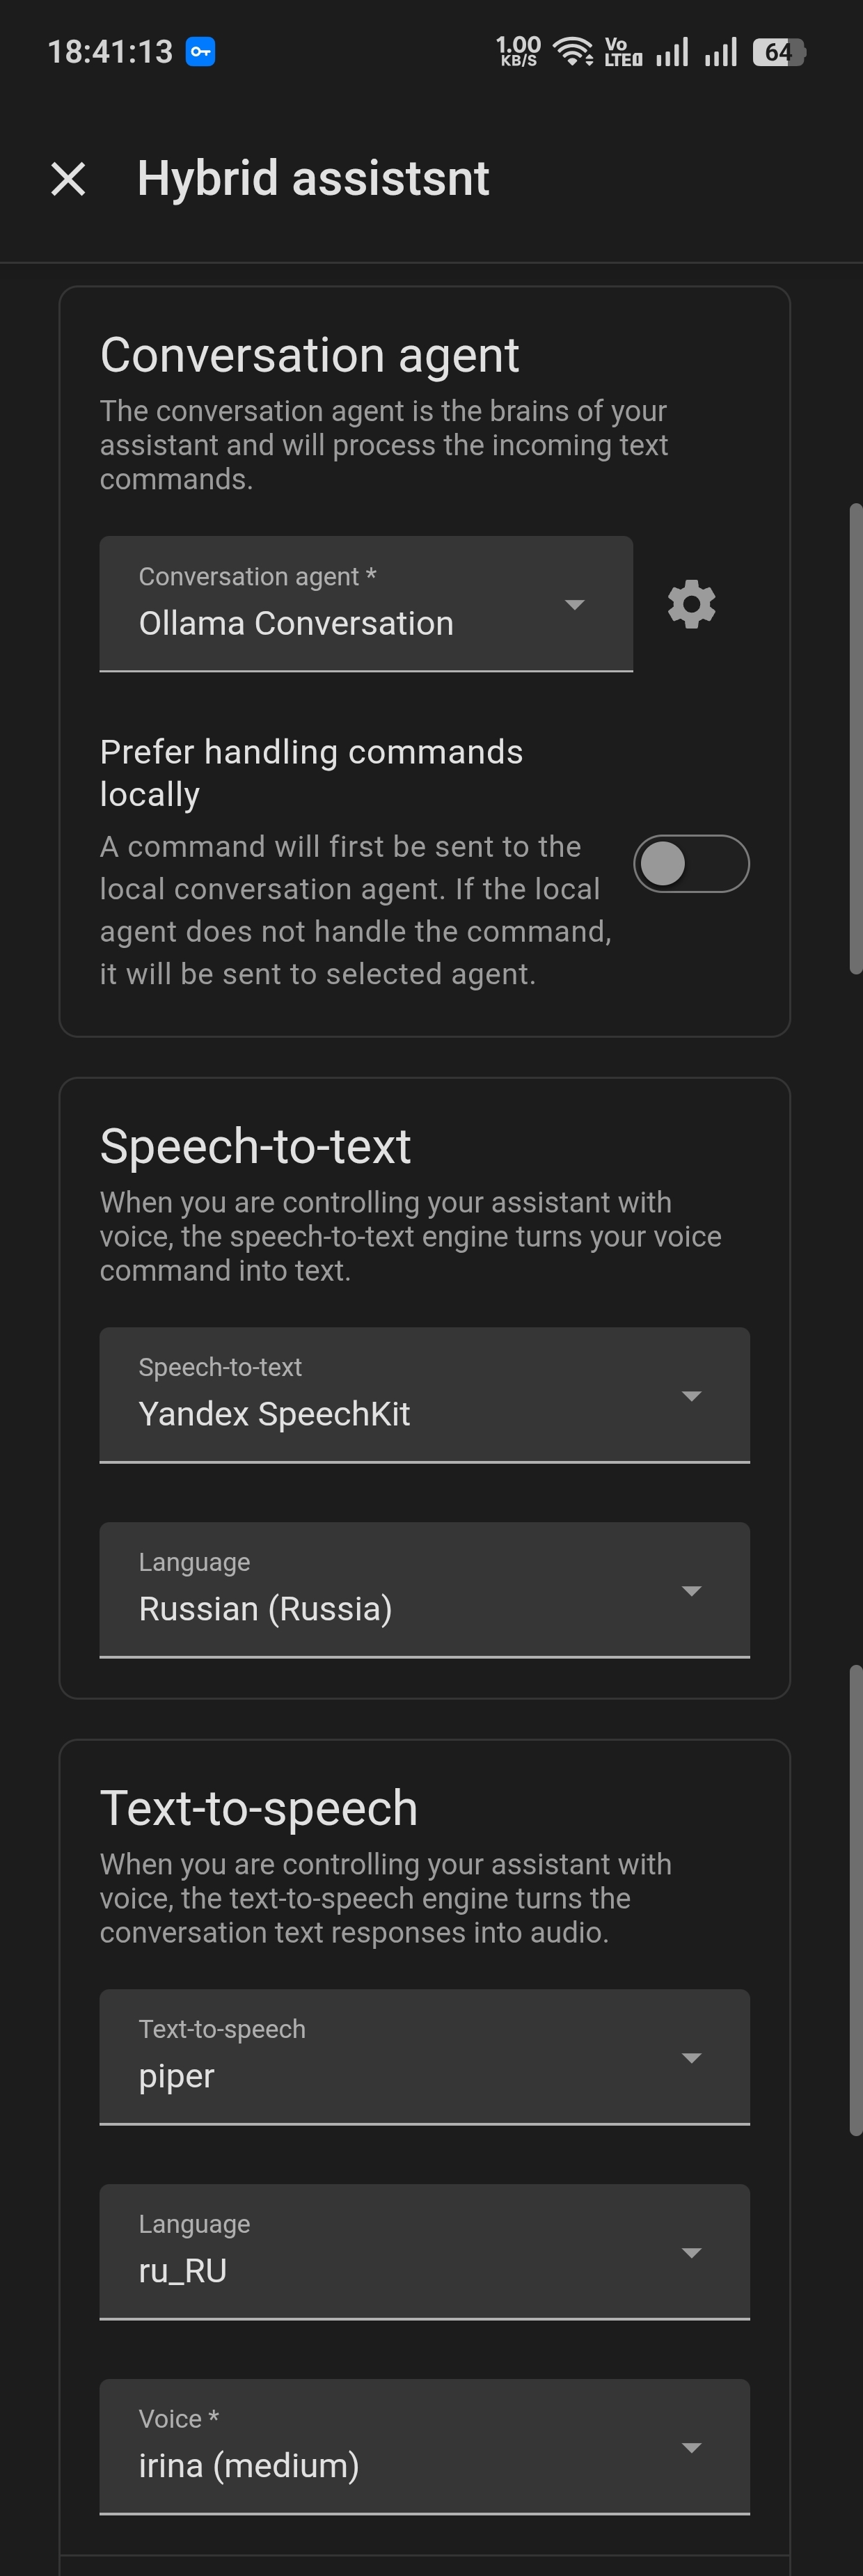
Home assistant база, это понятно.
Wakeword ничего пока лучше я не нашел. Работает конечно, точность 3 запроса из 4х в тишине.
Text-to-speech самый простой, качество до Яндекса конечно недотягивает, но тут оно и не нужно. Говорит понятно и ладно.
А вот распознавание Яндекса прям топ. Отрабатывает на лету. Альтернатив нет. Только ядро HA должно быть не выше 2026.9. Другие системы тоже быстрые, но количество косяков сильно больше. Полностью локальные системы очень медленные. И ошибок много. Хотя железо HA у меня почти топ для минипк - core i3. Хорошая llm часть ошибок компенсирует, но ценой потери времени.
Теперь саме вкусное. LLM Ollama, модель qwen3.5:4b. Железо - 16ти ядерный Xeon, до 2,4ггц, 128Гб DDR3. Это далеко не оптимальное железо, видеокарты вообще нет. Но оно уже есть. По тестам предел потребления был 45% CPU и +30Гб оперативки. Для запуска под виндой вообще ничего не надо, ставим Олламу, загружаем модель, ставим одну галочку и вперед.
Модели серии qwen оказались самыми быстрыми из доступных. Качество отработки и количество ошибок меня устроили.
Ну и последнее дополнение - SearXNG. Выпускает LLM в интернет. Главное в промпт прописать, что поиск в интернете только по команде. Иначе ИИ слишком долго думает.
Настройка не очень сложная. Виртуалка, 16 потоков, до 64Гб памяти динамически. Убунта лучше сразу с докером. Как ставить - ищите в Гугле. Оллама и поисковый сервер на одну виртуалку.
По настройке. Токенов модели я поставил 32к, поиск - выдача 5ти запросов. Минимум 8к/2 выдачи - работает быстрее, но бывают косяки с обработкой инфы из инета.
Вобщем, мне вполне этого набора хватает.

Home Assistant
53 поста1.1K подписчика
Правила сообщества
Сообщество не имеет каких-либо строгих правил для размещения публикаций за исключением офтопа (не по теме сообщества) и публикаций нарушающих правила сайта Pikabu - .