

Я сделал аудиоспектакль по Гаррисону, потому что не смог слушать плохие озвучки
Еще с конца 90х слушал на радио передачу «Модель для сборки»: фантастику читали под электронную музыку, так что рассказ превращался в спектакль. Кто слушал, тот помнит. Кто не слушал, тому сложно объяснить, почему обычная начитка после этого кажется пресной.
Недавно я взялся переслушивать цикл «Мир смерти» Гарри Гаррисона. Первую книгу осилил, вторую дотерпел, а на «Конных варварах» сдался: голос ровный, как диктор прогноза погоды, все персонажи звучат одинаково. И я решил, к черту все, сделаю сам.
Оказалось, что «сделаю сам» растянулось на несколько месяцев вечеров. Зато теперь у меня две озвученные книги, у каждого персонажа свой голос, под сценами играет музыка, а в нужных местах гремят выстрелы и воет местная фауна.
Как это вообще работает
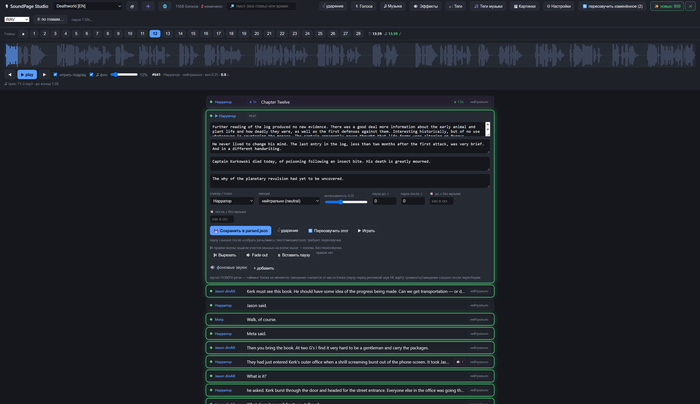
Если коротко, книга проходит через несколько шагов.
Сначала текст надо разобрать на реплики. Кто говорит, какая интонация, где пауза. «— Ты сорвал мою операцию, — процедил он» — это реплика персонажа злым шёпотом плюс слова автора. Первое время этим занималась нейросеть, но она ошибалась непредсказуемо, и я в итоге написал обычные правила разбора. Одно из них мне до сих пор нравится: рассказчик никогда не обращается к слушателю на «ты». Значит, если во фразе есть «ты», это точно говорит персонаж, а не автор.
Потом каждому персонажу выдаётся голос. Голоса синтезированные, их можно описать словами: пожилой ворчливый врач с орлиным носом, молодая женщина-пилот, металлический голос из динамика над дверью. Дальше каждая реплика озвучивается своим голосом со своей эмоцией.
Потом музыка. Её я генерирую отдельно, под настроение каждой сцены: погоня, спор, тишина перед боем. Хитрость вот в чём: обычно музыку приглушают, когда начинается речь. Я сделал наоборот. Музыка всё время тихая, а в паузах между фразами становится громче. Получается, что она дышит вместе с текстом.
Потом звуковые эффекты. Это я добавил уже во второй книге и жалею, что не сразу. Один выстрел в нужную секунду делает для ощущения происходящего больше, чем целый музыкальный трек.

Модалка с генерацией картинок
И наконец картинки и видео, потому что выкладываю я это на YouTube, а туда нужна видеодорожка. Иллюстрации к главам рисует нейросеть по моим описаниям, дальше они медленно наезжают и плывут по экрану.
Побочки
Одна и та же фраза каждый раз звучит по-разному. Переозвучиваешь строчку, а она выходит хуже предыдущей. При этом хорошая уже стёрта. Теперь каждый дубль сохраняется отдельно, и я выбираю лучший из нескольких, как режиссёр на озвучке.
Музыка уезжает. Треки склеены в одну непрерывную ленту, и если музыки написано меньше, чем идёт речь, к концу книги под главой играет мелодия, написанная для предыдущей. Пришлось написать отдельную программу, которая считает, на сколько минут я отстал.
Три версии каждой главы
Мне казалось, что аудиокнига без музыки звучит пусто. Оказалось, так слышат не все.
Я почитал исследования: музыка добавляет эмоций, но сам текст из-за неё воспринимается хуже. А больше всех страдают люди со слабым слухом, потому что слуховой аппарат усиливает и голос, и музыку одинаково, а разделить их не умеет.
И статистика канала это подтвердила: когда все три версии были в открытом доступе, музыкальную выбирала примерно четверть слушателей. Остальные слушали только голос.
Поэтому теперь каждая глава выходит в трёх вариантах: чистый голос, под электронную музыку и под спокойный эмбиент. Кому как нравится.
С версией без музыки, кстати, пришлось повозиться отдельно. Убрал музыку — и вылезла мёртвая цифровая тишина, от которой кажется, что запись оборвалась. Пришлось подкладывать еле слышный «воздух», как в настоящей студийной записи.
Итого
Две книги, около двух с половиной тысяч отдельных кусочков речи в каждой, под тридцать голосов, три версии каждой главы. Всё делает один человек по вечерам после работы.
Самое неожиданное открытие за всё это время: технология тут вообще не главное. Сгенерировать речь сегодня может кто угодно за пять минут. А вот чтобы это перестало звучать как робот, читающий инструкцию к стиральной машине, уходят те самые вечера: расставить паузы, подобрать интонацию каждой реплике, свести музыку так, чтобы она не мешала словам.
Послушать, что вышло: YouTube-канал Sound Page Studio.
Главный вопрос к вам, пикабушники: насколько это слушабельно? Где голос звучит мёртво, где музыка мешает? Критика нужна больше похвалы.
Правда интересно, как это воспринимается со стороны, особенно теми, кто тоже помнит МДС.