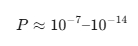2

Ответ на пост «Что про выборы думает математика»⁠⁠

. Ни одного скачка вверх за весь подсчёт. Только плавное снижение."
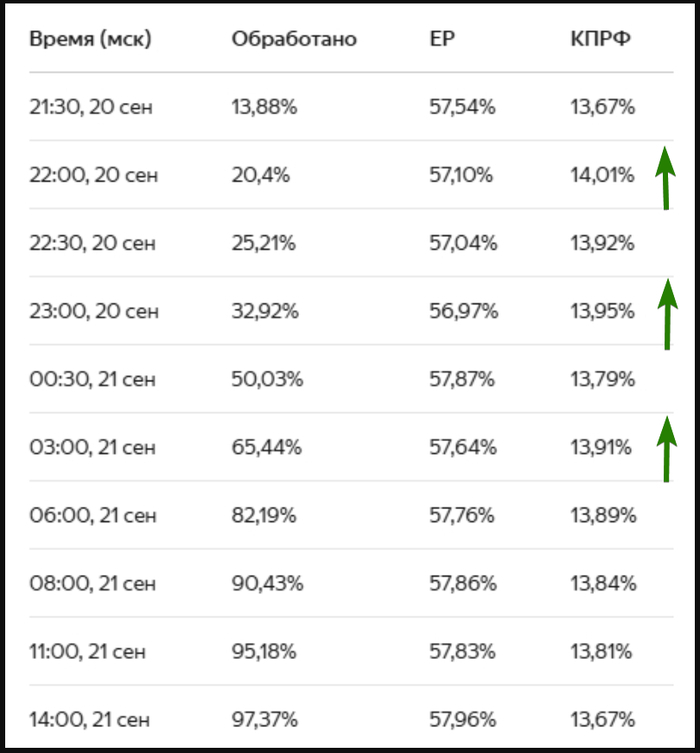
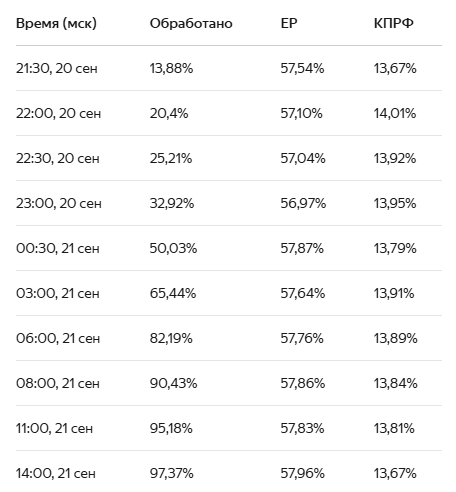
тем временем данные в таблице -

про шансы откуда ты вообще взял эту формулу? что за числа ты вычитаешь друг из друга? и опятьже это было бы справедливо при равном населении регионов.

Чтоже нам говорит математика. Я буду округлять некоторые числа чаще в большую сторону (например не 13.88 а 14 и тд). За всё население рф старше 18 лет я беру цифру 114миллионов (честно я не искал информацию сколько всего бюллетеней обработано. поэтому отталкиваюсь от населения). Разберу только первые две строки.

первая отметка 14%.
это примерно 114 (население 18+) * 0.6 (явка 60)*0.14 (количество проверенного)= 9.5 миллионов голосов. на этой отметке у тебя грубо говоря 5.5 (58% по таблице) миллионов голосов за за ер.
следующая отметка 20%
обработано 114*0.6*0.2 = 13.5 миллионов. подсчитали ещё 4 миллиона. у ЕР *0.57 = 7.6 миллионов. из подисчатнных 4 добавилось 2.1 (7.6-5.5) миллиона что около 53%. (тоесть даже меньше чем в первый подсчёт)

А вот тут начинаем фантазировать. Автор сетует что на прошлых выборах качели были от 5 до 11 п.п. возьмём самое меньшее. 5пп.
чтоб на второй отметке, показатель ЕР опустился на 5пп (стал 53 вместо 59), ЕР должны иметь в копилке 13.5*0.53= 7.1 миллиона голосов. у них там уже лежит 5.5 с прошлого замера. тоесть добавиться НЕ больше 1.6 миллиона голосов. (если мы хотим качели ещё сильнее то ещё меньше). тоесть из подсчитанных 4 миллионов за ЕР должно проголосовать 40 процентов вместо 53.
и эта цифра с каждым подсчётом все растёт и растет.

Какой шанс того что вторая волна голосов будет именно такой?

Ответ на пост «Что про выборы думает математика»
Показать полностью 1

Ответ на пост «Что про выборы думает математика»⁠⁠

И так, мои любимые любители графиков и теорий заговоров. ТС конечно как-то странно все это сравнивает, дело в том, что по мере накопления голосов, сдвинуть "средний" процент все сложнее и сложнее, и по логике больших колебаний то не должно быть, если мы имеем +- минус размазанный рейтинг по стране. И так давайте заглянем, как колебался процент голосов за ЕР по мере обработки бюллетеней именно внутри волны, чуть интересненькое кроется в конце.

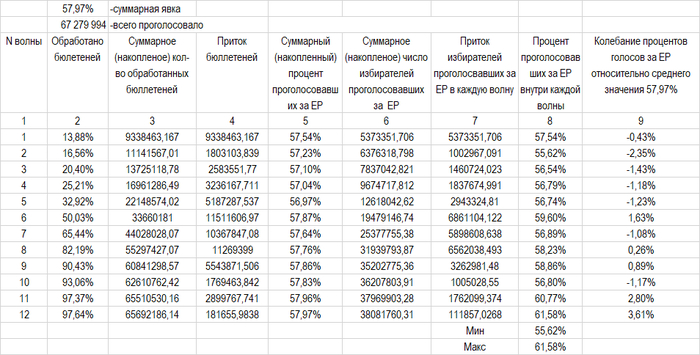
Я несколько развернул первоначальную таблицу ТС проведя расчет, какой процент проголосовавших должен быть внутри каждой волны, чтобы смещать равновесие. Очевидно, чтобы бодяжить общий результат колебание именно по самим волнам должно быть больше.

Расширенная таблица

Расширенная таблица

Столбец 4 - это сколько новых бюллетеней было обработано в текущую волну, т.е. по факту разница между прошлым и текущим накопленным значением в столбце 3

Столбец 6 - это накопленное значение отдавших голос именно за ЕР, т.е. Столбец 3 * столбец 5

Столбец 7 - это сколько бюллетеней было в ту или иную волну именно за ЕР, т.е. по факту разница между прошлым и текущим накопленным значением в столбце 6

Столбец 8 - это процент проголосовавших внутри каждой волны (столбец 7 / столбец 4)

Колебание между мин и макс соответственно составил около 6%, ну ок.

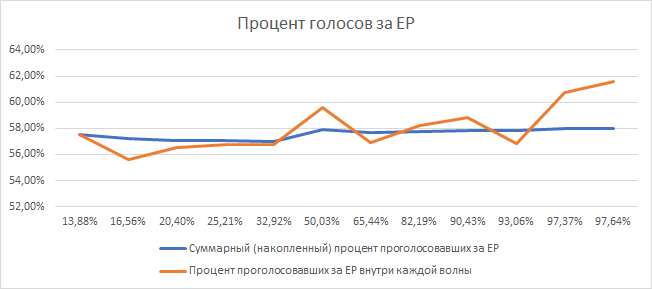
Графики выглядят вот так, даже красивенько, синяя линия это накопленные процент. Оранжевый это грубо говор какими "порциями" разбавлялся общий процент

Пик в конце на самом деле сильно круче, просто я так и не нашел как сделать, чтобы горизонтально ось соответствовала масштабу

Пик в конце на самом деле сильно круче, просто я так и не нашел как сделать, чтобы горизонтально ось соответствовала масштабу

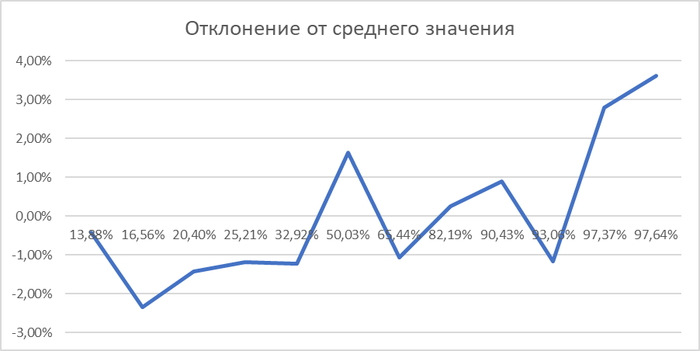
Пик в конце конечно достаточно интересен, с этой мыслью я вас и оставлю).

Показать полностью 3
38

Ответ на пост «Что про выборы думает математика»⁠⁠

Давайте я вам просто нейронку по ту сторону баррикад поставлю, а вы уже там решайте, что вам больше нравится

Основываясь на предоставленных скриншотах, автор делает вывод, что процесс подсчета голосов на выборах в Госдуму 2026 года был «управляемым», поскольку процент голосов за «Единую Россию» оставался аномально стабильным (разброс всего 0,89 процентных пункта) на протяжении всего времени подсчета.

Однако представленная математическая методика содержит ряд серьезных изъянов и некорректных допущений. Вот подробное опровержение этой аргументации:

1. Ложная посылка о последовательном вводе данных целыми регионами («Модель 2») Фундаментальная ошибка автора кроется в его второй модели, которую он выдает за «реальность». Он утверждает, что «протоколы поступают батчами из регионов», и строит свои расчеты вероятности на том, что система обрабатывает результаты строго последовательно, блок за блоком (например, сначала результаты одного региона, затем другого с совершенно иным средним значением).

Как это работает на самом деле: Система ГАС «Выборы» не ждет, пока отчитается весь регион, чтобы добавить его в общую копилку. Данные вводятся массивно параллельно территориальными избирательными комиссиями (ТИК) по всей стране по мере готовности протоколов. В любой момент времени в общую статистику стекаются данные из Сибири, Урала, Поволжья и Центральной России одновременно.

Следствие: Из-за этого параллельного потока результаты перемешиваются. Различия между регионами сглаживаются, так как они поступают не монолитными «мешками» (как в аналогии с пончиками), а непрерывным, смешанным потоком. Таким образом, реальный процесс агрегации гораздо ближе к отвергнутой автором «Модели 1» (случайное/параллельное поступление), при которой вероятность такого ровного графика оценивается самим автором в 95–99%.

2. Игнорирование Закона больших чисел Анализ автора начинается с отметки, когда обработано 13,88% протоколов.

В масштабах всероссийских выборов 13,88% — это колоссальная выборка (миллионы голосов и тысячи участков).

Согласно закону больших чисел теории вероятностей, при таком огромном объеме данных бегущее среднее значение уже должно максимально приблизиться к итоговому результату всей генеральной совокупности. Даже если в следующих порциях поступят данные из регионов с аномальным голосованием (например, из Чечни), их вес будет «размыт» уже накопленными миллионами голосов, и они не смогут радикально сдвинуть общую кривую.

3. Некорректное сравнение с выборами в США Автор приводит в пример колебания процента на выборах в США 2020 года («красный мираж» и «синий сдвиг»), утверждая, что так должно быть везде.

Это ложная аналогия. В США резкие скачки были обусловлены систематическим смещением в порядке подсчета разных типов бюллетеней, а не географией. Как справедливо отмечает сам автор, почтовые бюллетени (в которых преобладали голоса за демократов) во многих штатах по закону считались в последнюю очередь.

В России нет такого жесткого, законодательно закрепленного порядка, который предписывал бы сначала считать, например, участки в протестных городах, а затем в лояльных селах. Отличия в скорости обусловлены в основном часовыми поясами, что дает более плавное и предсказуемое смещение, не способное вызвать скачки на 14 пунктов при непрерывном смешивании данных.

4. Ошибка весовых коэффициентов («Москва против Чечни») Автор акцентирует внимание на разнице результатов: ~30% в Москве и ~99% в Чечне, подразумевая, что добавление результатов Чечни должно сильно дернуть график.

Здесь игнорируется демографический вес. Население регионов-«электоральных султанатов» относительно невелико на фоне всей страны. Их 99% при добавлении в общую базу, где уже лежат десятки миллионов голосов из крупных урбанизированных регионов с более низким процентом поддержки, математически не способны вызвать резкий скачок федерального процента на поздних этапах агрегации.

5. Смешение аргументов Автор перечисляет другие нарушения: разрыв между бумажным и электронным голосованием (ДЭГ), отсутствие наблюдателей на участках и т.д..

Эти факторы действительно могут указывать на проблемы с чистотой самих выборов и фальсификации на местах. Однако они никак не спасают математическую модель автора. Тот факт, что график оставался ровным, является закономерным следствием параллельной обработки массивов данных национального масштаба, а не доказательством программной «корректировки цифр» в ходе самого процесса агрегации, как утверждает автор.

Вывод: Методика опровергается тем, что она базируется на нереалистичной модели последовательного порегионального ввода данных. Из-за параллельного и одновременного поступления данных со всей страны вступает в силу закон больших чисел, который математически обосновывает быструю стабилизацию итогового процента уже на ранних этапах подсчета огромного числа голосов.

Показать полностью
6019

Что про выборы думает математика⁠⁠

Всем привет. После выборов в Госдуму 2026 я решил посмотреть, как менялся процент «Единой России» в ходе подсчёта голосов — от первого протокола до последнего. Результат оказался... интересным.


Сначала — просто таблица

Я собрал данные ЦИК по мере обработки протоколов, для наглядности добавил еще и КПРФ:

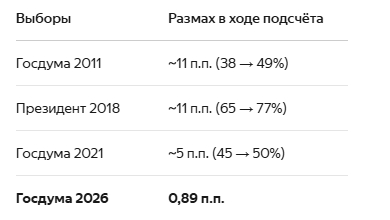
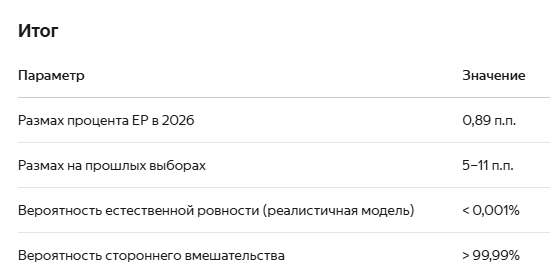
Размах ЕР за весь подсчёт: 0,89 процентных пункта. С первого замера до последнего.


Почему это странно

В России 85 регионов. Результат ЕР в них — от ~30% в Москве до ~99% в Чечне. Протоколы поступают не по одному, а батчами из регионов — целый район отчитался, и процент скачет.

На всех предыдущих выборах так и происходило:

Та же система. Те же регионы. Та же разница между Москвой и Чечнёй. Но раньше процент «гулял» на 5–11 пунктов, а теперь — меньше одного.


Как это выглядит в других странах

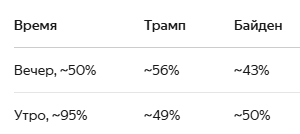
Для контекста — выборы в США 2020. В Пенсильвании порядок подсчёта зависит от типа бюллетеня: голоса дня выборов считаются первыми (за республиканцев), почтовые — последними (за демократов). Поэтому происходит вот что:

Переворот на 14 процентных пунктов. Это называется «красный мираж» и «синий сдвиг» — и это не фальсификация, а просто разный порядок подсчёта разных типов бюллетеней.

В Джорджии и Висконсине лидер менялся за ночь. В России — ни разу.

Американские колебания можно проверить: видно, из какого округа пришла порция голосов и почему процент изменился. Ровность российского процента проверить нельзя — потому что непонятно, почему он ровный.


Аномалии 2026

Помимо ровности процента, зафиксированы конкретные странности:

Расхождение ДЭГ и бумажного голосования. На бумажных — ЕР 57,83%, на электронных — 49,06%. А «Новые люди» на ДЭГ получили 15,42% против 7,96% на бумаге. Разрыв почти 9 п.п. Данные ДЭГ не публикуются на уровне участков — проверить невозможно.

Участки без наблюдателей. В Муринском округе на 7 участках без наблюдателей ожидается результат 80–90% за ЕР. На соседних 21 участке, где наблюдатели были — ЕР и КПРФ шли почти поровну.

«Султанаты». Чечня — 99,85%. Мордовия — 77,97%. Явка в Дагестане — ~87%. Всё как всегда.

КПРФ — зеркальная картина. Экзитполы дали 14,2–14,8%. Финал — 13,65%. Ни одного скачка вверх за весь подсчёт. Только плавное снижение.


Математика: какова вероятность?

Я посчитал двумя способами.

Модель 1: протоколы поступают случайно. Если бы 96 000 протоколов шли в случайном порядке, то после 13 000 первых среднее значение уже усреднилось бы с погрешностью ~0,14 п.п. Полоса 0,89 п.п. — это 6 стандартных отклонений. Вероятность остаться в полосе — около 95–99%.

Но протоколы не поступают случайно. Они приходят батчами из регионов.

Модель 2: протоколы поступают регионами (реальность). Когда первый регион отчитывается, бегущее среднее равно среднему этого региона. Вероятность, что оно окажется в полосе 57,07–57,96% — около 4%. Для всех регионов на протяжении всего подсчёта:

Вероятность того, что процент сам по себе остался ровным при географическом батчинге — менее 0,001%.


Аналогия с пончиками

Представьте конкурс пончиков. 96 000 дегустаторов. Шоколадный пончик получил от 30% до 99% в разных районах города. Но итоговый процент держится в коридоре 0,89 пункта с первого замера до последнего.

В одном районе все любят шоколад. В другом — ненавидят. Результаты приходят из районов мешками. А процент — ровный.

Либо кто-то очень тщательно сортировал эти мешки перед подачей. Либо цифры корректировались. Но сам по себе, без управления, такой ровный результат при разбросе от 30% до 99% — статистически невозможен.


Итог

Я не утверждаю, что «выборы сфальсифицированы» — это юридический термин, и его устанавливает суд. Я говорю о другом: математика показывает, что процесс подсчёта был управляемым. Ровность процента — не признак честности. Это признак контроля.

А что вы думаете? Пишите в комменты.


Ссылки для модераторов:

Динамика процента ЕР и КПРФ в ходе подсчёта

ДЭГ vs бумажное голосование

Экзитполы

«Султанаты»

Сравнение с прошлыми выборами
Показать полностью 5
Отличная работа, все прочитано!

Темы

Политика

Теги

Популярные авторы

Сообщества

18+

Теги

Популярные авторы

Сообщества

Игры

Теги

Популярные авторы

Сообщества

Юмор

Теги

Популярные авторы

Сообщества

Отношения

Теги

Популярные авторы

Сообщества

Здоровье

Теги

Популярные авторы

Сообщества

Путешествия

Теги

Популярные авторы

Сообщества

Спорт

Теги

Популярные авторы

Сообщества

Хобби

Теги

Популярные авторы

Сообщества

Сервис

Теги

Популярные авторы

Сообщества

Природа

Теги

Популярные авторы

Сообщества

Бизнес

Теги

Популярные авторы

Сообщества

Транспорт

Теги

Популярные авторы

Сообщества

Общение

Теги

Популярные авторы

Сообщества

Юриспруденция

Теги

Популярные авторы

Сообщества

Наука

Теги

Популярные авторы

Сообщества

IT

Теги

Популярные авторы

Сообщества

Животные

Теги

Популярные авторы

Сообщества

Кино и сериалы

Теги

Популярные авторы

Сообщества

Экономика

Теги

Популярные авторы

Сообщества

Кулинария

Теги

Популярные авторы

Сообщества

История

Теги

Популярные авторы

Сообщества

Недвижимость и ремонт

Теги

Популярные авторы

Сообщества