user12093453

user12093453

На Пикабу
Дата рождения: 12 ноября
100 рейтинг 1 подписчик 0 подписок 4 поста 0 в горячем
1

Claude в России: что работает, что нет и как получить доступ⁠⁠

Claude в России: что работает, что нет и как получить доступ
Коротко

«Claude в России» — вопрос без единого ответа, потому что Claude это не один продукт, а четыре. Если вам нужна модель для кода или продукта — доступ есть и он несложный. Если нужен именно интерфейс claude.ai — там всё сложнее и надёжного решения нет.

Веб-интерфейс

Anthropic публикует список стран, где сервис поддерживается, и России в нём нет. Пользователи из России сообщают об отказах при регистрации и входе.

Обычный путь, который тут пробуют, — VPN. С интерфейсом он иногда срабатывает, но у него две проблемы, о которых стоит знать заранее.

Первая: регистрация упирается не только в адрес. Нужен номер телефона, а на этапе оплаты — карта, выпущенная в поддерживаемой стране. Смена IP на это не влияет.

Вторая: доступ нестабилен. Сегодня работает, завтра нет, и в момент, когда он отвалится, у вас может лежать незавершённая работа.

Отдельно предупредим про покупку готовых аккаунтов: это чужой ключ и чужая карта, отзывают такой аккаунт вместе с вашим балансом и историей.

Подписка Claude Pro

Даже если интерфейс открылся, подписка — это регулярный платёж зарубежной картой. Здесь VPN не помогает вовсе: платёж проверяется по стране выпуска карты, а не по адресу, с которого открыт сайт.

Стоит понимать, что именно вы покупаете за подписку и что — за ключ: это два разных продукта и два разных счёта. Подробный разбор с расчётом точки окупаемости — здесь.

API — рабочий путь

Здесь всё проще, чем кажется, и именно этим путём идёт большинство.

Модели Claude доступны через российские шлюзы, которые совместимы с форматом OpenAI. В коде это две строки — адрес и ключ:

from openai import OpenAI client = OpenAI( api_key="sk-...", base_url="https://api.altrouter.ai/v1", ) r = client.chat.completions.create( model="claude-sonnet-5", messages=[{"role": "user", "content": "Разбери этот текст на тезисы"}], max_tokens=2000, ) print(r.choices[0].message.content)

Ни VPN, ни зарубежной карты, ни аккаунта у Anthropic. Оплата рублями, в том числе через СБП.

Какие модели Claude доступны

В нашем каталоге девять моделей семейства, цены за 1M токенов на день публикации:

МодельВходВыходКонтекстClaude Haiku 4.5$0.77$4.00200KClaude Sonnet 5$1.69$8.50200KClaude Sonnet 4.5$2.68$13.50200KClaude Sonnet 4.6$2.68$13.50200KClaude Opus 4.5$3.74$18.75200KClaude Opus 4.6$3.99$20.00200KClaude Opus 4.7$3.99$20.00200KClaude Opus 4.8$4.50$22.50200KClaude Fable 5$6.00$30.00200K

Практическая подсказка по выбору: Haiku — для массовых формальных задач, где важна скорость и объём; Sonnet 5 — рабочая лошадка с лучшим соотношением цены и качества; Opus — когда надо думать, а не выполнять; Fable — под тексты, где важен стиль.

Старые версии мы не прячем и не удаляем: если у вас на проде закреплена конкретная версия, она продолжит работать, а не исчезнет в момент выхода следующей.

Claude Code: честно

Через наш шлюз Claude Code сейчас не работает. Он обращается к Anthropic-совместимому эндпоинту /v1/messages, а мы отдаём OpenAI-совместимый /v1/chat/completions. Подставить наш адрес и получить работающий агент не выйдет — упрётесь в ошибку, и это не опечатка в конфиге.

У части российских шлюзов Anthropic-совместимый эндпоинт уже есть. Если ваш сценарий — именно Claude Code, выбирайте по этому признаку.

Что с нашим ключом работает уже сегодня: библиотека openai и всё, что через неё ходит, редакторы и агенты с настраиваемым адресом API в формате OpenAI, оболочки вроде Open WebUI и LibreChat, автоматизации.

Что ломается чаще всего

Три ошибки, которые встречаются у тех, кто только подключился.

529 в пиковые часы. Это не блокировка и не ваш лимит — модель перегружена у вендора. Лечится повтором с нарастающей задержкой или переключением на соседнюю модель. Полный разбор кодов — в отдельной статье.

Обрезанный ответ. Кода ошибки нет, HTTP 200, а текст оборван. Это max_tokens, а не баг. Запрос без явного значения мы ограничиваем 4096 токенами.

HTML вместо JSON. Значит, до API вы не дошли — сработал защитный фильтр по дороге. Чаще всего виноват включённый VPN, почему так.

Что выбрать под вашу задачу

  • Нужен чат для себя, кода не пишете. Ваш вариант — интерфейс, и тут либо возня с VPN и оплатой, либо российский сервис с оболочкой поверх моделей. Ключ вам не нужен: его некуда вставить.

  • Пишете код или продукт. Ключ через шлюз, две строки, оплата рублями.

  • Работаете в Claude Code. Смотрите на наличие /v1/messages у шлюза — у нас его пока нет.

  • Нужны несколько вендоров сразу. Тогда агрегатор, как выбирать.

Попробовать модели без вложений можно на $1, которые начисляются за подтверждённый Telegram — на сотню-другую запросов к Haiku этого хватает.

FAQ

Работает ли Claude в России?

Зависит от того, что именно нужно. Веб-интерфейс claude.ai упирается в список поддерживаемых стран, подписка — в оплату зарубежной картой. А вот модели Claude через API доступны: российские шлюзы с OpenAI-совместимым форматом отдают их без VPN и с оплатой рублями.

Как оплатить Claude из России?

Напрямую Anthropic — только картой, выпущенной в поддерживаемой стране; VPN на это не влияет, потому что проверяется страна карты, а не адрес. Через российский шлюз баланс пополняется рублями, в том числе через СБП, и подписка не требуется — оплата идёт за фактически израсходованные токены.

Какая модель Claude лучше и сколько стоит?

Для массовых формальных задач — Haiku 4.5 ($0.77 за 1M входных токенов), как универсальная рабочая — Sonnet 5 ($1.69), для задач, требующих рассуждения, — Opus 4.8 ($4.50), для текстов со стилем — Fable 5 ($6.00). Контекст у всех 200 000 токенов.

Можно ли подключить Claude Code из России?

Технически да, но не через любой шлюз: Claude Code ходит в Anthropic-совместимый /v1/messages, и он есть не у всех. У нас его сейчас нет — доступен OpenAI-совместимый интерфейс, с которым работают редакторы и агенты с настраиваемым адресом API.

Нужен ли VPN для работы с Claude API?

Для работы через российский шлюз — нет, запрос идёт на российский адрес. Более того, включённый VPN часто мешает: выходные узлы попадают под защитные фильтры, и вместо ответа API приходит HTML-страница с отказом.

Стоит ли покупать готовый аккаунт Claude?

Нет. Это чужой ключ, привязанный к чужой карте и чужой ответственности; при блокировке вы теряете и доступ, и остаток на балансе, и историю переписки. Ключ через легальный шлюз стоит дешевле и принадлежит вам.
Показать полностью 1
1

Вайбкодинг: что это такое и сколько он стоит на самом деле⁠⁠

Вайбкодинг: что это такое и сколько он стоит на самом деле

Коротко

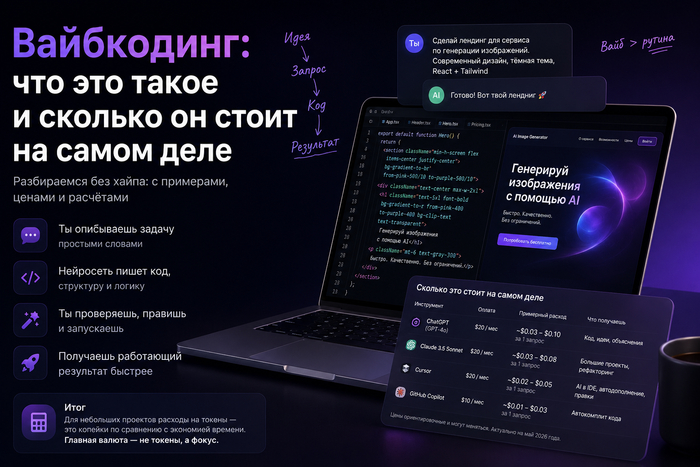
Вайбкодинг — способ работы, при котором вы описываете задачу словами, а код пишет модель. Вы правите не строки, а формулировку и результат. Термин пишут и слитно, и раздельно — «вайбкодинг» и «вайб кодинг», это одно и то же.

Ключевое отличие от автодополнения: автодополнение помогает вам писать код, вайбкодинг пишет его вместо вас. Вы становитесь ревьюером и постановщиком задачи, а не автором строк.

Что это стоит: при обычном режиме работы от $17 до $99 в месяц в зависимости от выбранной модели. Расчёт ниже, он несложный.

И сразу неприятная часть, которую в восторженных статьях пропускают: ощущение скорости в вайбкодинге устойчиво обгоняет реальную скорость. Разбор этого — отдельный раздел, и он, пожалуй, самый полезный в статье.

Откуда взялся термин

Слово появилось как ироничное: писать код «на вайбах», не вчитываясь в то, что сгенерировала модель, — принять, запустить, посмотреть, работает ли.

Дальше произошло обычное: ирония прижилась, а смысл расширился. Сегодня «вайбкодингом» называют весь спектр — от «сгенерировал лендинг за вечер и не читал» до «веду промышленную разработку с агентом, но каждый диff читаю глазами».

Из-за этого разговоры и буксуют: один человек имеет в виду первое, другой второе. Полезнее говорить не о вайбкодинге вообще, а о том, на каком уровне доверия к модели вы работаете.

Три уровня доверия

Автодополнение

Модель предлагает продолжение строки или функции, вы принимаете или нет. Автор кода — вы. Риск минимальный, выигрыш небольшой, но постоянный.

Задача в чате

Вы описываете, что нужно, получаете кусок кода, вставляете и правите. Автор — уже пополам. Здесь появляется главная ловушка: проверять чужой код дольше, чем писать свой, и на мелких задачах это съедает всю выгоду.

Агент

Модель сама читает файлы, вносит правки, запускает тесты, чинит по результату. Вы ставите задачу и проверяете итог. Вот это и есть вайбкодинг в нынешнем смысле.

Выигрыш здесь настоящий и заметный. И риск тоже настоящий: агент уверенно делает не то, что вы имели в виду, если задача была сформулирована приблизительно.

Почему ощущение скорости врёт

Самое честное наблюдение из практики, и оно повторяется у многих.

Работа с агентом ощущается быстрой, потому что исчезает самая утомительная часть — набор текста. Вы не пишете обвязку, не вспоминаете сигнатуру, не переключаетесь на документацию. Субъективно кажется, что сделали дневную норму за час.

Но время не исчезло, оно переехало:

  • Чтение диффа. Двести строк, которые модель написала за минуту, вы читаете десять.

  • Уточнение задачи. Половина итераций уходит не на код, а на объяснение того, что вы имели в виду.

  • Откаты. Агент пошёл не туда, и вы возвращаетесь на три шага назад.

  • Отладка чужой логики. Свой баг вы помните. Чужой ищете с нуля.

Практический вывод: выигрыш реален там, где задача объёмная и рутинная, и близок к нулю там, где задача маленькая и требует точности. Переписать двести обработчиков под новый интерфейс — идеально. Поправить хитрое условие в биллинге — быстрее самому.

Что нужно, чтобы начать

Три вещи.

Редактор или агент. Инструментов много, они делятся на встроенные в редактор и работающие в терминале. Выбирать стоит по тому, как вы работаете, а не по обзорам: если вы живёте в IDE — берите то, что встраивается, если в терминале — терминальное.

Модель. Здесь важнее, чем кажется: разница между моделями на кодовых задачах больше, чем на текстовых. Экономить на этом можно, но осознанно.

Доступ к модели — ключ или подписка. Что дешевле в вашем случае, разбирали отдельно: для агентской работы почти всегда ключ, потому что агент делает десятки вызовов там, где человек написал бы один.

Сколько это стоит

Считаем на реальных цифрах. Одна задача агенту — это примерно 50 000 входных токенов (он читает файлы, историю, вывод тестов) и 10 000 выходных (правки и объяснения). Это грубая средняя: рефакторинг по большому проекту дороже, точечная правка дешевле.

Возьмём рабочий режим — 10 задач в день, 22 рабочих дня.

МодельЦена задачиВ месяцClaude Haiku 4.5$0.079~$17Claude Sonnet 5$0.169~$37GPT-5.6$0.234~$51Claude Opus 4.8$0.450~$99

Три вещи, которые видно из таблицы.

Разброс всего в шесть раз. Между самой дешёвой и самой дорогой моделью — $82 в месяц. Для работы это несущественная сумма, и экономить на модели, теряя качество правок, — плохая сделка.

Основные деньги — во входных токенах. Агент читает намного больше, чем пишет. Отсюда главный рычаг экономии: не давать ему читать лишнее.

Счёт растёт не от числа задач, а от их размера. Одна задача по большому репозиторию стоит как десять мелких.

Как этот счёт снижать целенаправленно — отдельный разбор. Список моделей с актуальными ценами — на витрине, а какую взять под какую задачу — здесь.

Пять граблей

  1. Задача сформулирована приблизительно. «Сделай нормально» даёт результат, который надо переделывать. Тридцать секунд на уточнение экономят двадцать минут на откат.

  2. Нет тестов. Без них вы не знаете, сломал ли агент что-то соседнее. С агентом тесты перестают быть роскошью и становятся условием работы.

  3. Слишком большой контекст. Закинуть весь репозиторий кажется правильным, но модель хуже работает с шумом, а платите вы за каждый токен дважды — деньгами и качеством.

  4. Принятие без чтения. Тот самый исходный смысл слова. На прототипе допустимо, на проде — нет.

  5. Один агент на всё. Дешёвая модель прекрасно делает механические правки, дорогая нужна там, где надо думать. Смешивать выгоднее, чем выбирать.

Честно про ограничения

Claude Code через наш шлюз сейчас не работает. Он обращается к Anthropic-совместимому /v1/messages, а у нас OpenAI-совместимый /v1/chat/completions. Если ваш инструмент — именно Claude Code, наш ключ туда не подставится.

Что работает: любой редактор и агент, у которого адрес API настраивается и формат OpenAI-совместимый, а также всё, что ходит через библиотеку openai.

И ещё одно, менее очевидное. Вайбкодинг не отменяет необходимости понимать код. Он снимает набор текста, а не ответственность: разбираться, почему прод упал, будете вы, а не модель. Люди, у которых с ним получается лучше всего, — это те, кто и без него писал нормально.

FAQ

Что такое вайбкодинг простыми словами?

Это способ разработки, при котором вы описываете задачу словами, а код пишет языковая модель. Вы переходите из роли автора строк в роль постановщика задачи и ревьюера: проверяете результат, уточняете формулировку, принимаете или откатываете правки.

Чем вайбкодинг отличается от автодополнения кода?

Масштабом принимаемого решения. Автодополнение предлагает продолжение строки, автором кода остаётесь вы. При вайбкодинге модель сама читает файлы, вносит правки и запускает тесты, а вы проверяете итог. Выигрыш больше, но и цена ошибки выше.

Сколько стоит вайбкодинг в месяц?

При режиме в 10 задач в день выходит примерно от $17 на Claude Haiku 4.5 до $99 на Claude Opus 4.8. Основная часть счёта — входные токены: агент читает намного больше, чем пишет, поэтому дешевле всего экономить на объёме контекста, а не на классе модели.

Правда ли, что с ИИ разработка идёт в разы быстрее?

Ощущение скорости заметно опережает реальную скорость, потому что исчезает самая утомительная часть — набор текста. Время переезжает в чтение диффов, уточнение задач и откаты. Реальный выигрыш велик на объёмных однотипных задачах и близок к нулю на мелких требующих точности.

Какая модель лучше для вайбкодинга?

Разница между моделями на кодовых задачах больше, чем на текстовых, поэтому экономить здесь рискованно. Рабочая схема — смешивать: дешёвая модель на механические правки, сильная на задачи, где надо рассуждать. Разброс в цене между ними всего около $80 в месяц.

Нужно ли уметь программировать, чтобы вайбкодить?

Для прототипа — нет, для рабочего проекта — да. Модель снимает набор текста, но не ответственность: искать причину падения в проде и решать, верна ли предложенная архитектура, придётся вам. Тесты в такой работе становятся не роскошью, а условием.

Показать полностью 1
0

Как платить за нейросети меньше: 10 способов с расчётами⁠⁠

Как платить за нейросети меньше: 10 способов с расчётами

Если начать активно пользоваться нейросетями через API, счёт иногда растёт намного быстрее, чем ожидаешь.

Причём проблема не всегда в количестве запросов. Часто деньги съедает длинная история переписки, огромная инструкция, слишком мощная модель или ответы на несколько экранов там, где хватило бы пары строк.

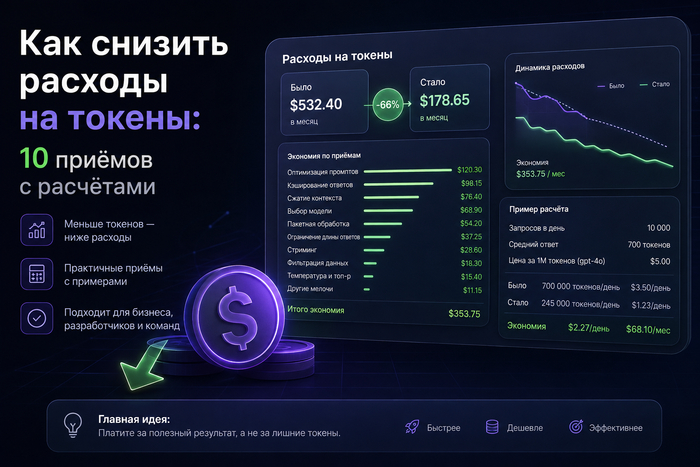
Я собрал 10 способов снизить расходы на нейросети. Где возможно — добавил конкретные расчёты.

Коротко

Больше всего обычно помогают три вещи:

  1. Не использовать дорогую модель там, где справится дешёвая.

  2. Не отправлять в каждый запрос лишний контекст.

  3. Не заставлять модель генерировать больше текста, чем действительно нужно.

На больших объёмах даже небольшая экономия на одном запросе превращается в сотни долларов.


1. Не используйте самую дорогую модель для всего

Это, пожалуй, самый простой способ сэкономить.

Представим, что нужно автоматически обработать 100 000 обращений в поддержку.

На каждое обращение приходится примерно 500 входных токенов и 50 выходных.

Для простой задачи вроде «определи категорию обращения» не обязательно использовать самую мощную модель.

Например:

МодельСтоимость обработки100 000 обращенийClaude Haiku 4.5$0,00059$58,60Claude Opus 4.8$0,00338$337,50

Разница — почти $280 на одной такой задаче.

При этом качество классификации может практически не измениться.

Хорошее правило:

простая формальная задача → недорогая модель; сложное рассуждение → более мощная.

К первой категории относятся классификация, извлечение информации, сортировка, простая обработка текста и короткий перевод.


2. Сократите системный промпт

Системная инструкция может казаться незначительной: написали её один раз и забыли.

Но если она отправляется вместе с каждым запросом, стоимость быстро становится заметной.

Допустим, инструкция занимает 1 000 токенов, а запросов — 100 000.

Получаем:

1 000 × 100 000 = 100 млн входных токенов.

При цене $2,12 за миллион токенов это уже $212 только за одну и ту же инструкцию.

Если сократить её до 500 токенов, расходы будут примерно вдвое меньше.

Но есть важный момент: не стоит превращать системный промпт в набор непонятных сокращений. Если из-за слишком короткой инструкции модель начнёт ошибаться, последующие повторные запросы съедят всю экономию.


3. Не таскайте за собой всю историю чата

В длинном диалоге стоимость может постепенно увеличиваться.

Представьте разговор из 20 сообщений. Пользователь задаёт новый вопрос, а вместе с ним модель получает предыдущую переписку.

В итоге вы платите не только за новый вопрос, но и за большой кусок старого контекста.

Есть несколько решений.

Скользящее окно. Оставлять последние несколько сообщений, а старые удалять.

Сжатие истории. Периодически превращать длинную переписку в короткое резюме.

Например:

Пользователь создаёт интернет-магазин одежды. Использует Next.js. Нужно подключить оплату и каталог.

Вместо 30 старых сообщений можно передавать это резюме.

Сбрасывать контекст между задачами.

Если человек закончил обсуждать сайт и начал спрашивать рецепт борща, предыдущие 50 сообщений вряд ли нужны модели.


4. Ограничивайте длину ответа

Выходные токены обычно стоят значительно дороже входных.

Поэтому иногда модель буквально «съедает» бюджет лишними словами.

Если вам нужно:

Определи категорию обращения: доставка, возврат или другое.

нет смысла просить:

Подробно проанализируй обращение, объясни своё решение, приведи аргументы и сформулируй итоговый вывод.

Можно попросить вернуть:

{"category":"delivery"}

Вместо нескольких сотен токенов получится несколько десятков.

Если API позволяет задавать максимальную длину ответа, ограничивайте её под конкретную задачу.

Для классификации может хватить нескольких десятков токенов. Для генерации статьи понадобится значительно больше.


5. Не включайте рассуждение там, где оно не нужно

Современные модели умеют тратить дополнительные вычисления на сложные задачи.

Для математики, программирования или анализа большого количества информации это действительно может быть полезно.

Но если задача выглядит так:

Определи, является ли сообщение положительным или отрицательным.

дополнительное рассуждение может оказаться просто лишним расходом.

Поэтому для простых операций вроде:

  • классификации;

  • извлечения данных;

  • форматирования;

  • определения языка;

  • сортировки;

имеет смысл использовать минимальный доступный уровень рассуждения, если выбранная модель это позволяет.


6. Объединяйте похожие запросы

Допустим, вам нужно определить категорию сразу для 10 сообщений.

Можно сделать 10 отдельных запросов:

сообщение → модель → результат

А можно отправить их одним запросом:

10 сообщений → модель → 10 результатов

Главное преимущество второго варианта — общая инструкция передаётся один раз.

Например:

Для каждого сообщения определи категорию: доставка, возврат, оплата или другое. Верни результат в JSON.

А дальше идут 10 сообщений.

На большом количестве данных экономия становится заметной.

Но превращать 10 элементов в 10 000 тоже не стоит. Чем больше становится запрос, тем сложнее модели аккуратно обработать каждый элемент.

На практике имеет смысл экспериментировать с небольшими пачками — например, 5–20 элементов.


7. Просите конкретный формат ответа

Если результат потом будет обрабатываться программой, не просите модель писать сочинение.

Например, вместо:

Расскажи подробно, к какой категории относится обращение и почему ты так решил.

можно написать:

Верни JSON с полями category и confidence.

Получится что-то вроде:

{ "category": "delivery", "confidence": 0.94 }

Меньше текста — меньше расходов.

Заодно такой ответ проще обработать программой.


8. Не отправляйте изображения в оригинальном размере

Изображения тоже могут превращаться в токены.

И здесь действует простое правило: отправляйте изображение в том качестве, которое действительно нужно для задачи.

Если нужно понять:

На фотографии автомобиль или мотоцикл?

огромное изображение с камеры телефона не требуется.

Если же задача:

Прочитай мелкий текст на документе.

тогда высокое разрешение уже может быть оправдано.

Поэтому перед отправкой изображения стоит спросить себя: нужна ли модели каждая деталь?

Иногда уменьшение фотографии в несколько раз практически не меняет результат, но снижает количество обрабатываемых данных.


9. Отменяйте запросы, которые больше не нужны

Представим обычный чат.

Пользователь отправил запрос и через пару секунд закрыл страницу.

Если приложение не отменило генерацию, модель может продолжить писать ответ до самого конца.

Пользователь его уже не увидит, но сгенерированные токены всё равно могут попасть в счёт.

Поэтому в приложениях со стримингом полезно отменять незавершённые запросы, когда пользователь:

  • закрыл страницу;

  • отправил новый запрос;

  • нажал «остановить»;

  • перешёл к другой задаче.

На одном пользователе экономия может быть небольшой. На тысячах пользователей — уже заметной.


10. Посмотрите, куда на самом деле уходят деньги

Это самый скучный совет, но часто самый полезный.

Не пытайтесь оптимизировать всё подряд.

Сначала найдите самые дорогие запросы.

В идеале в статистике должны быть видны:

  • модель;

  • количество входных токенов;

  • количество выходных;

  • стоимость;

  • время запроса;

  • количество повторов.

После этого отсортируйте запросы по стоимости.

Очень часто оказывается, что большая часть расходов приходится всего на несколько сценариев.

Например:

80% расходов → один AI-агент, который каждый раз получает огромный контекст.

И тогда бессмысленно экономить по 2% на остальных запросах.

Гораздо эффективнее разобраться именно с этим агентом.


А что насчёт кэширования?

Это отдельный способ, о котором часто забывают.

Некоторые API позволяют кэшировать повторяющуюся часть контекста.

Например, у вас есть большая инструкция на 10 000 токенов, которая практически никогда не меняется, а пользователи задают к ней разные вопросы.

Без кэширования эти 10 000 токенов приходится учитывать снова и снова.

При наличии prompt caching повторяющаяся часть может тарифицироваться дешевле.

Поэтому если приложение постоянно отправляет один и тот же большой контекст, обязательно проверьте, поддерживает ли выбранная модель кэширование.


Что ещё стоит сделать

Есть вещи, которые не уменьшают стоимость одного запроса, но защищают от неприятных сюрпризов.

Поставьте лимиты расходов

Если скрипт случайно зациклится, несколько часов работы могут превратиться в большой счёт.

Лимиты на день или месяц помогают ограничить ущерб.

Разделяйте API-ключи

Если у вас несколько проектов или сценариев, лучше использовать отдельные ключи.

Тогда проще понять, какой именно проект расходует деньги.

Следите за повторными запросами

Иногда проблема вообще не в модели.

Например, приложение отправляет один и тот же запрос три раза из-за ошибки на сервере.

Для пользователя всё выглядит нормально, а расходы становятся в три раза выше.


Сколько вообще можно сэкономить?

Допустим, сейчас приложение тратит $1 000 в месяц.

Если:

  • заменить дорогую модель на более дешёвую для простых задач — экономия 20%;

  • сократить контекст — ещё 15%;

  • уменьшить ответы — ещё 10%;

  • убрать лишние повторы — ещё 5%;

это уже может дать порядка $400–500 экономии в месяц.

При этом не пришлось уменьшать количество пользователей или запросов.

Главное — не пытаться экономить на всём подряд. Сначала найдите самые дорогие места, а уже потом оптимизируйте их.


Итог

Если совсем коротко, то порядок действий такой:

1. Посмотрите статистику расходов.

2. Найдите самые дорогие сценарии.

3. Проверьте, нужна ли им действительно используемая модель.

4. Уберите лишний контекст.

5. Ограничьте длину ответов.

6. Объедините однотипные запросы.

7. Проверьте повторы и незавершённые запросы.

8. Если контекст постоянно повторяется — изучите prompt caching.

И только после этого имеет смысл заниматься мелкими оптимизациями.

Самая большая ошибка — считать только количество запросов. Два приложения могут отправлять одинаковое число запросов и отличаться по стоимости в десятки раз просто из-за размера контекста и выбранных моделей.

Если вы используете несколько моделей одновременно, полезно хотя бы раз в месяц смотреть статистику расходов. Обычно после такого анализа находятся самые неожиданные места, где утекают деньги.

P.S. Для сравнения цен разных моделей и контроля расходов на API я использую altrouter.ai

Показать полностью 1

Агрегаторы нейросетей в России: как выбирать в 2026 году⁠⁠

Агрегаторы нейросетей в России: как выбирать в 2026 году

Коротко

За 2026 год российских шлюзов к зарубежным моделям стало больше десятка, и выбирать между ними по числу моделей или по цене на витрине бесполезно. И то и другое меняется каждый месяц и у всех примерно одинаково.

Различаются они в другом — в вещах, которые вылезают не на первом запросе, а на первой тысяче: что происходит при падении провайдера, как именно считаются деньги, есть ли лимит на ключ, видно ли, за что списано.

Ниже — восемь критериев, по которым имеет смысл сравнивать, и честный раздел о том, когда агрегатор не нужен.

Кого вы встретите в выдаче

Если вы гуглите «аналог OpenRouter в России», в первой десятке будут: BotHub, ProxyAPI, AITunnel, VseGPT, Gen-API, RouterAI, SprutDock, Intelion, VEGA, Serverspace, provod, Ofox, KodikRouter, Polza, Cloud Foundation Models — и мы. Список за последние месяцы вырос почти вдвое.

Сознательно не приводим здесь таблицу с их ценами и списками моделей. Причина простая: эти данные протухают за недели, а статья, в которой конкурент описан по состоянию на прошлый квартал, вводит в заблуждение сильнее, чем её отсутствие. Проверять надо на их сайтах, в день, когда выбираете.

Что имеет смысл — разобраться, какие вопросы задавать. Они не меняются.

Восемь критериев

1. Совместимость API — и с чем именно

Почти все шлюзы пишут «OpenAI-совместимый». Это правда, но недостаточно. Уточнять надо три вещи:

  • Работает ли стриминг и корректно ли он закрывается. Отсутствие стриминга не видно на тесте в консоли и очень видно в интерфейсе.

  • Поддерживаются ли инструменты (function calling) и структурированный вывод. Если у вас агент — это не опция.

  • Есть ли Anthropic-совместимый /v1/messages. От этого зависит, подключится ли Claude Code и часть агентских инструментов.

По последнему пункту скажем прямо: у нас входящего /v1/messages сейчас нет, только OpenAI-совместимый интерфейс. Некоторые конкуренты его уже сделали, и если ваш сценарий — именно Claude Code, это аргумент не в нашу пользу.

2. Что происходит, когда провайдер падает

Самый недооценённый критерий. Модель у вендора может быть перегружена — Anthropic в пиковые часы отдаёт 529, и это нормальная ситуация, а не авария.

Вопрос в том, что делает шлюз: возвращает ошибку вам или уходит на резервного провайдера. Разница в том, увидит ли ваш пользователь сломанный экран.

Спрашивать надо конкретно: есть ли failover, по каким кодам он срабатывает (429, 5xx, таймаут), и не меняется ли при этом цена — потому что резервный провайдер может стоить дороже основного.

3. Как считаются деньги

Здесь три подвопроса, и все три важны.

Единица. Токены или «кредиты»? Кредит — это абстракция, которую можно переоценить в любой момент, и посчитать заранее, во что обойдётся месяц, по ней нельзя.

Момент списания. Списывается при отправке запроса или по факту ответа? И что происходит, если соединение оборвалось на середине стрима — платите ли вы за сгенерированное?

Резервирование. Для долгих задач вроде видео правильная механика — резерв в момент создания задачи и списание по факту удавшегося рендера. Иначе либо вы платите за упавшие рендеры, либо сервис работает себе в убыток, а это ненадолго.

4. Прозрачность цены

Проверяется одним действием: сделайте один запрос и найдите его в логах. Должно быть видно — модель, входные и выходные токены, сумма.

Если такой строки нет, вы не сможете ни спрогнозировать бюджет, ни разобраться, почему счёт вырос. У нас это /dashboard/logs с колонкой по каждому вызову; у большинства сервисов что-то похожее есть — важно посмотреть до оплаты, а не после.

5. Лимиты на ключ

Ключ утекает — в репозиторий, в лог, в скриншот. Вопрос не «если», а «когда».

Работающая защита — лимит расхода на конкретный ключ: в день, в неделю, в месяц, всего. Тогда утечка стоит вам ограниченной суммы, а не всего баланса. Плюс отдельная область действия ключа: ключ для картинок не должен уметь тратить деньги на видео.

6. Оплата

Здесь и находится главная причина, по которой вы вообще читаете эту статью. Смотреть надо на:

  • способы — карта РФ, СБП, криптовалюта, счёт для юрлица;

  • закрывающие документы, если платит компания;

  • минимальную сумму пополнения — у некоторых она заметная;

  • комиссию: берёт ли сервис процент сверху за пополнение.

7. Что кроме текста

Год назад шлюзы были только про чат. Сейчас у задач появились картинки и видео, и покрытие у всех разное.

Видео — отдельная история: оно асинхронное, рендерится минутами и требует от сервиса очереди, воркеров и той самой механики резервирования. Поэтому у многих его до сих пор нет. У нас 44 модели: 24 текстовых, 13 для изображений и 7 для видео, у 9 провайдеров — цифры на день публикации, актуальные всегда на витрине.

8. Кто это и надолго ли

Неприятный, но необходимый пункт. Шлюз держит ваши деньги на балансе и стоит между вами и вендором. Стоит понимать, есть ли за сервисом юрлицо, отвечает ли поддержка и что будет с остатком, если проект закроется.

Совет практический: не держите на балансе больше, чем готовы потерять. Это относится ко всем сервисам, включая нас.

Чего делать не стоит

Три ошибки, которые повторяются регулярно.

Выбирать по числу моделей. Каталог из 200 моделей и каталог из 44 отличаются в основном длиной хвоста из моделей, которыми никто не пользуется. Смотрите, есть ли те 3–5, которые нужны вам.

Покупать чужой аккаунт. Периодически всплывает как «дешёвый доступ». Это чужой ключ, чужая карта и чужая ответственность, отзывают его вместе с вашим балансом.

Верить бейджу «−50%» без базы сравнения. Скидка имеет смысл только относительно официальной цены вендора, и её нужно уметь проверить. Если базы не видно — это не скидка, а рисунок.

Когда агрегатор не нужен

Честно: в этих случаях вы переплачиваете за лишнее звено.

  • Вы работаете с одним вендором, и у вас есть способ ему платить. Прямой доступ будет дешевле — посредник не может продавать ниже себестоимости бесконечно.

  • У вас корпоративный контракт с облаком, где эти модели уже есть.

  • Вам нужен не API, а интерфейс. Ключ без кода бесполезен — подробнее об этом в разборе подписки против ключа.

  • Данные нельзя выпускать наружу. Тогда вам нужна локальная модель, а не шлюз, и это совсем другой разговор.

Агрегатор оправдан, когда моделей несколько, вендоров несколько, платить каждому по отдельности неудобно, а переключаться между ними хочется одной строкой. Зачем это устроено именно так — разбирали здесь.

Как проверить любой сервис за 15 минут

Порядок, который работает одинаково для нас и для конкурентов:

  1. Заведите ключ и сделайте один запрос — на минимальном балансе или на приветственных средствах.

  2. Найдите этот запрос в логах. Видны токены и сумма? Хорошо. Не видны — плохо.

  3. Проверьте стриминг и, если нужно, инструменты. Именно они ломаются чаще всего.

  4. Попробуйте оплату на минимальную сумму, а не на месячный бюджет.

  5. Спросите поддержку что-нибудь конкретное и посмотрите, за сколько ответят.

  6. Поставьте лимит на ключ и убедитесь, что он срабатывает.

Пятнадцать минут здесь экономят месяцы. У нас на этот тест начисляется $1 за подтверждённый Telegram — на все шесть шагов хватает.

FAQ

Какой агрегатор нейросетей выбрать в России?

Тот, у которого совпадают четыре вещи: нужные вам модели, устраивающий способ оплаты, прозрачные логи со списаниями и внятное поведение при падении провайдера. Сравнивать по общему числу моделей или по цене на витрине бесполезно — эти параметры почти одинаковы и меняются ежемесячно.

Чем агрегаторы отличаются друг от друга?

Не каталогом, а инженерными деталями: есть ли failover на резервного провайдера, в чём считаются деньги (токены или кредиты), в какой момент происходит списание, можно ли поставить лимит расхода на отдельный ключ, поддерживаются ли изображения и видео, и есть ли Anthropic-совместимый эндпоинт для агентских инструментов.

Сколько российских агрегаторов нейросетей существует?

В выдаче по запросам об аналогах OpenRouter стабильно встречается больше пятнадцати сервисов, и за последний год их число выросло почти вдвое. Конкретные характеристики быстро устаревают, поэтому список моделей и цены имеет смысл проверять на сайте сервиса в день выбора.

Дешевле ли агрегатор, чем прямой доступ к вендору?

Не по определению. Посредник не может систематически продавать ниже своей себестоимости, поэтому если вы работаете с одним вендором и можете ему заплатить, прямой доступ обычно выгоднее. Агрегатор выигрывает, когда моделей и вендоров несколько, а платить каждому отдельно неудобно.

Безопасно ли держать деньги на балансе агрегатора?

Это тот же риск, что и с любой предоплатой сервису. Разумная практика — не держать на балансе больше месячного расхода, ставить лимиты на ключи и проверять, есть ли за сервисом юрлицо и отвечающая поддержка. Правило относится ко всем сервисам без исключения.

Можно ли подключить Claude Code к российскому шлюзу?

Зависит от шлюза: Claude Code обращается к Anthropic-совместимому /v1/messages, и он есть не у всех. У нас его сейчас нет — доступен OpenAI-совместимый интерфейс, с которым работают библиотека openai, редакторы с настраиваемым адресом API и оболочки вроде Open WebUI и LibreChat.

Показать полностью 1
Отличная работа, все прочитано!

Темы

Политика

Теги

Популярные авторы

Сообщества

18+

Теги

Популярные авторы

Сообщества

Игры

Теги

Популярные авторы

Сообщества

Юмор

Теги

Популярные авторы

Сообщества

Отношения

Теги

Популярные авторы

Сообщества

Здоровье

Теги

Популярные авторы

Сообщества

Путешествия

Теги

Популярные авторы

Сообщества

Спорт

Теги

Популярные авторы

Сообщества

Хобби

Теги

Популярные авторы

Сообщества

Сервис

Теги

Популярные авторы

Сообщества

Природа

Теги

Популярные авторы

Сообщества

Бизнес

Теги

Популярные авторы

Сообщества

Транспорт

Теги

Популярные авторы

Сообщества

Общение

Теги

Популярные авторы

Сообщества

Юриспруденция

Теги

Популярные авторы

Сообщества

Наука

Теги

Популярные авторы

Сообщества

IT

Теги

Популярные авторы

Сообщества

Животные

Теги

Популярные авторы

Сообщества

Кино и сериалы

Теги

Популярные авторы

Сообщества

Экономика

Теги

Популярные авторы

Сообщества

Кулинария

Теги

Популярные авторы

Сообщества

История

Теги

Популярные авторы

Сообщества

Недвижимость и ремонт

Теги

Популярные авторы

Сообщества