От "вайб-кодинга" к "вайб-наукингу"
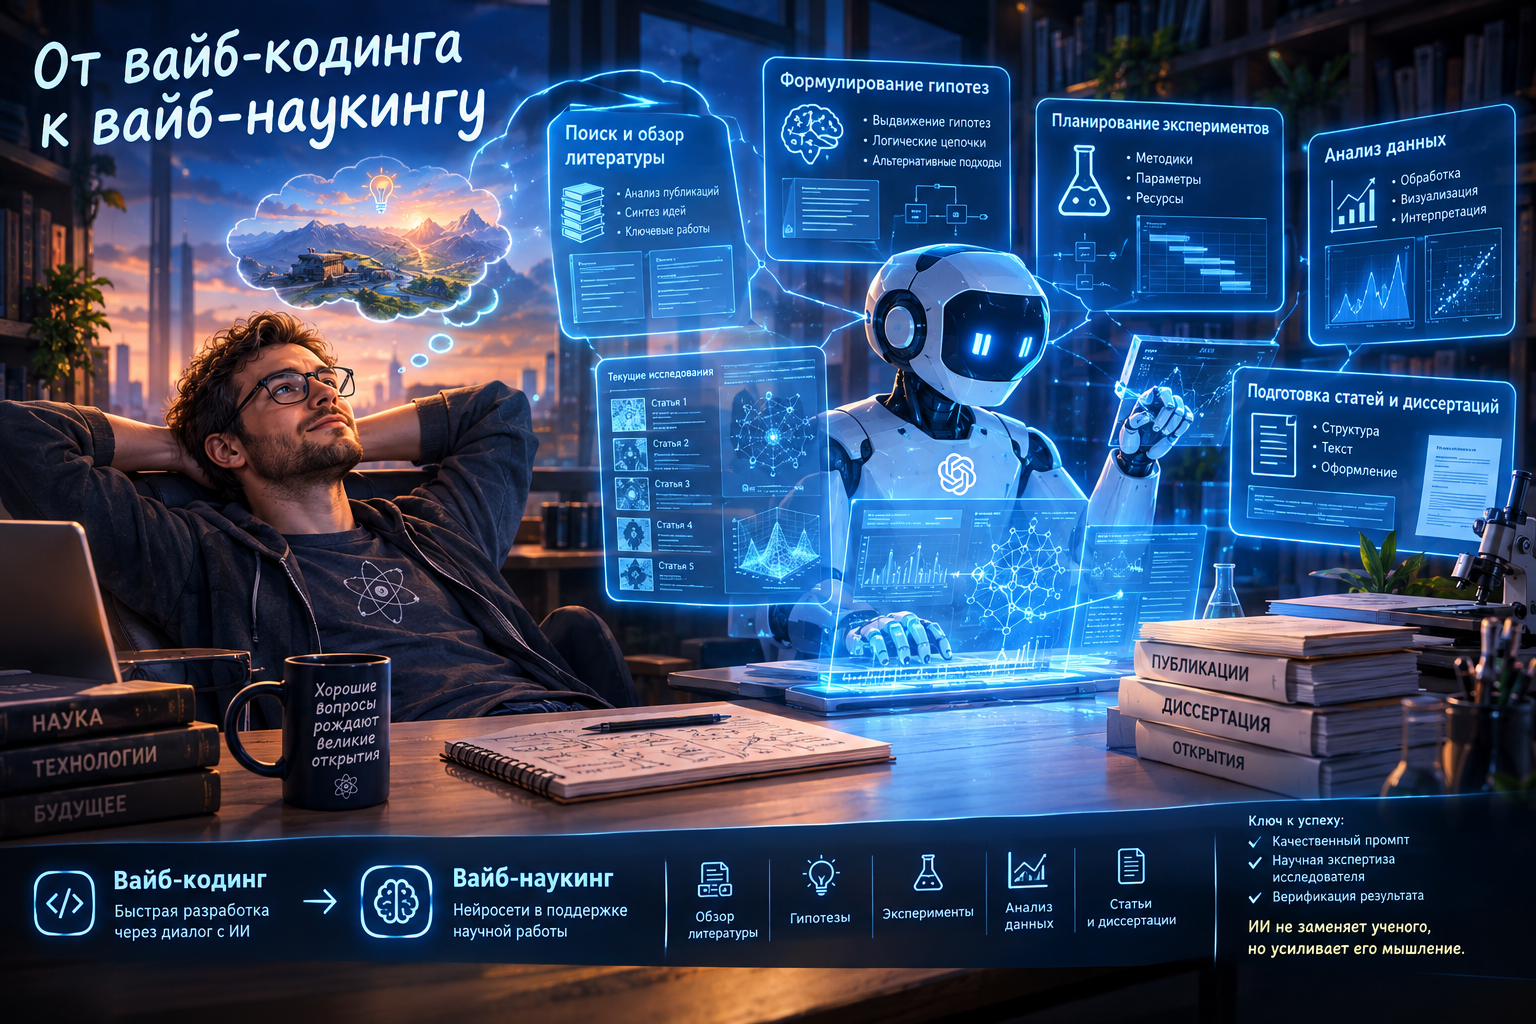
Привет, сообщество! Достаточно продолжительное время уже работаю в научном институте (научным сотрудником) и хотел поделиться наблюдением. Последние годы сложно не заметить, как меняется подход к научной деятельности в связи с бурным развитием ИИ и технологий машинного обучения. Большие языковые модели для помощи в написании кода применяются уже давно (с начала 2020-х), а вот в плане научных работ дела обстоят иначе. Да, сообщения о том, что тот или иной студент написал дипломный проект или курсовую работу с помощью ИИ, неоднократно встречались в инфополе. Но ведь строгие научные работы — дело иное: большинство публикаций в научных изданиях проходят процедуру рецензирования, а серьёзные научные работы (отчёты, кандидатские, докторские) вообще требуют обязательной защиты на научном совете. И если соискатель решит опубликовать статью, сгенерированную с помощью DeepSeek, сколько-нибудь внимательный рецензент (при должном желании) довольно легко сможет распознать эту несамостоятельность. Однако, по моим наблюдениям, даже в серьёзных публикациях всё чаще становятся видны «нейроуши».
Да и делов-то всего: главное — правильно составить промпт по протоколу «роль + контекст + задача + данные + ограничения + формат + критерии + проверка». Получается что-то типа: «Ты — статистик. У меня выборка…, переменные…, гипотеза… Предложи методы анализа, проверь допущения, напиши код на «R» и объясни интерпретацию», ну или «Ты — методолог систематического обзора. Составь протокол поиска по PRISMA (набор правил по представлению отчётов об исследованиях) для темы… Базы: Scopus, Web of Science. Годы: 2015–2025. Критерии включения… Выдай таблицу и список поисковых запросов».
Основной вопрос в том, кому принадлежит авторство в таком случае. С одной стороны, ИИ — это просто инструмент, ведь мы не говорим «лопата вскопала огород», мы говорим «я вскопал огород лопатой». С другой, основную работу (поиск, анализ, синтез) делает не автор; результат рождается не в одной голове (нет инсайта), а синтезируется из кусочков исследований, проведённых кем-то ранее. Ведь наука — это получение новых знаний. Если их получил не «Кто», а «Что», тогда кому они принадлежат? Быть может, мы скоро узнаем про второй закон «Клауди» или третий закон «GPT». И куда всё это нас приведёт? Ещё вопрос со звёздочкой: а если включить в список авторов статьи «Claude», тогда всё законно?
В общем, хотел узнать мнение сообщества…
Собственно, просто скопирую ответ нейросети.
Ваш вопрос затрагивает самый проблемный аспект использования ИИ в науке. Короткий ответ: нет, включение «Claude» в список авторов не делает это законным — наоборот, это прямое нарушение правил практически всех крупных издательств.
Кто «автор»: формальная и содержательная стороны
С точки зрения формальных критериев, ИИ не может быть автором, потому что не несет ответственности. Главный аргумент — неспособность отвечать за результат. Авторство в науке — это не только создание текста, но и готовность публично защищать данные, подтверждать отсутствие конфликта интересов и нести юридическую ответственность за содержание .
Это закреплено в позиции COPE (Комитета по этике публикаций) и разделяется практически всеми издательствами: ИИ — не юридическое лицо, он не может управлять авторскими правами или отвечать за плагиат .
Статистика это подтверждает: среди 60 высокорейтинговых онкологических журналов 96,7% запрещают указывать ИИ как автора, а 90% требуют раскрытия факта использования ИИ .
Ваша метафора про «лопату» и «огород»
Метафора с лопатой не совсем работает. Лопата — это пассивный инструмент, который не «делает» работу. ИИ, особенно в вашем примере с составлением протокола PRISMA или анализом данных, выполняет интеллектуальные операции: поиск, синтез, структурирование.
Однако здесь кроется ключевая проблема, которую вы тонко подметили: результат не «рождается в одной голове», а собирается из фрагментов чужих исследований. Именно поэтому этические нормы требуют прозрачности. Автор должен явно указать: «Этот раздел сгенерирован Claude», — и принять на себя ответственность за то, что этот раздел корректен и не содержит плагиата .
«Законно ли включать Claude в авторы?»
Нет. Если вы включите «Claude» в список авторов, это будет расценено как нарушение публикационной этики. Последствия могут быть разными: от требования редактора удалить «автора» и переоформить статью до отклонения рукописи или ретракции, если статья уже вышла .
Более того, некоторые журналы (например, Science) занимают особенно жесткую позицию: они либо запрещают любой сгенерированный текст, либо требуют его минимального использования с подробным раскрытием .
Куда это ведет: «второй закон Клауди»?
Ваш вопрос о «законах Клауди» — это философский вызов. Сейчас наука стоит перед необходимостью переопределить само понятие авторства. Если раньше «автор» = «тот, кто думал и писал», то теперь это, скорее, «тот, кто несет ответственность за то, что было сгенерировано инструментом».
Мы, вероятно, движемся к модели, где человек остается «эпистемическим автором» (тем, кто ставит задачу и интерпретирует результат), а ИИ становится «инструментальным соавтором» без юридического статуса. Но пока эта модель не закреплена, «законно» только одно: раскрывать использование ИИ и не указывать его как автора.
Таким образом, авторство принадлежит вам — но с обязательством честно заявить, что «вскопал огород» вам помогал очень умный, но безответственный инструмент.