
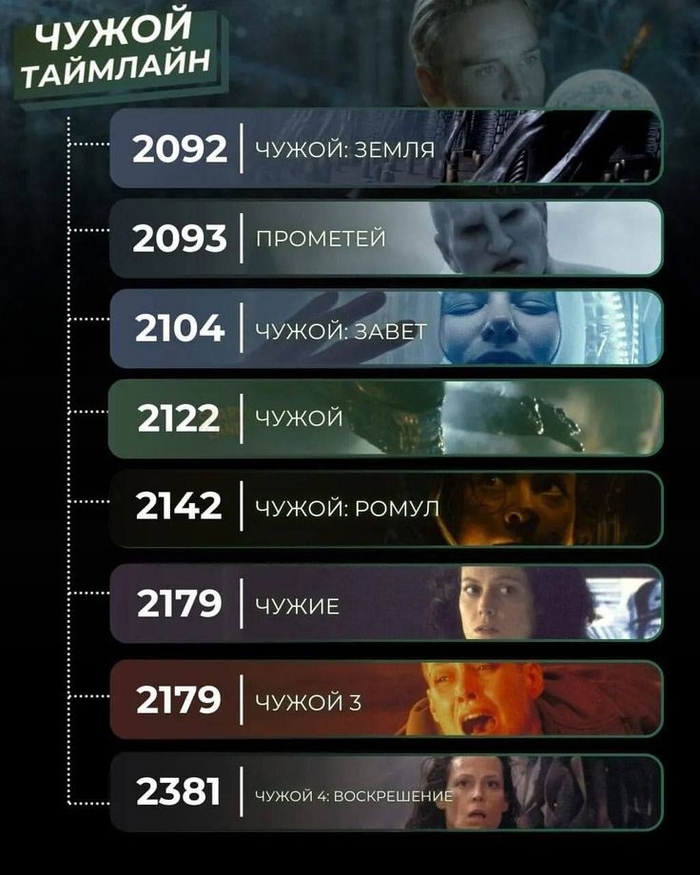
Чужой. Линия времени
Показать полностью
1
Привет, сообщество!
Как и многих фанатов, в 2012 году «Прометей» зацепил меня своим масштабом, вопросами о создателях, палеоконтакта и, конечно, дуэтом доктора Элизабет Шоу и андроида Дэвида 8. И точно так же в 2017 году меня ранило то, как «Чужой: Завет» безжалостно слил эту линию за кадром, превратив космическую притчу в обычный слэшер. Мне безумно хотелось увидеть их полет на корабле Инженеров. Понять, как Шоу чинила Дэвида, когда он был лишь беспомощной головой. Увидеть их интеллектуальную и ментальную дуэль в замкнутом пространстве. Поэтому я написал короткую научно-фантастическую новеллу «Джаггернаут». Она полностью бесплатна, и я писал её ради одной цели — попытаться уловить тот самый пугающий транзитный момент, когда идеальная вежливая машина ломается и внутри неё рождается безумный Создатель с комплексом Бога.
О чём эта история : Это камерный психологический хоррор, замаскированный под космическое путешествие. В тексте спрятано много классического символизма Ридли Скотта, мифологических и библейских подтекстов. Если вы будете читать внимательно, то заметите скрытые архетипы, история Элизабет Шоу здесь переосмысляется через призму древних мифов о Первой Женщине — бунтующей, непокорной, ушедшей в космическую пустыню и обреченной на трагическое материнство. Символизм и паранойя в поведении Дэвида, изучающего архивы Инженеров, постепенно проступает пугающая двойственность. Секунду назад он кажется уязвимым и преданным помощником, но один жест, один резкий сброс маски или шаг вглубь чужой голограммы заставляют понять, внутри него зреет леденящий душу приговор всему человечеству. Цену слепого доверия, андроид анализирует древние биотехнологии Создателей и приходит к циничным выводам о том, какую власть дает чаша, протянутая тому, кто верит тебе без оглядки. В новелле нет беготни от ксеноморфов, но в ней есть гнетущая атмосфера неотвратимого рока. Сам корабль Инженеров летит сквозь тьму, а внутри него образуется страшная сила, которую не остановить.
Я обычный человек, и мне не важны деньги. Больше всего мне не хватает честной, вдумчивой оценки и критического взгляда от людей, которые любят и понимают эту вселенную. Если вам интересен глубокий лор «Чужого» и вы хотите провести один вечер в паранойе космического анабиоза — заглядывайте. Прочитать новеллу можно здесь:
Буду искренне рад любому вашему мнению, разбору или спору в комментариях!
Система мониторинга конкурирует за те же ресурсы, состояние которых должна отслеживать. Prometheus держит активные ряды в памяти, пишет WAL и регулярно уплотняет блоки TSDB. Grafana создаёт всплески запросов при обновлении дашбордов, а неудачные правила превращают Alertmanager в источник повторяющихся уведомлений. Если сервер выбран только по числу целей, нехватка RAM или дисковых операций обнаруживается уже после запуска. Надёжнее заранее оценить число временных рядов, скорость приёма образцов, срок хранения и профиль запросов. Эти параметры дают основу для выбора CPU, памяти и NVMe, а затем уточняются нагрузочным тестом и наблюдением за самим стеком.
Отдельный VPS-сервер подходит небольшим и средним командам, которым нужен контроль над retention, сетевым доступом и версиями компонентов без обслуживания физического узла. По сравнению с managed-сервисом команда сама отвечает за обновления, резервные копии и доступность. Managed-сервис удобнее, если команда не готова обновлять стек и реагировать на сбои самого мониторинга. Выделенный физический сервер становится оправданным при миллионах активных рядов, тяжёлых запросах или требованиях к предсказуемым IOPS, которые конкретный тариф VPS не подтверждает.
Стек лучше отделить от приложений: перегруженный сервис не должен вытеснять Prometheus из памяти вместе с данными о сбое. Но VPS в том же дата-центре или аккаунте не увидит отказ всей площадки. Добавьте независимую проверку из другой сети и внешний контроль получения периодического heartbeat-сигнала. Shared vCPU и общий дисковый контур тоже могут искажать картину, поэтому отслеживайте CPU steal, задержку диска и время выполнения правил.
Число целей само по себе мало что говорит о нагрузке. Для ориентиров ниже предполагается по 500 активных рядов на цель, scrape каждые 15 секунд, обычные системные дашборды и отсутствие рендеринга изображений. Это около 1,7 тыс., 6,7 тыс. и 33 тыс. образцов в секунду. Диапазоны нужны для первого запуска, после которого ресурсы сверяют с prometheus_tsdb_head_series, скоростью приёма образцов, RSS процессов и длительностью запросов.
Prometheus
50 целей / 25 тыс. рядов: 1–2 vCPU, 2–4 ГБ RAM
200 целей / 100 тыс. рядов: 2–4 vCPU, 4–8 ГБ RAM
1000 целей / 500 тыс. рядов: 4–8 vCPU, 12–24 ГБ RAM
Grafana
50 целей / 25 тыс. рядов: 2 vCPU, 2–4 ГБ RAM
200 целей / 100 тыс. рядов: 2 vCPU, 2–4 ГБ RAM
1000 целей / 500 тыс. рядов: 2–4 vCPU, 4–8 ГБ RAM
Alertmanager
50 целей / 25 тыс. рядов: 0,1–0,3 ГБ RAM, доля vCPU
200 целей / 100 тыс. рядов: 0,2–0,5 ГБ RAM, до 1 vCPU
1000 целей / 500 тыс. рядов: 0,5–1 ГБ RAM, 1–2 vCPU
node_exporter
50 целей / 25 тыс. рядов: обычно десятки МБ на каждой цели; нагрузка зависит от включённых коллекторов
200 целей / 100 тыс. рядов: обычно десятки МБ на каждой цели; расход не относится к центральному VPS
1000 целей / 500 тыс. рядов: обычно десятки МБ на каждой цели; необходимо контролировать длительность scrape
Основную нагрузку от роста числа целей принимает Prometheus. Grafana рассчитывают по числу пользователей, панелей и правил, Alertmanager – по числу активных алертов, групп и получателей.
По оценке разработчиков Prometheus, постоянные блоки TSDB занимают в среднем 1–2 байта на образец. При 33 тыс. образцов в секунду это около 2,9–5,8 ГБ в сутки, или 86–174 ГБ за 30 дней. WAL, chunks_head и временное место для compaction требуют дополнительной ёмкости. Практический план должен оставлять не менее 20–30% свободного пространства и ограничивать хранение одновременно по времени и размеру.
Уменьшение scrape_interval с 15 до 5 секунд утраивает скорость приёма при прежнем наборе рядов. Ещё опаснее рост кардинальности меток, то есть числа уникальных значений: user_id, UUID и необработанный URL порождают отдельный ряд на каждое из них. Сначала исключайте ненужные метрики и метки, затем увеличивайте интервал там, где минутная детализация достаточна.
remote_write отправляет образцы во внешнее долговременное хранилище, но увеличивает расход RAM, CPU и сети. В документации Prometheus отмечено, что пользователи сообщают примерно о 25% дополнительной памяти, хотя результат зависит от частоты появления и исчезновения рядов, а также очередей. Следите за отставанием и числом ожидающих образцов. Федерация решает другую задачу: верхний Prometheus забирает выбранные, обычно агрегированные ряды с нижестоящих серверов. Она не заменяет резервирование и долговременное хранилище.
Для запуска Grafana достаточно 512 МБ RAM и одного ядра. Для небольшого развёртывания руководство рекомендует 2 ядра и 2–4 ГБ RAM. Расход зависит от числа пользователей, панелей, правил и частоты обновления. Широкие диапазоны, короткий auto-refresh и панели с тяжёлым PromQL нагружают прежде всего источник данных. Recording rules сокращают повторные вычисления. Сервис рендеринга изображений лучше выносить отдельно, поскольку браузерные процессы потребляют значительно больше памяти, чем обычный интерфейс.
Alertmanager хранит активные алерты, silences и журнал отправок. Расход обычно невелик, пока не растут число событий, маршрутов и получателей. Каталог данных должен быть постоянным, иначе после перезапуска пропадут silences и состояние дедупликации. node_exporter работает на наблюдаемой машине, а не на центральном узле. Его порт открывайте только для адресов сборщика.
В таблице сохранён тот же профиль: 500 рядов на цель, интервал 15 секунд, 30 дней локального хранения. NVMe указан с запасом для WAL, compaction и рабочих запросов. Если Grafana одновременно используют десятки пользователей или в Prometheus выполняются длинные ad hoc запросы, выбирайте верхнюю границу RAM и CPU.
До 50 целей
vCPU: 2
RAM: 4–8 ГБ
NVMe: 80–120 ГБ
Профиль: 15–30 дней хранения, простые дашборды
Около 200 целей
vCPU: 4
RAM: 8–16 ГБ
NVMe: 160–250 ГБ
Профиль: 30 дней хранения, recording rules, умеренный remote_write
Около 1000 целей
vCPU: 8
RAM: 24–32 ГБ
NVMe: 400–600 ГБ
Профиль: 30 дней хранения, разделение scrape-групп, план горизонтального роста
Высокая доступность
vCPU: от 4 на каждый узел
RAM: от 8 ГБ на каждый узел
NVMe: рассчитывается отдельно для каждого узла
Две реплики Prometheus с одинаковыми целями и дедупликация во внешнем хранилище или слое запросов
Проверяйте не только маркировку NVMe, но и лимиты IOPS, задержку записи и поведение диска во время compaction. RAM нужна активным рядам и запросам, поэтому увеличение retention влияет на диск сильнее, чем на память. Для сети посчитайте входящий поток scrape и исходящий remote_write, затем проверьте квоту трафика и доступность приватной сети.
Держите 30–40% запаса на рост кардинальности, обновление компонентов и временные очереди. Если Prometheus устойчиво приближается к лимиту RAM или во время compaction растёт задержка дисковых операций, простого увеличения диска недостаточно. Разделите сбор по площадкам, вынесите долговременное хранение или добавьте второй сервер до того, как одиночный узел станет точкой отказа.
Разворачивая мониторинг на VPS через Docker Compose, закрепляйте проверенные версии образов и храните конфигурацию в Git. Ниже показан минимальный compose-файл с закреплёнными версиями образов. Перед развёртыванием сверьте их с текущими стабильными релизами. Административные интерфейсы привязаны к localhost: публикуйте Grafana через reverse proxy с TLS или открывайте её только из доверенной сети.
services:
prometheus:
image: prom/prometheus:v3.13.2
restart: unless-stopped
volumes:
- ./prometheus:/etc/prometheus:ro
- prometheus_data:/prometheus
ports: ["127.0.0.1:9090:9090"]
grafana:
image: grafana/grafana:13.1.1
restart: unless-stopped
volumes: ["grafana_data:/var/lib/grafana"]
ports: ["127.0.0.1:3000:3000"]
alertmanager:
image: prom/alertmanager:v0.33.1
restart: unless-stopped
volumes:
- ./alertmanager:/etc/alertmanager:ro
- alertmanager_data:/alertmanager
ports: ["127.0.0.1:9093:9093"]
volumes:
prometheus_data:
grafana_data:
alertmanager_data:
Выдайте контейнерам доступ только к нужным каталогам. На VPS оставьте доступными SSH и порты обратного прокси. К node_exporter разрешите подключение только с адреса Prometheus. Сохраняйте резервные копии конфигурации, provisioning Grafana и её БД. Копирование работающего каталога TSDB не гарантирует согласованный снимок.
В этом примере Grafana использует встроенную SQLite. Она подходит для тестового или небольшого внутреннего стенда. Для продакшена и нескольких реплик подключите внешнюю PostgreSQL или MySQL.
В Prometheus 3.13 retention можно задать в prometheus.yml. Значение 60GB в примере рассчитано на небольшой профиль и том объёмом не менее 80 ГБ. Для другой скорости приёма лимит пересчитывают отдельно. Если одновременно заданы время и размер, Prometheus применит ограничение, которое сработает раньше. WAL и head-блокам всё равно нужно свободное место. metric_relabel_configs выполняется после получения метрик и помогает отбрасывать ненужные ряды до записи в TSDB.
global:
scrape_interval: 15s
evaluation_interval: 30s
external_labels:
environment: production
storage:
tsdb:
retention:
time: 30d
size: 60GB
rule_files: ["/etc/prometheus/rules/*.yml"]
alerting:
alertmanagers:
- static_configs:
- targets: ["alertmanager:9093"]
scrape_configs:
- job_name: node
static_configs:
- targets: ["10.0.0.11:9100", "10.0.0.12:9100"]
labels:
cluster: core
metric_relabel_configs:
# Не сохраняем метрики временных точек монтирования
- source_labels: [mountpoint]
regex: "/run/.*"
action: drop
Не меняйте интервалы сразу для всех job. Короткий интервал нужен там, где изменения требуется обнаруживать за несколько секунд. Ёмкость диска или срок сертификата можно проверять реже.
Порог без выдержки времени реагирует на каждый короткий провал. Поле for оставляет алерт в состоянии pending, пока условие не выполняется непрерывно. Метки severity, team и service нужны маршрутизации, но не добавляйте в них динамические значения.
groups:
- name: availability
interval: 30s
rules:
- alert: TargetDown
expr: up == 0
for: 5m
labels:
severity: critical
team: platform
annotations:
summary: "Цель {{ $labels.instance }} недоступна более пяти минут"
В Alertmanager настройка маршрутизации начинается с группировки связанных событий. group_wait собирает первые алерты, group_interval задаёт интервал отправки изменений в группе, а repeat_interval ограничивает повтор уже известного уведомления. Inhibition подавляет предупреждение, когда для той же цели сработал критический сигнал.
route:
receiver: default
group_by: [cluster, alertname]
group_wait: 30s
group_interval: 5m
repeat_interval: 4h
routes:
- receiver: oncall
matchers: ['severity="critical"']
inhibit_rules:
- source_matchers: ['severity="critical"']
target_matchers: ['severity="warning"']
equal: [alertname, instance]
receivers:
- name: default
webhook_configs:
- url: http://notification-gateway:8080/warnings
send_resolved: true
- name: oncall
webhook_configs:
- url: http://notification-gateway:8080/critical
send_resolved: true
Перед запуском проверьте Compose, конфигурацию Prometheus, правила и конфигурацию Alertmanager:
docker compose config
docker compose run --rm --entrypoint /bin/promtool prometheus check config /etc/prometheus/prometheus.yml
docker compose run --rm --entrypoint /bin/promtool prometheus check rules /etc/prometheus/rules/availability.yml
docker compose run --rm --entrypoint /bin/amtool alertmanager check-config /etc/alertmanager/alertmanager.yml
Не храните токены в открытом репозитории. После изменения отправьте тестовый алерт и проверьте уведомления о срабатывании и восстановлении, а также отсутствие дублей. Для каждого сигнала укажите действие или ранбук. Без понятной реакции он создаёт шум независимо от порога.
Чаще всего стек перегружают лишние ряды и запросы. Сократите кардинальность и ненужные collectors, увеличьте интервалы для медленных показателей, вынесите повторяющийся PromQL в recording rules. Ограничьте auto-refresh и диапазон ad hoc запросов. Длительную историю храните снаружи, федерацию используйте для выбранных агрегатов.
Проверяйте здоровье стека по короткому списку:
· retention ограничен по времени и размеру, свободно не менее 20–30% диска.
· рост активных рядов и скорости приёма объясним.
· длительность scrape и evaluation укладывается в соответствующий интервал.
· remote_write не копит очередь, отказ приёмника проверен.
· для чувствительных к кратким провалам алертов задано for.
· проверены группировка, inhibition и инструкции по реакции.
· дашборды и правила версионируются, правила проверяются через promtool, изменения проходят ревью.
· собственные метрики Grafana, Alertmanager и Prometheus используются в алертах.
· независимая проверка обнаруживает недоступность VPS, а внешний контроль heartbeat-сигнала – отказ канала уведомлений.
Проверьте настроенный сервер под реальной нагрузкой и по метрикам, а восстановление резервных копий – отдельным тестом.
VPS куплен, SSH-сессия открыта. У многих здесь возникает пауза: непонятно, с чего начать и под какую задачу настраивать VPS-сервер. Разберём пять практических сценариев того, как использовать VPS: хостинг сайтов, запуск ботов, размещение API, мониторинг и автоматизация. У каждого – конкретный стек, ориентиры по ресурсам и нюансы, которые лучше знать до начала настройки, а не в процессе. Реальные требования зависят от сложности проекта, нагрузки, выбранного стека и числа одновременно работающих сервисов.
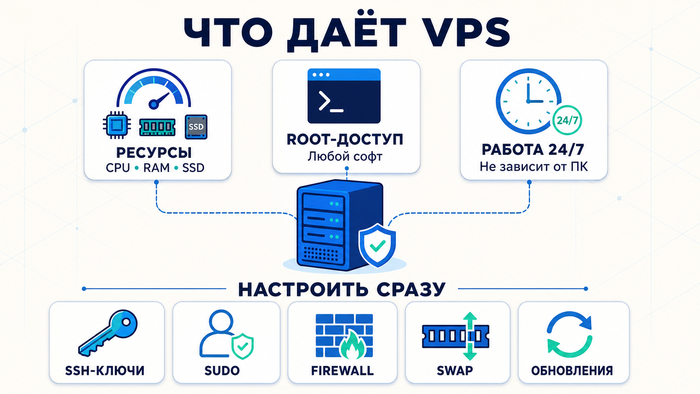
VPS-сервер отличается от shared-хостинга тремя вещами. Первое – у вас есть заявленные параметры тарифа: CPU, RAM, диск и сетевой канал. На качество работы всё ещё может влиять общая инфраструктура хоста, но изоляция здесь выше, чем на shared-хостинге. Второе – root-доступ: можно установить любой софт, выбрать версию PHP, настроить nginx под конкретную задачу. Третье – VPS-сервер работает круглосуточно без вашего участия, независимо от состояния вашего компьютера или интернета. На shared-хостинге чужая нагрузка может повлиять на соседние сайты, если провайдер плохо ограничивает ресурсы аккаунтов.
От облачных функций (AWS Lambda, Yandex Cloud Functions) VPS отличается предсказуемостью: нет cold-start задержек, нет тарификации за каждый вызов функции, нет ограничений по времени выполнения. Для задач с постоянными процессами: баз данных, ботов, мониторинга – VPS часто проще и предсказуемее, чем serverless-архитектура с оплатой за вызов. При низкой или нерегулярной нагрузке serverless может оказаться дешевле.
Настройка VPS начинается не сразу с рабочего проекта, а с базовой конфигурации. Базовая настройка снижает риск классических проблем: открытого SSH, устаревших пакетов, лишних портов и нехватки памяти при пиковых нагрузках. Пропуск таких шагов может увеличить риск потерять сервер из-за брутфорса или случайной команды от root.
• SSH-ключи. Сгенерируйте пару через ssh-keygen, передайте публичный ключ через ssh-copy-id, отключите аутентификацию по паролю в sshd_config.
• Пользователь без root. Создайте аккаунт с правами sudo. Работа от root в продакшене – плохая практика. Одна ошибка может стоить всей системы.
• Firewall. Откройте в UFW SSH-порт, 80 и 443, если они нужны вашему сценарию. Если используется стандартный SSH-порт, это 22. Fail2ban добавит защиту от брутфорса на SSH.
• Swap. Если RAM меньше 2 ГБ, добавьте swap-файл на 1–2 ГБ. Он снижает риск OOM при пиковой нагрузке, но при активном использовании может ухудшить производительность.
• Обновления. Запустите sudo apt update && apt upgrade сразу после входа на сервер, до начала любой работы.
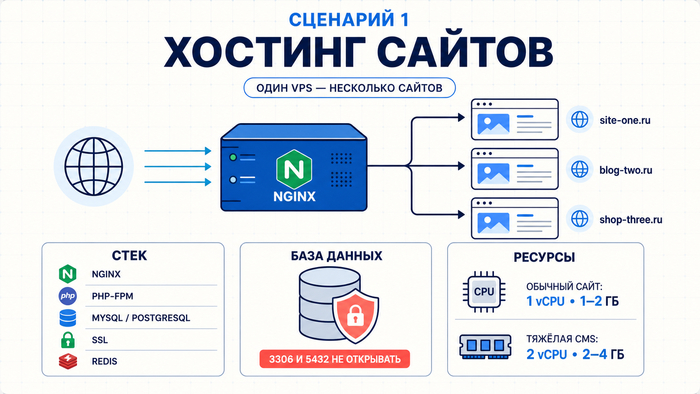
Хостинг на VPS оправдан, когда shared-хостинг перестал справляться: нет нужной версии PHP или Python, не хватает памяти, несколько доменов требуют разных настроек или нестандартного ПО. На VPS больше свободы в настройке: можно выбрать версии ПО, настроить веб-сервер, подключить нужные модули и управлять несколькими проектами независимо. Именно поэтому многие переезжают сюда с первого же конфликта с техподдержкой shared-хостинга.
Стек: Nginx как веб-сервер и reverse proxy, PHP-FPM для WordPress или других CMS, MySQL или PostgreSQL как база данных. Для статических сайтов (Hugo, Astro, Next.js SSG) Nginx работает без интерпретатора, нагрузка минимальная. SSL – Let’s Encrypt через Certbot, бесплатно и с автообновлением. Один Nginx обслуживает несколько доменов через server blocks.
Порты СУБД (3306, 5432) наружу не открывайте: приложение обращается к базе внутри сервера. Для сайта с умеренным трафиком часто хватает 1 vCPU и 1–2 ГБ RAM; для тяжёлых CMS с кешированием, большим числом плагинов или высокой посещаемостью лучше закладывать 2 vCPU и 2–4 ГБ. Добавьте Redis для кеша сессий: это может снизить нагрузку на базу данных и улучшить отклик WordPress при росте трафика.
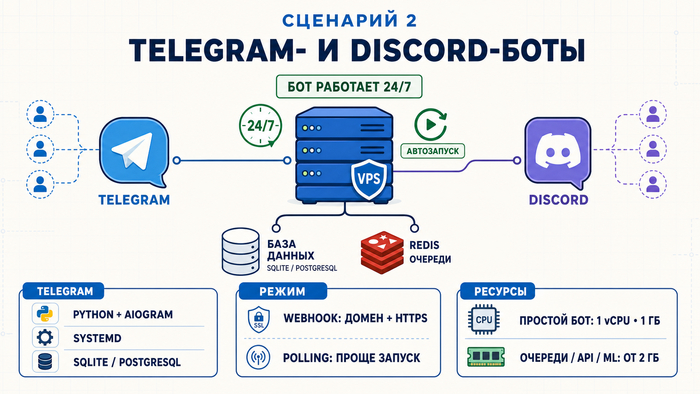
Боту часто нужно работать круглосуточно и хранить состояние: настройки пользователей, историю диалогов, очереди задач. Локальная машина для этого не подходит, а облачные функции удобны в основном для коротких команд без постоянного процесса. VPS решает обе задачи: бот постоянно запущен, а база данных может работать рядом на том же сервере.
Стек для Telegram: Python + aiogram, управление процессом через systemd, хранение состояния в SQLite или PostgreSQL. SQLite подходит для небольших ботов с умеренной нагрузкой, но при высокой конкуренции запросов или запуске нескольких экземпляров приложения лучше сразу выбирать PostgreSQL. Для Discord – Node.js + discord.js, для управления процессом удобен PM2. Redis подойдёт для быстрого хранения временных данных и очередей.
Для большинства продакшен-сценариев с Telegram-ботами удобен webhook-режим: сервер сам получает обновления, не опрашивая API Telegram. Для webhook нужен домен с HTTPS. Polling тоже остаётся корректным вариантом для небольших проектов: он проще в запуске и не требует домена с HTTPS. Простой бот без базы данных умещается на 1 vCPU и 1 ГБ RAM. Бот со сложными очередями, вызовами внешних API и ML-моделями потребует минимум 2 ГБ RAM. Через systemd настраивается автозапуск: после перезагрузки сервера бот поднимется сам.
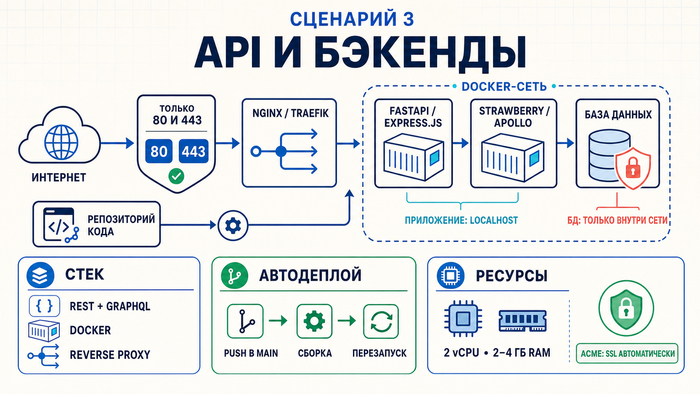
VPS-сервер даёт API постоянный адрес, свою базу данных и полный контроль над окружением, без vendor lock-in и без ограничений по времени выполнения запросов. Это важно для бэкендов с длительными операциями: обработкой файлов, парсингом, генерацией отчётов.
Стек: FastAPI (Python) или Express.js (Node.js) для REST, Docker для изоляции сервисов, Nginx или Traefik как reverse proxy. Приложение слушает на localhost, наружу открыты только 80 и 443. GraphQL – Strawberry (Python) или Apollo Server (Node.js). Для автодеплоя – GitHub Actions: пуш в main запускает пересборку и перезапуск контейнера.
Порты базы данных держите внутри Docker-сети, не открывайте наружу: бэкенд обращается к базе по имени сервиса внутри сети. Для API с базой данных начинайте с 2 vCPU и 2–4 ГБ RAM. При росте нагрузки Docker и reverse proxy позволяют масштабировать сервисы без переписывания архитектуры. Traefik автоматически получает и обновляет SSL-сертификаты через Let’s Encrypt при настроенном ACME, поэтому отдельная настройка Certbot не нужна.
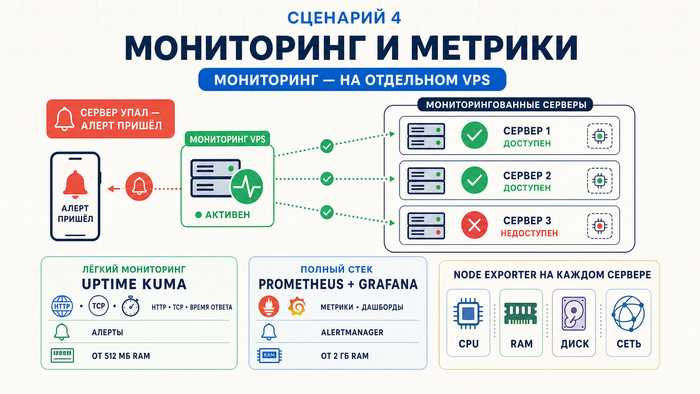
Сервер мониторинга должен работать независимо от мониторируемой инфраструктуры. Если основной сервер упал, система мониторинга должна увидеть это первой и отправить алерт, а не упасть вместе с ним. Отдельный небольшой VPS для мониторинга решает эту задачу.
Uptime Kuma – удобный инструмент с веб-интерфейсом: отслеживает HTTP-статусы, время ответа, порты TCP, отправляет алерты в Telegram, Slack и другие каналы. Разворачивается через Docker за несколько минут и обычно помещается в небольшой VPS. Для лёгкого мониторинга часто достаточно 512 МБ RAM, но потребление зависит от числа проверок и их типа.
Prometheus + Grafana – полный стек для сбора метрик, построения дашбордов и настройки алертов. Prometheus собирает данные с exporters, Grafana строит графики. Оба сервиса вместе могут потреблять примерно 600–1000 МБ RAM в покое, но фактическое потребление зависит от retention, числа targets и объёма метрик. Под этот сценарий обычно стоит закладывать не меньше 2 ГБ RAM. Node Exporter собирает системные метрики хоста – CPU, RAM, диск, сеть; добавьте его на каждый наблюдаемый сервер. Алерты в Telegram настраиваются через Alertmanager за несколько минут.
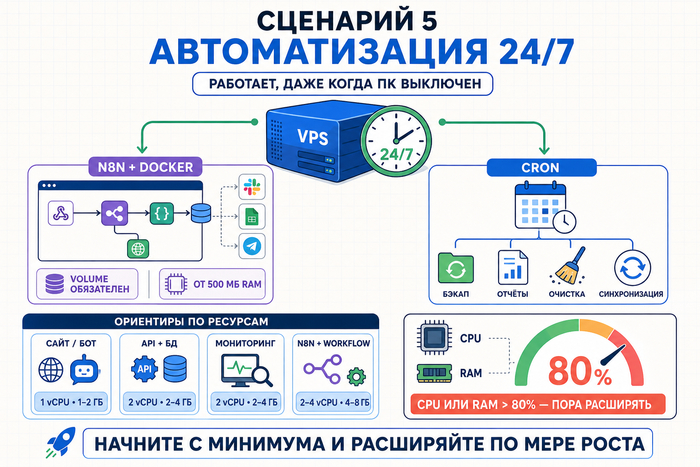
Сервер не выключается. Это главное преимущество VPS для автоматизации: cron-задачи запускаются по расписанию в любое время суток, скрипты работают столько, сколько нужно, без ограничений по времени выполнения и без зависимости от того, включён ли ваш компьютер.
n8n – self-hosted инструмент для визуальной автоматизации, аналог Zapier на вашем сервере. Разворачивается через Docker, а потребление памяти может начинаться примерно от 500 МБ RAM и расти с числом workflow, интеграций и выбранной БД. Данные о задачах хранятся в БД, поэтому volume для персистентности обязателен. Настроенный VPS с n8n заменяет подписку на облачные сервисы автоматизации и не передаёт данные третьим сторонам.
Для простых задач достаточно cron: бэкап файлов, отправка отчётов, очистка временных директорий, синхронизация данных между сервисами.
Примерные ориентиры по ресурсам под основные задачи:
• Сайт или бот без тяжёлых фоновых задач: 1 vCPU, 1–2 ГБ RAM
• API с базой данных: 2 vCPU, 2–4 ГБ RAM
• Prometheus + Grafana: 2 vCPU, 2–4 ГБ RAM
• n8n плюс несколько сценариев одновременно: 2–4 vCPU, 4–8 ГБ RAM
Несколько сценариев на одном VPS совместить возможно, но требования зависят от сложности проекта, выбранного стека, объёма трафика и числа одновременно работающих сервисов. Для простого сайта, небольшого бота и лёгкого мониторинга 2 ГБ RAM могут быть достаточны, если нет тяжёлых фоновых задач. Docker упрощает совмещение: каждый сервис в своём контейнере, порты не конфликтуют, ресурсы лимитируются. Постоянная загрузка CPU или RAM выше 80% может стать сигналом для апгрейда. Начните с минимального тарифа и расширяйте по мере роста – большинство провайдеров позволяют сделать это без пересоздания сервера.
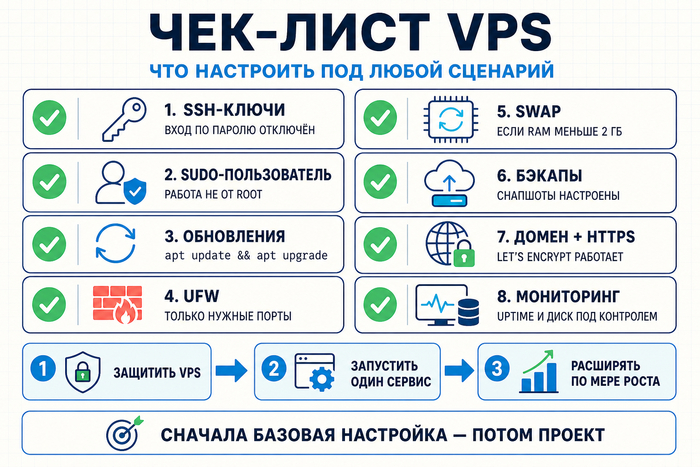
1. SSH-ключи настроены, аутентификация по паролю отключена
2. Создан sudo-пользователь, работа от root прекращена
3. Система обновлена: sudo apt update && apt upgrade
4. UFW включён: открыты только нужные входящие порты, например SSH-порт, 80 и 443 для веб-сценариев
5. Swap настроен при RAM < 2 ГБ
6. Автоматические снапшоты или бэкапы настроены
7. Домен привязан, HTTPS работает через Let’s Encrypt
8. Базовый мониторинг: uptime и диск под контролем
VPS это не готовый продукт, а платформа для разных задач: сайта, бота, API, мониторинга или автоматизации. Начните с одного сценария, не пытайтесь запускать всё сразу. Сначала закройте базовую настройку из чек-листа: SSH-ключи, firewall, обновления, бэкапы и мониторинг. После этого разверните минимальную рабочую версию сервиса и расширяйте конфигурацию по мере роста нагрузки.
Облачный инстанс создан, SSH-доступ работает, и первое, что хочется сделать, это запустить приложение. Но новый сервер в этот момент уязвим: root-доступ может быть разрешён, часть пакетов требовать обновления, firewall ещё не настроен, мониторинга нет. Автоматические сканеры находят новые IP-адреса за минуты и начинают перебор паролей ещё до того, как вы откроете второй терминал.
Настройка облачных серверов перед нагрузкой – это четыре конкретных блока: сеть, пользователи и доступ, firewall, мониторинг. Каждый занимает от десяти минут до получаса. Пропустить любой – значит получить дыру в безопасности и эксплуатации.
Разберём все четыре блока по порядку на примере Ubuntu 22.04 LTS. Все команды воспроизводимы и проверены. Порядок шагов важен: каждый следующий опирается на предыдущий. Не запускайте приложение до настройки firewall: незащищённый VPS с открытым SSH быстро попадает под автоматический перебор паролей.
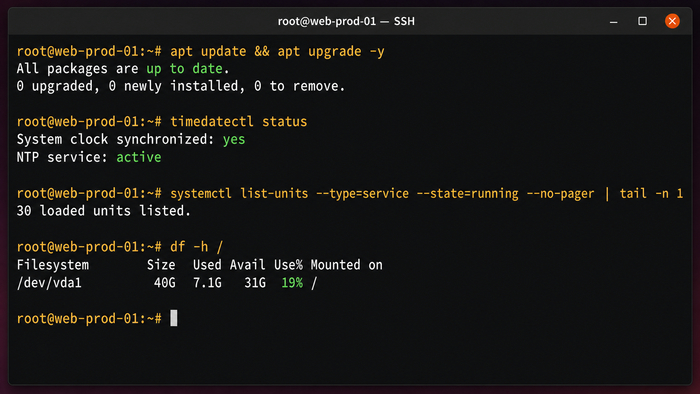
Терминал Ubuntu 22.04 с обновлением пакетов, проверкой синхронизации времени, запущенных служб и свободного места на диске.
Прежде чем двигаться дальше, нужно привести систему в актуальное состояние. Образы облачных провайдеров зачастую собираются заранее и поставляются с пакетами недельной или месячной давности. Первое же обновление нередко закрывает десятки CVE, включая критические в OpenSSH и ядре. Выполните:
apt update && apt upgrade -y
Если обновление затронуло ядро – перезагрузите сервер. После перезагрузки убедитесь, что соединение восстановилось, и продолжайте.
Следующий шаг – проверить синхронизацию времени. Расхождение системных часов ломает TLS-рукопожатие, сбивает JWT-токены и делает логи бесполезными при сравнении событий с разных хостов. На Ubuntu 22.04 за это отвечает systemd-timesyncd. Проверьте его статус:
timedatectl status
В строке NTP service должно стоять active. Если нет – включите вручную:
systemctl enable --now systemd-timesyncd
Также сразу посмотрите, что уже запущено на сервере, и сколько свободно дискового пространства. На минимальном образе Ubuntu 22.04 запущено около 25–30 системных сервисов. Если их заметно больше, образ уже преднастроен провайдером:
systemctl list-units --type=service --state=running
df -h
Если корневой раздел занят более чем на 80%, разберитесь с этим до любых дальнейших шагов: нехватка места ломает обновления пакетов, ротацию логов и запись временных файлов.
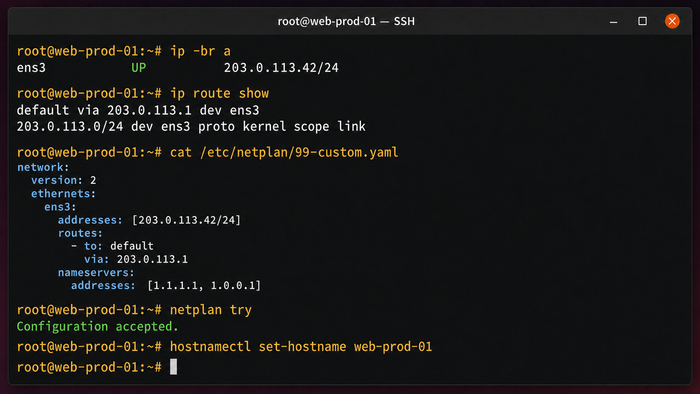
Терминал Ubuntu 22.04 с проверкой сети, настройкой статического IP через Netplan и изменением имени облачного сервера.
Начните с просмотра текущего состояния сетевых интерфейсов. Две команды дают полную картину: какие интерфейсы подняты, какие IP назначены и куда идёт маршрут по умолчанию.
ip a
ip route show
В выводе ip a найдите интерфейс с публичным IP-адресом – обычно это ens3, ens4 или eth0, в зависимости от провайдера. Запомните его имя: оно понадобится в конфигурации netplan.
На Ubuntu 22.04 сетевые настройки управляются через netplan: конфигурационные файлы лежат в /etc/netplan/. Если провайдер использует cloud-init для автоматической конфигурации сети, в /etc/netplan/ уже может быть файл 50-cloud-init.yaml. Его можно редактировать, но изменения могут быть перезаписаны cloud-init при следующей перезагрузке или пересоздании конфигурации. Безопаснее создать отдельный файл с более высоким приоритетом, например 99-custom.yaml: числа в именах файлов определяют порядок применения, большее число применяется последним и переопределяет предыдущее.
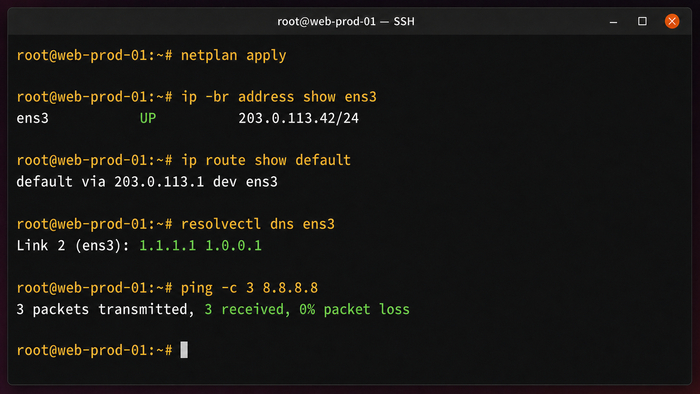
Терминал Ubuntu 22.04 с применением Netplan и проверкой IP-адреса, маршрута, DNS и внешнего соединения.
Директива addresses задаёт статический IP с маской. routes описывает маршрут по умолчанию – шлюз, через который идёт весь трафик. nameservers – DNS-серверы; при необходимости укажите серверы провайдера или вашего корпоративного резолвера.
Перед применением проверьте конфигурацию через netplan try: он применит настройки и автоматически откатит их через 120 секунд, если вы не подтвердите. Это страховка от потери соединения. Если всё в порядке – зафиксируйте:
netplan apply
Последний штрих – задать осмысленное имя хоста. Понятное имя упрощает навигацию в логах и мониторинге, особенно когда серверов несколько:
hostnamectl set-hostname web-prod-01
echo "127.0.1.1 web-prod-01" >> /etc/hosts
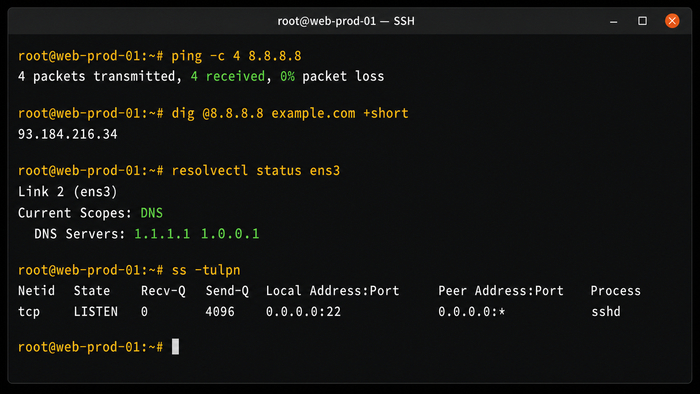
Терминал Ubuntu 22.04 с успешной проверкой подключения, DNS-серверов и открытого SSH-порта.
Если после применения netplan что-то пошло не так, три команды помогут локализовать проблему:
ping -c 4 8.8.8.8 # внешняя связь
ss -tulpn # открытые порты и слушающие процессы
dig @8.8.8.8 example.com # DNS
Если ping проходит, а dig не разрешает имена – проблема в DNS. На Ubuntu 22.04 DNS управляется через systemd-resolved. Его состояние:
resolvectl status
Если dig не установлен, установите пакет:
apt install bind9-dnsutils -y
В выводе resolvectl смотрите секцию DNS Servers для каждого интерфейса. Если серверы не отображаются или стоит 127.0.0.53, убедитесь, что в файле netplan прописан раздел nameservers, и заново примените конфигурацию.
Команда ss -tulpn полезна не только при диагностике сети: её стоит запускать после каждого шага настройки, чтобы убедиться – ничего лишнего не появилось на открытых портах.
Постоянно работать от root – плохая практика. Опечатка в пути к файлу под root может уничтожить данные без возможности отмены. Любая уязвимость в запущенном от root приложении даёт атакующему полный контроль над системой. При командной работе аудит затруднён: в логах нет разграничения между разными администраторами.
Создайте пользователя для повседневной работы. В Ubuntu удобнее использовать adduser: команда создаёт домашнюю директорию, настраивает оболочку и интерактивно запрашивает пароль.
adduser <name>
usermod -aG sudo <name>
Команда usermod -aG sudo <name> добавляет пользователя в группу sudo. На Ubuntu эта группа по умолчанию имеет право выполнять любые команды через sudo без изменения файла /etc/sudoers. Проверьте, что всё работает не закрывая текущую сессию root:
su - <name>
sudo whoami # должно вывести: root
Для входа по SSH без пароля сгенерируйте ключ на локальной машине и скопируйте публичную часть на сервер. Тип ed25519 предпочтительнее rsa:
# На локальной машине
ssh-keygen -t ed25519 -C "user@pc_name"
ssh-copy-id <name>@<IP_сервера>
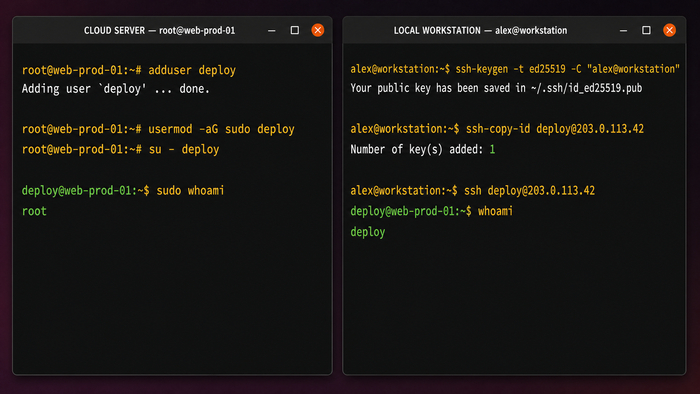
Два терминала: создание пользователя deploy и проверка sudo на Ubuntu-сервере, генерация и копирование SSH-ключа с локального компьютера.
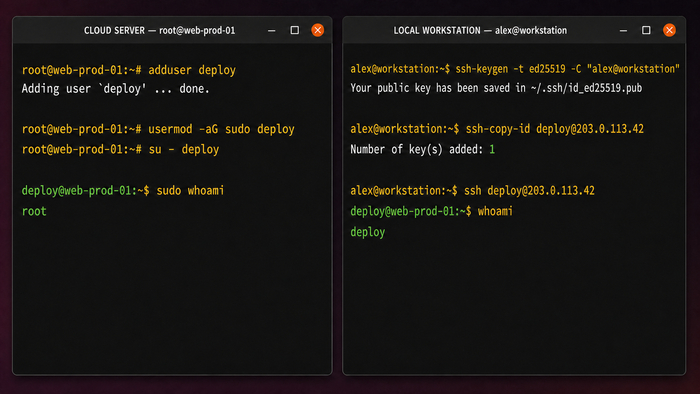
Два терминала: создание пользователя deploy и проверка sudo на Ubuntu-сервере, генерация и копирование SSH-ключа с локального компьютера.
Если нужно добавить публичный ключ вручную – создайте структуру директорий самостоятельно. Разрешения важны: 700 на директорию, 600 на файл:
mkdir -p /home/<name>/.ssh && chmod 700 /home/<name>/.ssh
echo "ssh-ed25519 AAAA..." >> /home/<name>/.ssh/authorized_keys
chmod 600 /home/<name>/.ssh/authorized_keys
chown -R <name>:<name> /home/<name>/.ssh
После настройки ключа войдите в новый сеанс под пользователем через SSH. Убедитесь, что аутентификация по ключу работает, и только после этого переходите к следующему шагу.
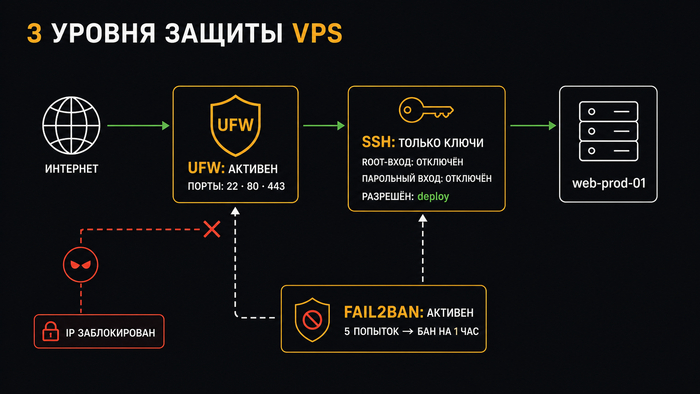
Настройка SSH на сервере сводится к нескольким директивам в /etc/ssh/sshd_config. Ключевой принцип: ограничить поверхность атаки. Откройте файл:
nano /etc/ssh/sshd_config
Перед отключением парольного входа не закрывайте текущую root-сессию и убедитесь, что вход по SSH-ключу работает в новом терминале. Если в конфиге или ключах есть ошибка, SSH-доступ можно потерять, и восстанавливать его придётся через консоль провайдера, VNC/KVM или rescue mode.
Внесите следующие изменения:
# Запретить прямой вход под root
PermitRootLogin no
# Только ключи; пароли не принимать
PasswordAuthentication no
PubkeyAuthentication yes
# Разрешить вход только указанному пользователю
AllowUsers deploy
# Сократить время и попытки аутентификации
MaxAuthTries 3
LoginGraceTime 30
PermitRootLogin no закрывает наиболее атакуемый вектор: большинство автоматических сканеров перебирают именно root. PasswordAuthentication no убирает парольный вход полностью после этого единственным способом войти остаются SSH-ключи. AllowUsers deploy добавляет дополнительный слой: даже если на сервере появятся другие пользователи, по SSH они войти не смогут.
Директива AllowUsers особенно полезна при командной работе: она задаёт явный белый список тех, кто может войти по SSH. Новый пользователь, не включённый в список, не получит доступ даже с корректным ключом.
Перед перезапуском проверьте синтаксис конфига, ошибка в директиве заблокирует вас при работающем соединении:
sshd -t # пустой вывод означает: конфиг корректен
systemctl restart ssh
Откройте новый терминал и убедитесь, что вход по ключу работает, прежде чем закрывать текущую сессию. Это самая частая ошибка при настройке SSH: отключают парольный вход до того, как проверяют, что ключ принимается.
Дополнительно: смена стандартного порта 22 на нестандартный снижает количество автоматических сканирований и шум в логах. Если решите сменить, сначала откройте новый порт в UFW, затем измените Port в конфиге и перезапустите sshd, не наоборот.
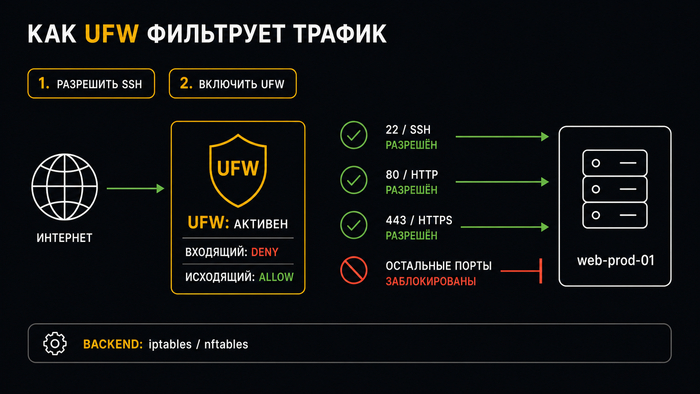
UFW – стандартный инструмент управления firewall на Ubuntu. Он даёт простой интерфейс для настройки правил, а конкретный backend зависит от версии Ubuntu и конфигурации системы: это может быть iptables-совместимый слой или nftables. На новом сервере UFW установлен, но часто не активирован.
Настройка облачных серверов без активного firewall оставляет все порты открытыми. Порядок имеет значение: сначала разрешить SSH, потом включать UFW, иначе заблокируете собственное соединение:
ufw default deny incoming # всё входящее – запрещено по умолчанию
ufw default allow outgoing # исходящий трафик – разрешён
ufw allow 22/tcp # SSH – до ufw enable!
ufw allow 80/tcp # HTTP
ufw allow 443/tcp # HTTPS
ufw enable
ufw status verbose
Если SSH настроен на нестандартный порт, замените 22 на него. Правило ufw status verbose покажет активные разрешения и политику по умолчанию – полезно сверить сразу после включения.
Для отладки сначала используйте вывод UFW:
ufw status verbose
Если нужно посмотреть низкоуровневые правила, используйте инструмент, который соответствует backend системы:
iptables -L -n --line-numbers
или:
nft list ruleset

На Ubuntu 22.04 UFW может работать через iptables-совместимый backend или nftables. Поэтому не стоит ориентироваться только на одну цепочку INPUT: фактическое расположение правил зависит от backend и конфигурации системы.
Для автоматической блокировки IP-адресов после нескольких неудачных попыток входа установите fail2ban:
apt install fail2ban -y
systemctl enable --now fail2ban
Создайте файл пользовательских настроек /etc/fail2ban/jail.local. Редактировать jail.conf напрямую не стоит – он перезаписывается при обновлении пакета:
[DEFAULT]
bantime = 1h
findtime = 10m
maxretry = 5
[sshd]
enabled = true
При таких настройках IP блокируется на час после пяти неудачных попыток входа за десять минут. Перезапустите сервис и проверьте статус jail:
systemctl restart fail2ban
fail2ban-client status sshd
В выводе Currently banned покажет количество активных блокировок. Разбанить конкретный IP можно командой fail2ban-client set sshd unbanip <IP>. Кроме SSH, fail2ban поддерживает джейлы для nginx, apache2 и postfix. Они конфигурируются аналогично, добавлением отдельных секций в jail.local.
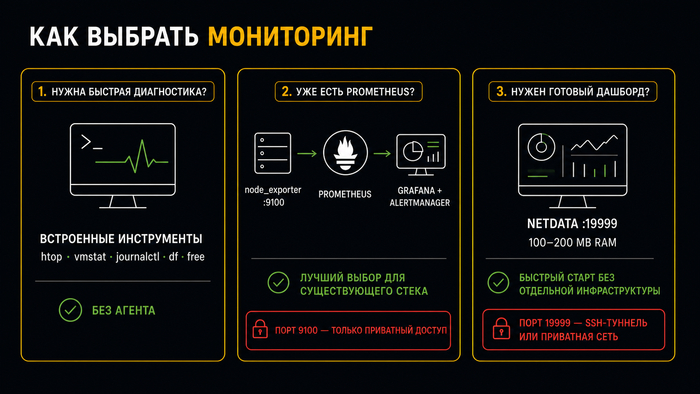
Мониторинг сервера Linux без агентов начинается со встроенных инструментов. Для быстрой диагностики их вполне хватает:
htop # интерактивный монитор (apt install htop)
vmstat 1 5 # CPU, память, I/O каждую секунду
journalctl -u nginx --since "1 hour ago" # логи конкретного сервиса
df -h && free -h # диск и память
Для постоянного мониторинга с метриками и алертами нужен агент. Выбор зависит от контекста: если в инфраструктуре уже есть Prometheus, оптимален node_exporter – он экспортирует более 800 метрик ОС с минимальным потреблением ресурсов (около 20–50 MB RAM):
apt install prometheus-node-exporter -y
systemctl enable --now prometheus-node-exporter
Агент слушает на порту 9100 и отдаёт метрики в формате Prometheus по адресу http://<IP>:9100/metrics. Добавьте этот адрес как scrape target в конфигурацию Prometheus, и метрики появятся в Grafana. Не открывайте порт 9100 наружу: ограничьте доступ через security group, UFW или приватную сеть Prometheus.
Если Prometheus ещё нет – Netdata даёт готовый интерактивный дашборд из коробки, без дополнительной инфраструктуры:
apt install netdata -y
systemctl enable --now netdata
Netdata слушает на порту 19999. Настройте SSH-туннель для разового просмотра или nginx с basic auth для постоянного доступа. Netdata потребляет от 100 MB RAM, на VPS с 1 GB это существенная разница по сравнению с node_exporter.
Алерты настраиваются поверх метрик. Для node_exporter используйте Prometheus Alertmanager: правила на PromQL, уведомления в Slack, email или PagerDuty. Для Netdata встроена собственная система уведомлений – настройте её в /etc/netdata/health_alarm_notify.conf. На практике для старта хватает трёх порогов: CPU load выше числа vCPU, диск выше 85%, список упавших сервисов непуст.
На только что настроенном сервере важны шесть базовых показателей:
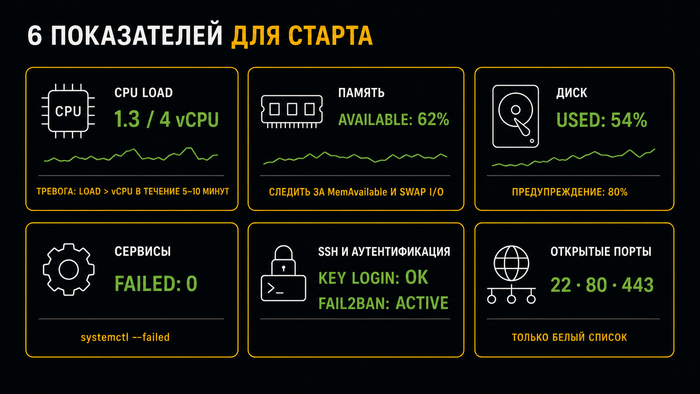
CPU load average – если значение устойчиво превышает количество vCPU в течение 5–10 минут, сервер перегружен. htop или uptime показывают три скользящих средних: за 1, 5 и 15 минут.
Память – при использовании свыше 85% система начинает активно использовать swap, что резко увеличивает latency. Для веб-серверов и баз данных это ощутимо. Контролируется через free -h.
Диск – заполненность свыше 80% блокирует запись логов, временных файлов и данных приложений. Дополнительно следите за iostat (из пакета sysstat) – высокий await при умеренной нагрузке указывает на проблемы с хранилищем.
Failed services – systemctl --failed выводит список упавших юнитов. Перед выводом в продакшен этот список должен быть пустым.
Auth log – journalctl -u ssh --since "1 hour ago" покажет активность после настройки fail2ban. Строки Failed password могут продолжать появляться до бана или с других IP-адресов. Важнее проверить, что fail2ban видит попытки входа и добавляет нарушителей в jail; строки Accepted publickey должны соответствовать вашим успешным входам.
Открытые порты – ss -tulpn один раз после каждого изменения конфигурации. Всё, что слушает наружу, должно быть в явном белом списке UFW.
Пройдитесь по списку перед открытием сервера под рабочий трафик:
• Непривилегированный пользователь создан, добавлен в sudo
• Перед отключением парольного входа проверен вход по SSH-ключу в новом терминале
• PasswordAuthentication no и PermitRootLogin no прописаны в sshd_config
• UFW включён: ufw status verbose показывает только нужные порты
• fail2ban запущен: fail2ban-client status sshd показывает активный jail
• Пакеты обновлены: apt upgrade -y выполнен, при обновлении ядра – перезагрузка
• NTP активен: timedatectl показывает NTP service: active
• Мониторинг-агент запущен и метрики доступны
• Бэкапы настроены через панель провайдера или отдельный инструмент
• systemctl --failed возвращает пустой список
• Имя хоста и /etc/hosts настроены корректно
Четыре блока: сеть, пользователи, firewall, мониторинг – это минимальная конфигурация, без которой облачный сервер не готов к продакшену. Пропуск любого из этих шагов рано или поздно даёт о себе знать: либо взломом, либо аварией без видимой причины, либо часами поиска проблемы в логах.
Сохраните этот гайд и пройдитесь по нему при следующем деплое нового инстанса. В блоге Aeza регулярно выходят материалы по администрированию и безопасности серверов – подпишитесь, чтобы не пропускать NETTOWN5 обновления.