kliMaster

kliMaster

https://www.securitylab.ru/_services/export/rss/
На Пикабу
64К рейтинг 759 подписчиков 75 подписок 306 постов 107 в горячем
Награды:
10 лет на Пикабу
2414

Пасхалка в Mr Robot S02E01.
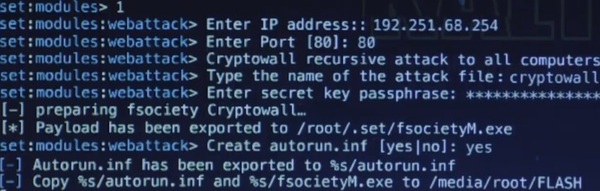
В конце первой серии второго сезона Mr Robot есть сцена, где Дарлин генерирует троян-вымогатель с помощью модифицированного фреймворка SET (Social Engineer Toolkit). Мои пальцы просто зудели, чтобы попробовать IP-адрес 192.251.68.254, где вроде как располагается управляющий сервер трояна. Неудивительно, что WHOIS показал на владельца NBC-UNIVERSAL. Посмотрим, насколько глубока кроличья нора.
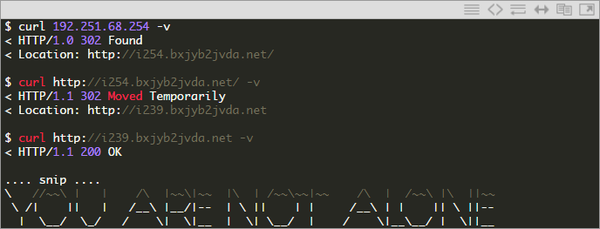
Последняя страница http://i239.bxjyb2jvda.net/ выводит сообщение «YOUR PERSONAL FILES ARE ENCRYPTED» и начинает обратный отсчёт. Вы можете подождать 24 часа или просто проверить javascript, который управляет таймером обратного отсчёта, где вы найдёте строку, закодированную в base64.


PGRpdiBjbGFzcz0ib3ZlciI+PGRpdj4iSSBzaW5jZXJlbHkg


YmVsaWV2ZSB0aGF0IGJhbmtpbmcgZXN0YWJsaXNobWVudHM


gYXJlIG1vcmUgZGFuZ2Vyb3VzIHRoYW4gc3RhbmRpbmcgYXJta


WVzLCBhbmQgdGhhdCB0aGUgcHJpbmNpcGxlIG9mIHNwZW5k


aW5nIG1vbmV5IHRvIGJlIHBhaWQgYnkgcG9zdGVyaXR5LCB1bm


RlciB0aGUgbmFtZSBvZiBmdW5kaW5nLCBpcyBidXQgc3dpbmRs


aW5nIGZ1dHVyaXR5IG9uIGEgbGFyZ2Ugc2NhbGUuIjwvZGl2Pjx


kaXYgY2xhc3M9ImF1dGhvciI+LSBUaG9tYXMgSmVmZmVyc29u


PC9zcGFuPjwvZGl2PjwvZGl2Pg==

После раскодирования выходит:


Я искренне полагаю, что банковские институты более опасны для свободы, нежели регулярные армии, и что принцип тратить деньги за счёт потомков, под названием «финансирование», ничто иное как жульничество за счёт будущего в крупном масштабе.


– Томас Джефферсон


Кстати, изучив SSL-сертификат веб-сервера NBC-UNIVERSAL, я обнаружил массу других доменов, которые имеют отношение к Mr Server., указанных в поле Subject Alternative Names.


DNS Name=www.racksure.com


DNS Name=racksure.com


DNS Name=*.serverfarm.evil-corp-usa.com


DNS Name=www.e-corp-usa.com


DNS Name=iammrrobot.com


DNS Name=www.conficturaindustries.com


DNS Name=www.iammrrobot.com


DNS Name=*.seeso.com


DNS Name=*.evil-corp-usa.com


DNS Name=e-corp-usa.com


DNS Name=*.bxjyb2jvda.net


DNS Name=whoismrrobot.com


DNS Name=seeso.com


DNS Name=fsoc.sh


DNS Name=www.fsoc.sh


DNS Name=conficturaindustries.com


DNS Name=whereismrrobot.com


DNS Name=www.whoismrrobot.com


DNS Name=www.whereismrrobot.com


DNS Name=evil-corp-usa.com


DNS Name=www.seeso.com


В начале первой серии второго сезона вы также заметите, как Эллиот логинится на bkuw300ps345672-cs30.serverfarm.evil-corp-usa.com по SSH.


Что касается задачки на https://fsoc.sh:

Если посмотрите на эту страничку, то заметите, что курсор мигает через разные интервалы.


На самом деле несложно понять, что это код Морзе, но я крайне плох в решении таких загадок вручную. Поэтому решил применить более техничный способ.


https://www.fsoc.sh/assets/main.js

addHandlers: function() {
var t = this;
this.$(".eye__form").on("submit", this.handleSubmit), this.textView.on("typingEnded", function() {
t.appendEye(), t.startCursor("MzkzMzUzNTM5NTMzMzk1Mzc5OTUzNzMzMzM1MzUzOTM1Mw==")
})
},


startCursor: function(t) {
var e = this;
e.$(".eye__cursor").css("opacity", 0).removeClass("typing"), setTimeout(function() {
e.handleBlinkTime(window.atob(t), 0)
}, 500)
},
handleBlinkTime: function(t, e) {
var n = 300,
r = t.charAt(e),
i = 0,
o = n;
switch (r) {
case "9":
i = 3 * n;
break;
case "3":
i = n;
break;
case "5":
o = 3 * n;
break;
case "7":
o = 7 * n
}
var u = this;
i && u.$(".eye__cursor").css("opacity", 1), setTimeout(function() {
u.$(".eye__cursor").css("opacity", 0), setTimeout(function() {
t.length > e + 1 ? u.handleBlinkTime(t, e + 1) : setTimeout(function() {
u.handleBlinkTime(t, 0)
}, 4e3)
}, o)
}, i)

Собственно, скорость мерцания курсора контролирует t.startCursor("MzkzMzUzNTM5NTMzMzk1Mzc5OTUzNzMzMzM1MzUzOTM1Mw=="), и если конверитровать в ASCII, то получается 3933535395333953799537333353539353.


3 это точка "."


5 разделяет буквы " "


7 представляет собой разделитель "/" в коде Морзе


а 9 это тире "-"


3933535395333953799537333353539353


.-…. .- ...- ./-- ./…. .-.. == LEAVE ME HERE


Нужно добавить, что во втором сезоне сериал сохранил крайнюю реалистичность компьютерных сцен. Каждый взлом и операция выполняются в правильной последовательности и с использованием корректных инструментов. В первом сезоне мы видели операционку Kali Linux, использование уязвимости bashdoor (shellshock) для получения файла /etc/passwd, взлом автомобильной CAN-шины с использованием утилиты candump, сканирование окружающих устройство с активным Bluetooth утилитой btscanner из комплекта Kali Linux, использование снифера bluesniff для MiTM-атаки с последующим запуском оболочки Meterpreter.


В первой серии второго сезона все технические тонкости — фреймворк SET, ransomware, логи IRC, клиент BitchX и прочее — тоже показаны вполне достоверно.


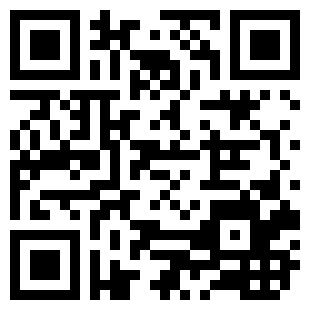
Ремарка: В одном из кадров мелькает QR-код, который указывает на один из доменов списка, приведённого выше: http://www.conficturaindustries.com.
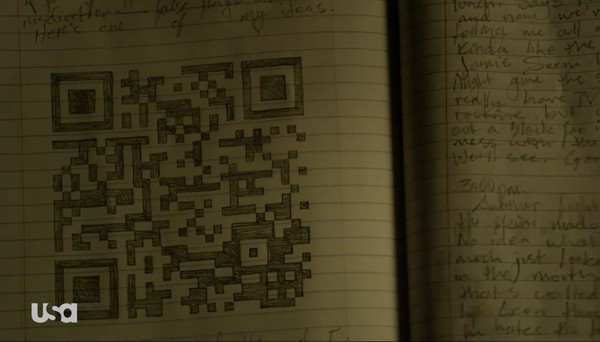
Код плохо распознаётся с кадра, вот чёткая копия:
Судя по всему, будущие серии Mr Robot тоже не останутся без пасхалок.


Технические консультанты Mr Robot из хакерского сообщества: @KorAdana, @ryankaz42, @AndreOnCyber, @MOBLAgentP, @IntelTechniques, @marcwrogers.
Показать полностью 4
37

Срочно обновляем Google Chrome. Google исправила 0-day уязвимость в Chrome.

Инженеры Google неожиданно выпустили Chrome 78.0.3904.87 для Windows, Mac и Linux, где исправлена уязвимость нулевого дня, уже находящаяся под атаками. Проблема получила идентификатор CVE-2019-13720 и представляет собой use-aster-free баг в аудиокомпоненте браузера.


Уязвимость обнаружили специалисты «Лаборатории Касперского», которые уже опубликовали детальный анализ проблемы. Эксперты пишут, что баг используется для установки малвари на компьютеры жертв.

Полная версия: https://xakep.ru/2019/11/01/chrome-0day/


Как обновить Google Chrome: https://support.google.com/chrome/answer/95414

Срочно обновляем Google Chrome. Google исправила 0-day уязвимость в Chrome.
256

Малварь Muhstik взломали. Ключи дешифрования уже опубликованы.

https://xakep.ru/2019/10/08/muhstik/

..........

При этом Фремель не ограничился и простой публикацией ключей. Он также выпустил инструмент для дешифровки пострадавшей информации, доступный для скачивания через MEGA. Подробную инструкцию по его использованию можно найти на форуме Bleeping Computer.


https://www.bleepingcomputer.com/forums/t/705604/muhstik-qna...


https://mega.nz/#!O9Jg3QYZ!5Gj8VrBXl4ebp_MaPDPE7JpzqdUaeUa5m...

Всё о парсинге сайтов на Python

Делюсь тем что считаю ИМХО интересным, прошу не нужно меня обсуждать и давать мне советы, иначе вы быстро подружитесь с моим игнор листом.

Михаил Коробов и Константин Лопухин (Scrapinghub) «Как собрать датасет из интернета»


Часть 1


Анализ данных предполагает, в первую очередь, наличие этих данных. Первая часть доклада рассказывает о том, что делать, если у вас не имеется готового/стандартного датасета, либо он не соответствует тому, каким должен быть. Наиболее очевидный вариант — скачать данные из интернета. Это можно сделать множеством способов, начиная с сохранения html-страницы и заканчивая Event loop (моделью событийного цикла). Последний основан на параллелизме в JavaScript, что позволяет значительно повысить производительность. В парсинге event loop реализуется с помощью технологии AJAX, утилит вроде Scrapy или любого асинхронного фреймворка.


Извлечение данных из html связано с обходом дерева, который может осуществляться с применением различных техник и технологий. В докладе рассматриваются три «языка» обхода дерева: CSS-селекторы, XPath и DSL. Первые два состоят в довольно тесном родстве и выигрывают за счет своей универсальности и широкой сфере применения. DSL (предметно-ориентированный язык, domain-specific language) для парсинга существует довольно много, и хороши они, в первую очередь, тем, что удобство работы с ним осуществляется благодаря поддержке IDE и валидации со стороны языка программирования.


Для тренировки написания пауков компанией ScrapingHub создан учебный сайт toscrape.com, на примере которого рассматривается парсинг книжного сайта. С помощью chrome-расширения SelectorGadget, которое позволяет генерировать CSS-селекторы, выделяя элементы на странице, можно облегчить написание скрапера.

import scrapy


class BookSpider(scrapy.Spider):


name = 'books'


start_urls = ['http://books.toscrape.com/']


def parse(self, response):


for href in response.css('.product_pod a::attr(href)').extract():


url = response.urljoin(href)


print(url)


Пример без scrapy:


import json

from urllib.parse import urljoin


import requests


from parsel import Selector


index = requests.get('http://books.toscrape.com/')


books = []


for href in Selector(index.text).css('.product_pod a::attr(href)').extract():


url = urljoin(index.url, href)


book_page = requests.get(url)


sel = Selector(book_page.text)


books.append({


'title': sel.css('h1::text').extract_first(),


'price': sel.css('.product_main .price_color::text')extract_first(),


'image': sel.css('#product_gallery img::attr(src)').extract_first()


})


with open('books.json', 'w') as fp:


json.dump(books, fp)


Некоторые сайты сами помогают парсингу с помощью специальных тегов и атрибутов html. Легкость парсинга улучшает SEO сайта, так как при этом обеспечивается большая легкость поиска сайта в сети.


Часть 2


О скорости скачивания страниц, распределении на процессы и способах их координации. При больших объемах выборки данных важно оптимизировать скорость и частоту запросов таким образом, чтобы не положить сайт и не быть заблокированным за бомбардировку автоматическими запросами. Это может быть реализовано путем разбиения на несколько процессов: например, разделив между ними url-ы, чтобы в рамках одного процесса осуществлялся парсинг одного сайта. Еще один вариант — общая очередь, куда помещаются запросы и достаются по мере необходимости.


Какие существуют варианты хранения полученных данных? Можно извлекать информацию сразу, либо сохранять HTML-страницы для последующей обработки в исходном (около 100КБ) или сжатом (15 КБ) размере. Порядок обхода сайта для извлечения данных зависит от его объема и структуры. Большинство современных сайтов представляют собой весьма сложные конфигурации большого числа страниц со ссылками друг на друга, напоминающие паутину. Две стандартные стратегии обхода: в глубину и в ширину. Плюсы и минусы обхода в глубину:


небольшой размер очереди запросов


удобен для краулера одного сайта


может не подойти для обхода всех ссылок (т.к. глубина может быть очень боьлшой или бесконечной)


Особенности в ширину:


подходит для обхода всех ссылок на сайте


большой размер очереди


реальная глубина — 2-4


возможные проблемы глубины в графе ссылок


Вторая часть доклада посвящена примерам ресурсов, предоставляющих готовые датасеты, собранные со всего интернета. В базе данных Common Crawl, например, хранится около 300 ТБ информации, которая обновляется каждый месяц. Сервис Web Data Commons извлекает из Common Crawl структурированные данные.


Дмитрий Сергеев (ZeptoLab) «Написание пауков, или что делать, когда тебя вычисляют по IP»


Как вести себя, если при сборе данных сервер блокирует ваши автоматические запросы, выдавая ошибки 403, 404, 503 и так далее? Во-первых, нужно запастись терпением и пожертвовать частотой отправки запросов. Ни один уважающий себя сервер не потерпит бесцеремонной продолжительной бомбардировки автоматическими запросами. Докладчик столкнулся с этим лично, проводя на досуге исследование популярности мемов на одном из популярных информационных ресурсов. Будучи заблокированным по IP, он написал письмо в техподдержку с просьбой разбанить его, на что получил автоматический ответ о разблокировке. Подумав, что, если ему отвечает автомат, то и просить о разблокировке можно автоматически, он написал бота, который при каждом бане отправлял поддержке письмо с текущим IP и слезной просьбой о разбане. Автоматы переписывались всю ночь, в течение которой докладчик выяснил, что время ожидания разбана растет экспоненциально.


Постепенно он учился быть похожим на человека не нарушая трех законов робототехники имитируя браузер: ставя временны′е заглушки перед запросами (при заполнении форм, кликах на кнопки, переходе по страницам, параллельных запросах и т.д.):


time.sleep(3)


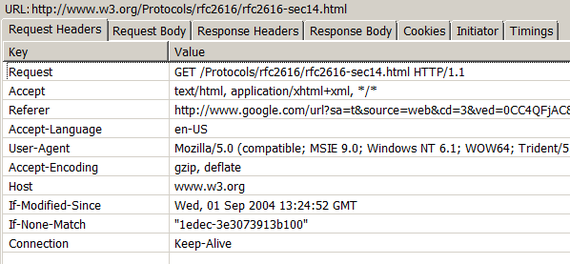
генерируя случайные юзер-агенты:

https://proglib.io/wp-content/uploads/-000//1/request-header...

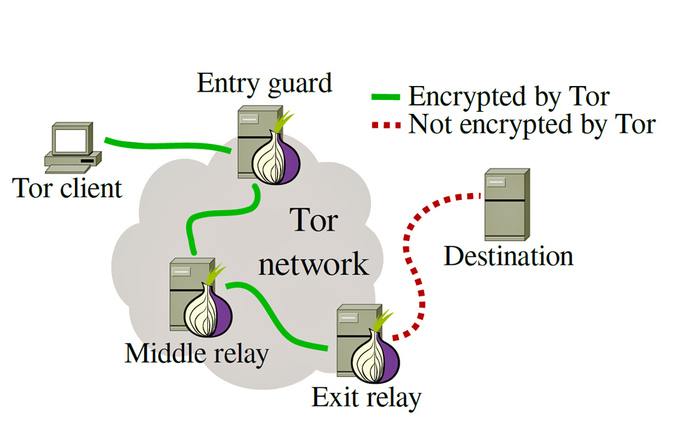
и используя Tor для многоуровневой переадресации:

Комбинация этих методов позволяет достичь желаемого объема полученной информации без потери времени на баны и ожидание разблокировки.


Пример


Пример кода, который использует генератор хэдеров и тор для определения текущего IP-адреса:


import os


import socket


import requests


import time


import socks


import stem.process


from stem import Signal


from stem.control import Controller


from user_agent import generate_user_agent


current_time = lambda: int(round(time.time()))


class Network:


def switch_ip(self):


self.controller.signal(Signal.NEWNYM)


print("Switching IP. Waiting.")


t = current_time()


time.sleep(self.controller.get_newnym_wait())


print("{0}s gone".format(current_time() - t))


def print_bootstrap_lines(self, line):


print(line)


def init_tor(self, password='supersafe', log_handler=None):


self.tor_process = None


self.controller = None


try:


self.tor_process = stem.process.launch_tor_with_config(


tor_cmd=self.tor_path,


config=self.tor_config,


init_msg_handler=log_handler


)


self.controller = Controller.from_port(port=self.SOCKS_PORT + 1)


self.controller.authenticate(password)


except:


if self.tor_process is not None:


self.tor_process.terminate()


if self.controller is not None:


self.controller.close()


raise RuntimeError('Failed to initialize Tor')


socket.socket = self.proxySocket


def kill_tor(self):


print('Killing Tor process')


if self.tor_process is not None:


self.tor_process.kill()


if self.controller is not None:


self.controller.close()


def __init__(self):


# путь к директории файлов браузера Tor. В данном случае, директория для OS X


TOR_DIR = '/Applications/TorBrowser.app/Contents/Resources/TorBrowser/Tor/'


PASS_HASH = '16:DEBBA657C88BA8D060A5FDD014BD42DB7B5B736C0C248422F37C46B930'


IP_ADDRESS = '127.0.0.1'


self.SOCKS_PORT = 9150


self.tor_config = {


'SocksPort': str(self.SOCKS_PORT),


'ControlPort': str(self.SOCKS_PORT + 1),


'HashedControlPassword': PASS_HASH,


'GeoIPFile': os.path.join(TOR_DIR, 'geoip'),


'GeoIPv6File': os.path.join(TOR_DIR, 'geoip6')


}


self.tor_path = os.path.join(TOR_DIR, 'tor')


# Setup proxy


socks.setdefaultproxy(socks.PROXY_TYPE_SOCKS5, IP_ADDRESS, self.SOCKS_PORT)


self.nonProxySocket = socket.socket


self.proxySocket = socks.socksocket


def main():


try:


network = Network()


network.init_tor('supersafe', network.print_bootstrap_lines)


url = 'http://checkip.amazonaws.com/'


headers = {'User-Agent': generate_user_agent()}


req = requests.get(url, headers=headers)


print(req.content)


network.switch_ip()


req = requests.get(url, headers=headers)


print(req.content)


finally:


network.kill_tor()


if __name__ == "__main__":


main()

P.S. извинения мои за то что спамлю в ленту по сути и вот почему

#comment_97100591

К сожалению, Ваш пост «Всё о парсинге сайтов на Python» удален. Причина: запрещено размещение поста, единственным содержанием которого является ссылка


А сейчас наверное из за игнора БМа пост удалят? нет?

Показать полностью 2 3
13

Будем поглядеть - расширение позволит запретить сбор личной информации для "Интернет-профиля".

Наткнулся вот на это:


Чтобы пользователи могли запретить Google Analytics собирать информацию о себе при посещении веб-сайтов, мы создали расширение для браузера, блокирующее скрипты Google Analytics (ga.js, analytics.js, dc.js).
https://chrome.google.com/webstore/detail/google-analytics-o...

Будем поглядеть - расширение позволит запретить сбор личной информации для "Интернет-профиля".

P.S. Чтобы большой брат не следил за нами!

2

Недавние события касающиеся ИБ на территории Казахстана. Хакеры атаковали сервера казахстанских банков.

Недавние события касающиеся ИБ на территории Казахстана. Хакеры атаковали сервера казахстанских банков.

С 27 сентября наблюдается повышенная активность хакеров на сервера ряда казахстанских банков, в том числе интернет-портал Homebank, сообщила пресс-служба Qazkom.


«Специалисты банка 27 сентября зафиксировали масштабную DDoS-атаку в виде ложных запросов одновременно с огромного числа IP-адресов, что блокируют работу портала», — говорится в сообщении банка.

В пресс-службе отметили, что для гарантированной защиты счетов клиентов специалисты банка предпринимает необходимые технические меры по нейтрализации действий хакеров.


«Приносим свои извинения, если будут наблюдаться задержки в проведении операций или сайт будет временно недоступен. Мы делаем всё возможное для нормализации работы Homebank и просим отнестись к этому с пониманием», — сообщает Qazkom.


В PR-службе Народного банка сообщили, что DDoS атаки не затронули их сервера и сервисы.


«Все системы и сервисы HalykBank работают в штатном режиме. Cпециалисты банка мониторят ситуацию и готовы оперативно предпринять меры по противодействию возможной атаке. Средства клиентов находятся в безопасности и проблем с проведением операций не наблюдается», — говорится в сообщении Народного банка.


В ближайшее время Informburo.kz ждёт ответа на запрос от Kaspi Bank.


Накануне в КНБ РК заявили, что банки скрывают информацию о хакерских атаках. В 2017 году шесть банков подверглись фишинговой атаке и только один из них обратился за помощью в КНБ.

https://informburo.kz/novosti/hakery-atakovali-servera-kazah...

P.S. КНБ РК=ФСБ РФ.

Показать полностью
89

Злоумышленники внедрили бэкдор в репозиторий Python

Злоумышленники загрузили вредоносные библиотеки, собиравшие информацию о пользователях.

Национальная служба безопасности Словакии (Národný bezpečnostný úrad, NBU) выявила в каталоге PyPI десять вредоносных библиотек Python. PyPI (Python Package Index) – официальный каталог стороннего ПО для языка программирования Python.


По словам специалистов из NBU, злоумышленники использовали метод, известный как тайпосковоттинг. Для загрузки библиотек использовались имена, похожие на имена легитимных пакетов, но с «опечаткой», например, «urlib» вместо «urllib».


Загрузить вредоносные модули в каталог не составило труда, поскольку PyPI не выполняет проверок безопасности при загрузке новых пакетов. Библиотеки содержали тот же код, что и легитимные аналоги, поэтому их функциональные возможности были одинаковы, но в скрипт установки setup.py был добавлен вредоносный код, пояснили эксперты.


Вредоносный код собирал информацию о зараженных хостах, в частности имя и версию фальшивого пакета, имя пользователя, установившего библиотеку, и имя компьютера. Собранные данные отправлялись на удаленный сервер в Китае (IP-адрес 121.42.217.44). Вредоносный код был обнаружен в следующих библиотеках: acqusition, apidev-coop, bzip, crypt, django-server, pwd, setup-tools, telnet, urlib3,urllib. По словам экспертов, вредоносные библиотеки были активны в период с июня по сентябрь 2017 года и использовались в нескольких пакетах программного обеспечения. Более подробную информацию можно найти в отчете NBU.


Представители NBU связались с администраторами PyPI и сообщили о проблеме. В настоящее время все вредоносные библиотеки удалены из каталога.


Подробнее: http://www.securitylab.ru/news/488533.php?R=1

Показать полностью 1

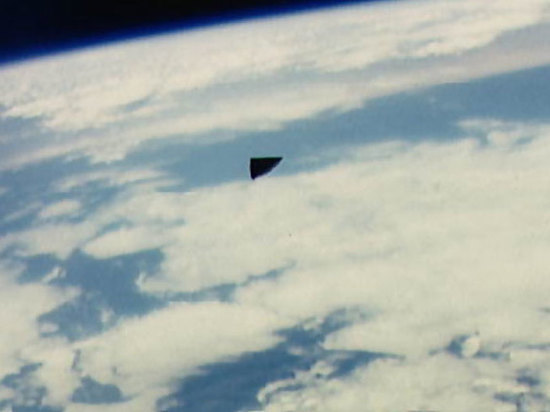
«НЛО» на орбитальных снимках NASA

Изучая снимки, сделанные астронавтом на орбите Земли, уфологи, по их собственным словам, заметили треугольный НЛО. По мнению самопровозглашенных специалистов, данный объект представляет собой космический корабль инопланетян. Как утверждается, два снимка, на которых оказался запечатлен гигантский звездолет, были сделаны астронавтом NASA еще 30 лет назад.


http://www.mk.ru/science/2017/09/11/ufologi-soobshhili-ob-v-...

Показать полностью 1
Отличная работа, все прочитано!

Темы

Политика

Теги

Популярные авторы

Сообщества

18+

Теги

Популярные авторы

Сообщества

Игры

Теги

Популярные авторы

Сообщества

Юмор

Теги

Популярные авторы

Сообщества

Отношения

Теги

Популярные авторы

Сообщества

Здоровье

Теги

Популярные авторы

Сообщества

Путешествия

Теги

Популярные авторы

Сообщества

Спорт

Теги

Популярные авторы

Сообщества

Хобби

Теги

Популярные авторы

Сообщества

Сервис

Теги

Популярные авторы

Сообщества

Природа

Теги

Популярные авторы

Сообщества

Бизнес

Теги

Популярные авторы

Сообщества

Транспорт

Теги

Популярные авторы

Сообщества

Общение

Теги

Популярные авторы

Сообщества

Юриспруденция

Теги

Популярные авторы

Сообщества

Наука

Теги

Популярные авторы

Сообщества

IT

Теги

Популярные авторы

Сообщества

Животные

Теги

Популярные авторы

Сообщества

Кино и сериалы

Теги

Популярные авторы

Сообщества

Экономика

Теги

Популярные авторы

Сообщества

Кулинария

Теги

Популярные авторы

Сообщества

История

Теги

Популярные авторы

Сообщества

Недвижимость и ремонт

Теги

Популярные авторы

Сообщества