
Ч.4 Я снова сделал систему распознавания номеров. Как работает детектор
Привет!
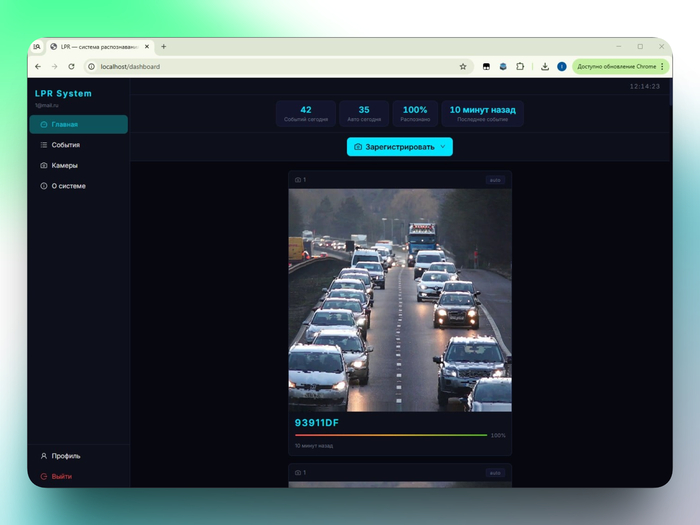
В прошлой статье я показал что получилось в итоге — интерфейс, архитектуру, как это работает. Сегодня расскажу про самую интересную часть проекта — детектор. Как я к нему пришёл, с какими проблемами столкнулся и почему он в итоге работает именно так. К сожалению, этапы разработки пришлось восстанавливать по памяти т.к я не вел заметок в процессе. Постараюсь сохранить баланс между скучной техничкой и понятным языком для нормальных людей)
Спойлер: я изобрел велосипед, но сам!
Спойлер 2: Система еще на этапе разработки, пока только делюсь с вами процессом.
Как это всё начиналось — версия 2022 года
Моя первая система распознавания номеров работала по совершенно другому принципу. Камера сама должна была поймать момент — по детекции движения, по пересечению линии, по любому встроенному триггеру — и отправить готовый кадр в систему, например по FTP. Система видела новый файл и пыталась найти на нём номер.
В целом выглядит логично. На практике — куча ограничений:
Не каждая камера умеет автоматически определять транспортное средство из коробки. Настройка FTP на камере c кривой прошивкой — это отдельный квест.
У серьёзных брендов всё это есть, но мой проект был рассчитан на сегмент попроще, где камера с AliExpress. С непонятной прошивкой)
Там никакого FTP нет а если есть, работает по настроению. Кстати у меня как раз такая камера)
Плюс качество кадра по триггеру — это лотерея. Моя камера срабатывала когда хотела, номер мог быть размытым, обрезанным, или вообще не попасть в кадр. Иногда она просто отправляла мне пустой кадр, хотя триггер стоял на автомобиль в кадре.
Недавно я решил переделать всё с нуля, первое решение было очевидным: система должна сама анализировать RTSP-поток. Подключил камеру — и забыл. Никаких FTP, никаких триггеров на стороне камеры, никаких танцев с бубном при настройке.
Так я пришёл к связке YOLOv8 + ByteTrack + OCR для номеров. YOLOv8 находит автомобили в кадре, ByteTrack следит за каждым из них как за отдельным объектом, OCR(оптическое распознавание символов c кадра) читает номер.
Архитектуру я продумал заранее. А вот с реализацией — всё оказалось сложнее, чем казалось.
Первый запуск. Первое видео
У меня не было реального RTSP-потока для тестов. Пришлось скачивать видео с YouTube — записи с трасс, парковок, перекрёстков. Качество разное, углы обзора разные, трафик машин разный.
Я не стал хвататься за всё сразу. Решил начать с того что казалось самым сложным — видео с трассы. Камера специально установлена для фиксации номеров, машины едут под одним углом, номер всегда в кадре, никаких засветок. Идеально сложные условия, как мне тогда казалось. Отрезок на распознавание небольшой, скорость у машин высокая.
Запустил. В логах поплыли результаты распознавания. "УРА!" — подумал я. Проект закончен, я молодец.
Потом открыл папку с сохранёнными кадрами...
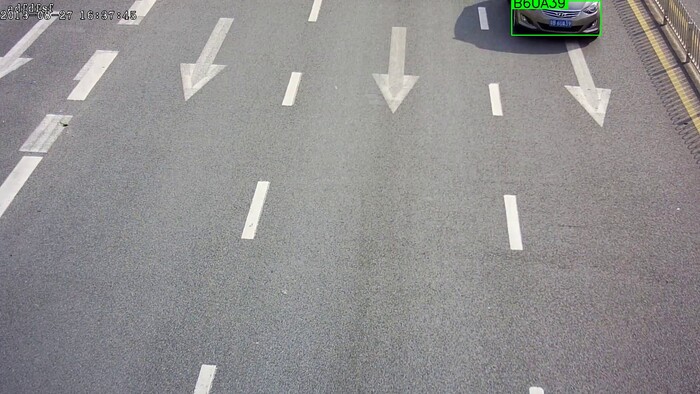
кадр где видно только бампер въезжающей машины
Система радостно фиксировала каждую машину в момент когда та только появлялась в кадре. На фото — наверное 20% автомобиля, остальное за краем экрана. Я-то понимаю что это машина и что она сейчас въедет полностью, и можно поймать более удачный кадр. Система — нет. Только увидела авто — сохранила.
Проблема первая: кадр слишком ранний
Решение: не сохранять сразу. Вместо этого — собрать несколько кадров пока машина в кадре, дождаться пока она уедет, и только потом выбрать лучший.
Но какой кадр лучший? Первое что пришло в голову — тот где машина занимает наибольшую площадь в кадре. Больше площадь — машина ближе, номер крупнее, читать легче.
Так появилась первая переменная в коде:
BEST_FRAME_WINDOW — сколько кадров собрать для анализа
Стало лучше. Но не идеально. Машина "максимально" в кадре, но номер плохо читаемый, вот бы захватить кадр чуть-чуть раньше....
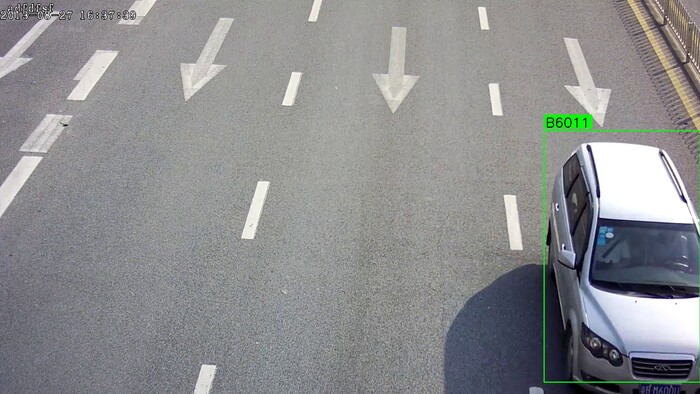
Проблема вторая: кадр большой, но неудачный
Площадь площадью, а номер всё равно иногда не читался. Начал анализировать — оказалось что "лучший по площади" кадр не всегда лучший для распознавания. Машина могла быть крупной, но смазанной из-за движения. Или у меня сыпался тестовый поток (эмуляция RTSP через видеофайл — та ещё история) и система радостно сохраняла артефактный кадр.
Тут я вспомнил что OCR-движок вместе с результатом отдаёт уверенность — число в диапазоне от 0 до 1 насколько он сам уверен в своём ответе.
Теперь правлю логику: если система несколько раз попробовала распознать номер(помним про BEST_FRAME_WINDOW ) и получила результаты с разной уверенностью — берём тот где уверенность выше.
Теперь логика выбора кадра стала такой: не просто "наибольшая площадь", а "наибольшая уверенность OCR". Если OCR вообще не сработал ни на одном кадре — тогда fallback на наибольшую площадь.
Появилась ещё одна переменная:
RECOGNIZE_INTERVAL — OCR запускается раз в N кадров
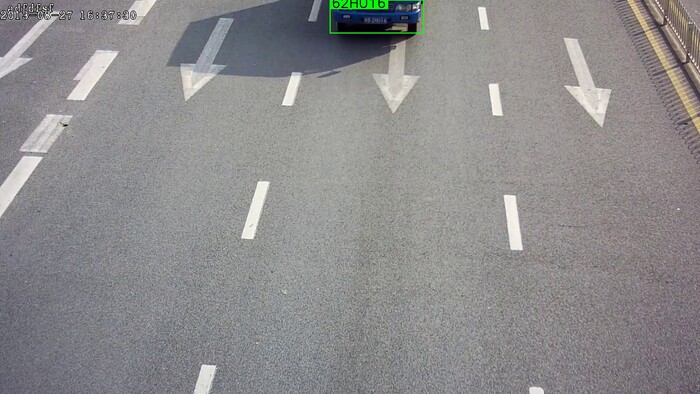
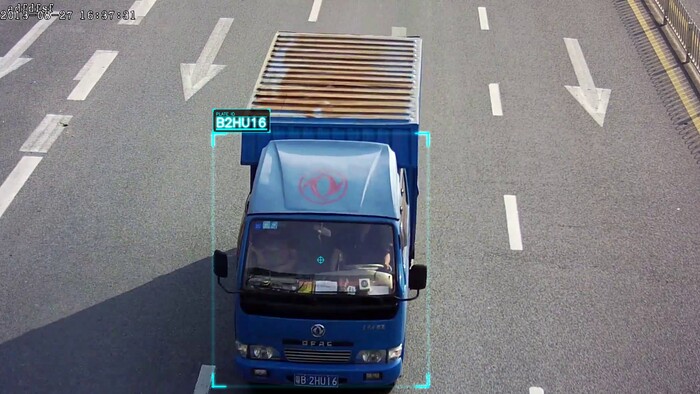
система делает несколько снимков одного ТС и в данному примере выберет второй кадр из карусели.
Парковка и пробка — где всё сломалось и перестало работать
Трасса оказалась самым простым случаем. Машины едут быстро, в кадре недолго, в кадре одновременно 2-3 штуки максимум. Номер всегда видно.
Настоящий ад начался когда я взял видео с парковки.
Парковка: машина стоит и это проблема
Попробуйте угадать что произошло. Подсказка: машина стоит на парковке и никуда не едет.
Правильно — система начала генерировать события на одно и то же стоящее авто каждые несколько секунд. Стоит машина час — получите пару сотен событий на один и тот же номер. Стоит сутки — ну вы поняли...
Решение: кулдаун. После того как событие зафиксировано, на этом номере N секунд тишины.
COOLDOWN_SECONDS — пауза между повторными записями одного и того же номера
Особенно актуально для пробок и перекрёстков — там машина может стоять в кадре несколько минут, медленно ехать, снова стоять и так далее.
Пробка: всё сложно одновременно
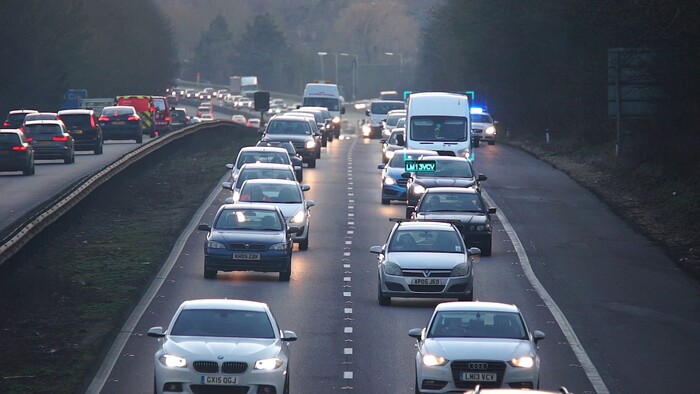
Видео с пробкой стало главным экзаменом. Несколько полос, машины едут медленно, некоторые стоят, номер то видно то не видно — водитель прижался к переднему авто и номер перекрыт на всё время пока машина в кадре.
И главная проблема с которой я столкнулся сразу: когда две машины в кадре одновременно, распознавался только один номер.
Здесь я уже понимал что переменные в логике детектора копятся, значения для каждого видео приходится подбирать вручную методом проб и ошибок.: один универсальный режим работы детектора не подходит для разных сценариев. Нужны два глобальных режима.
Режимы: single и multi
Single — для сценариев где в кадре одна машина: ворота, въезд, автосервис. Меньше нагрузка на систему, логика проще.
Multi — для потока: дорога, парковка, пробка. Здесь будет задействован ByteTrack — каждой машине присваивается уникальный ID и система следит за каждым авто независимо.
Добавляю очередные параметры в систему:
DETECTION_MODE — single или multi
DISAPPEAR_FRAMES — сколько кадров машина должна отсутствовать чтобы считаться уехавшей из кадра и начать распознавание.
В multi-режиме каждая машина живёт в своём "треке" — система помнит её историю, лучший кадр, лучший результат OCR, и ждёт финала когда машина уедет.
Триггерная зона: подсказываем системе где смотреть
Работая с тестовыми видео я заметил закономерность: номер у машины становится хорошо виден примерно в одной и той же области кадра. Зависит от угла установки камеры, но зону как правило можно определить.
Незачем гонять OCR на весь кадр всё время. Можно заранее сказать системе: "смотри только вот в этой области". Если машина туда ещё не въехала или уже выехала — OCR не запускаем.
Новые параметры:
TRIGGER_ZONE_TOP — верхняя граница зоны (доля высоты кадра, 0.0–1.0)
TRIGGER_ZONE_BOTTOM — нижняя граница зоны
Так я получил двойной эффект: меньше нагрузка на процессор и меньше шансов поймать неудачный кадр — система как бы заранее знает где будет лучший ракурс.
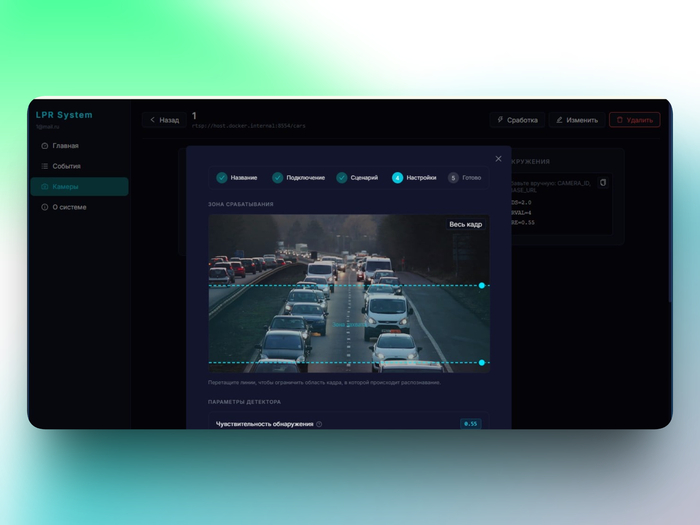
интерфейс выбора зоны распознавания
Streak и ранее сохранение: не ждём вечно
Ещё одна история из пробки. Система честно ждала пока машина уедет из кадра, и только потом финализировала событие. Логика правильная — но на практике машина в пробке в кадре может ехать три минуты или десят. Все это время ждать результата?
Решение: если система несколько раз подряд распознала у конкретной машины одинаковый номер — считаем что мы уже знаем ответ, и незачем ждать пока машина уедет. Сохраняем сразу.
Пример: машина едет в пробке, номер периодически появляется в зоне. Система пытается его прочитать каждые несколько кадров и получает вот такую картину:
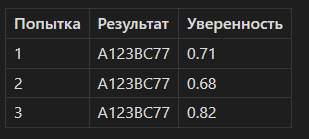
Несколько раз подряд один и тот же номер — streak набран. Система не ждёт пока машина уедет за кадр, она уже уверена в ответе. Событие сохраняется прямо сейчас, с кадра №3 где уверенность максимальная.
А вот другой сценарий — номер то появляется, то перекрывается соседним авто:
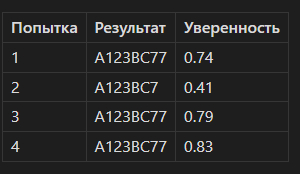
На второй попытке номер считался неполностью — streak сбросился. Счётчик начинается заново с попытки №3. На попытке №4 снова два совпадения подряд — сохраняем событие
Это называется streak — серия одинаковых результатов подряд. Набрали нужное количество совпадений, достигли нужного уровня уверенности — "отпускаем" машину не дожидаясь её физического ухода из кадра.
Новая переменная:
PLATE_CONFIRM_COUNT — сколько одинаковых OCR-результатов подряд нужно
для уверенного распознавания
Пресеты: чтобы не настраивать каждый раз вручную
В процессе разработки я постоянно переключался между разными тестовыми видео — трасса, парковка, пробка, ворота. У каждого сценария свои оптимальные настройки.
Трасса — машины быстрые, нужен маленький DISAPPEAR_FRAMES.
Ворота — одна медленная машина, совсем другая логика.
Чтобы не перебивать переменные каждый раз вручную, я составил базовые наборы настроек под каждый сценарий. Так появились пресеты.
В интерфейсе это выглядит так — при добавлении камеры выбираешь шаблон и получаешь готовый набор настроек. Потом можно докрутить вручную если нужно.
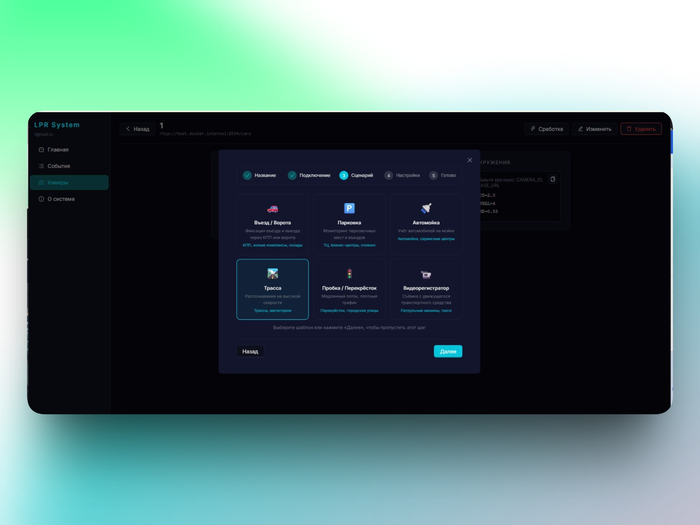
Пример выбора пресета
Схема логики детектора
Чтобы было понятнее как всё это работает вместе — вот упрощённая схема.
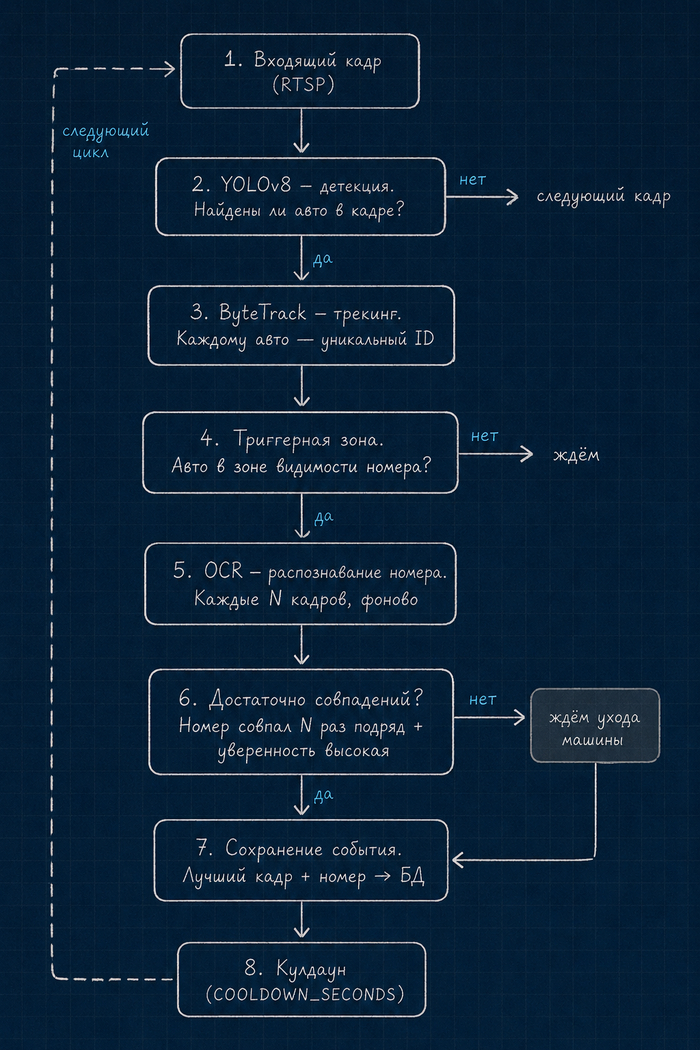
Некоторые детали реализации я намеренно оставляю за кадром — возможно из этого получится коммерческий проект, и полная инструкция по сборке в статье ни к чему :)
Конечно, система сложнее, я описал только основные моменты логики и проблемы с которыми столкнулся.
Что в итоге
Я не смог найти подробных примеров того, как работают такие системы и придумал свой велосипед. Уверен, что можно лучше и знаю что в комментариях вы мне подскажете что поправить.
Детектор прошёл долгий путь от глупого бесконечного поиска номеров в каждом кадре до системы с трекингом, фоновым OCR, триггерными зонами и автоматическим выбором лучшего момента для сохранения.
Каждая переменная — это конкретная проблема которую я встретил в ходе разработки. Не наугад , а именно: "вот кривое распознавание, вот так можно починить, вот ручка/переменная чтобы можно было отрегулировать".


